Blue-green и canary под нагрузкой: что ломается первым
Blue-green переключает трафик между двумя версиями целиком, canary — постепенно. Но под нагрузкой первой может отказать не новая версия, а база, балансировщик или сама схема измерения ошибок. Разбираем, где искать слабое место.
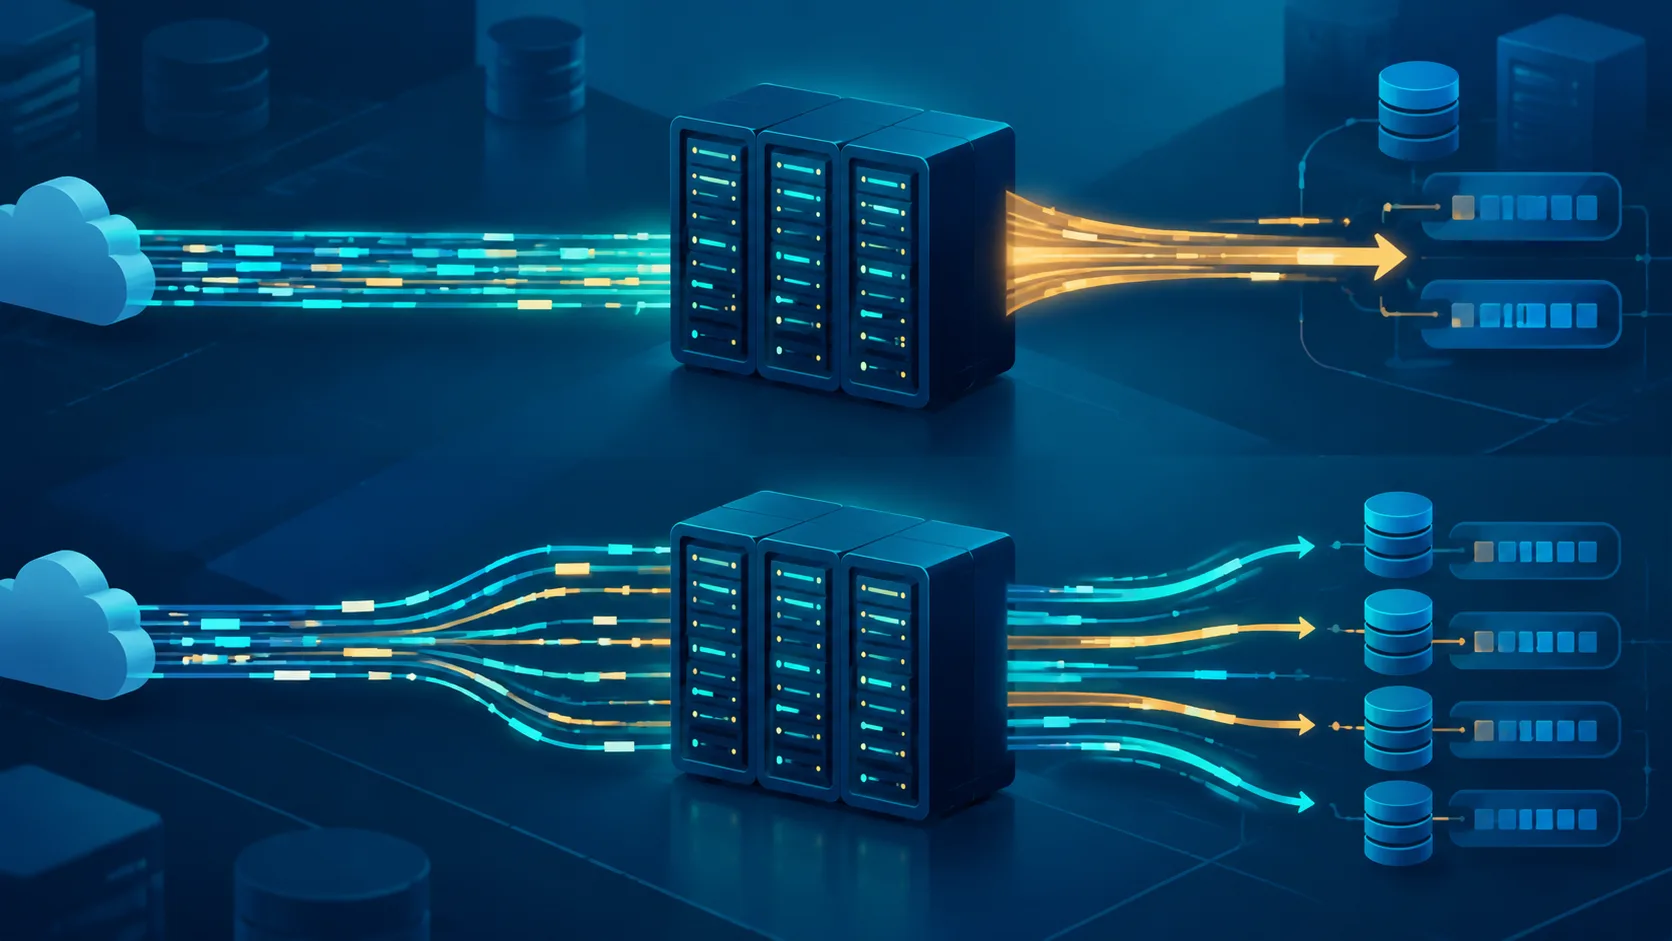
При blue-green релиз может пройти проверку на новой среде и всё равно уронить сервис в момент переключения: к новой версии одновременно приходит весь трафик, а база получает всплеск запросов. Canary снижает резкость перехода, но не спасает, если метрики запаздывают или ошибка возникает только при высокой параллельности. Ни одна схема не делает релиз безопасным сама по себе: решает то, что именно вы проверяете и как быстро можете остановить продвижение.
Две схемы — два разных риска
В blue-green вы держите две среды: текущую, условно blue, и подготовленную green. Новую версию разворачивают на green, проверяют, затем направляют туда трафик. При проблеме трафик можно вернуть на blue — если старая среда ещё работоспособна, а изменения данных совместимы.
В canary новую версию сначала получает только часть пользователей или запросов. Долю увеличивают по этапам, наблюдая за ошибками и задержками. Это не обязательно равное случайное деление: маршрутизация может зависеть от пользователя, заголовка, региона или возможностей балансировщика.
Для разбора ниже рассматривается приложение за балансировщиком и общая база данных, без привязки к конкретному контроллеру деплоя. Архитектурные принципы одинаковы для Kubernetes 1.30 и других платформ, но поведение конкретных контроллеров, ingress и service mesh сверяйте с документацией своей версии.
Blue-green уменьшает время переключения, но не цену ошибки. Canary уменьшает масштаб первой ошибки, но требует сигналов, которым можно доверять.
Что ломается первым под нагрузкой
Blue-green: вся нагрузка приходит разом
Самый резкий тест для green — не проверка готовности, а момент, когда туда переводят почти весь рабочий трафик. Процессы могут быть запущены, а кэши пусты; пулы соединений ещё не прогреты; фоновые задачи одновременно подхватывают очередь. Если ресурсы green рассчитаны на меньшую нагрузку, чем текущий поток, растут задержки и тайм-ауты. «Зелёный» цвет показывает состояние релиза, а не запас пропускной способности.
Вторая точка отказа — общая база. Обе среды могут одновременно читать и писать в неё. Новая версия способна генерировать больше запросов, изменить их форму или создать нагрузку при заполнении кэша. Само наличие отдельного набора серверов приложения не изолирует базу от перехода.
Третий риск — откат, который существует только на схеме. Если новая версия уже записала данные в формате, непонятном старой, переключение обратно на blue восстановит старый код, но не прежнее состояние данных. Такой откат может превратиться в отдельный инцидент.
Canary: ошибка теряется в малой доле трафика
При небольшом проценте новой версии абсолютное число ошибок тоже может быть небольшим. Если мониторинг показывает только общее число сбоев по сервису, ухудшение canary растворится в здоровом трафике старой версии. Нужны метрики с разрезом по версии и достаточно запросов в каждой группе, чтобы сравнение имело смысл.
Canary также может не встретить нужный сценарий. Пользовательские сессии, крупные заказы, редкие регионы или отдельные типы запросов не обязательно попадут в малую выборку. А если трафик закрепляют за пользователем, отдельный пользователь может долго оставаться на одной версии: это помогает последовательности запросов, но замедляет обнаружение проблем на конкретном сегменте.
Наконец, постепенное повышение доли не всегда означает постепенный рост нагрузки на каждый компонент. Общая база, очередь или внешний API могут получить дополнительную работу уже на первой ступени. Канареечный процент описывает маршрутизацию, а не гарантированный процент нагрузки на каждую зависимость.
Сравнение под нагрузкой
| Критерий | Blue-green | Canary |
|---|---|---|
| Первая нагрузка на новую версию | Резкий перевод основной доли трафика | Постепенное увеличение доли |
| Что проще заметить | Общий провал после переключения, если метрики оперативны | Разницу между версиями при достаточном объёме и корректных метках |
| Главная цена | Нужно держать вторую среду и учитывать совместимость данных | Нужно управлять маршрутизацией и анализировать малые выборки |
| Типичная слепая зона | Пиковая нагрузка на green и общие зависимости | Редкие сценарии, скрытые агрегированными метриками |
| Откат | Быстрый только при живой старой среде и совместимых данных | Остановка продвижения не отменяет уже выполненные записи и побочные действия |
Как проверить схему, а не только релиз
Не объявляйте деплой безопасным по одной проверке доступности. Сначала определите условия остановки: какие показатели должны оставаться в пределах нормы, сколько времени длится наблюдение и кто принимает решение. Пороговые значения берите из SLO и обычного поведения вашего сервиса, а не из универсального шаблона: без данных о нагрузке честной «нормальной цифры» нет.
- Разделите метрики по версиям. Сравнивайте долю ошибок, задержки и насыщение ресурсов для старого и нового релиза. Проверьте, что метки не теряются на балансировщике и в телеметрии.
- Наблюдайте за зависимостями. Отдельно смотрите на базу, очередь и внешние сервисы. Увеличение времени ответа приложения может быть следствием очереди соединений или лимита зависимости, а не дефекта кода.
- Проверьте профиль нагрузки. Используйте репрезентативные сценарии, включая тяжёлые запросы и параллельное выполнение. Запускать такой тест на продуктивных пользователях без согласованного плана нельзя.
- Проверьте возврат. Убедитесь, что старая версия способна работать с уже записанными данными и что переключение действительно меняет маршрут трафика, а не только статус релиза.
- Зафиксируйте владельца решения. Должно быть понятно, кто останавливает продвижение и кто проверяет восстановление. Автоматическая остановка полезна только тогда, когда её сигнал не шумит и не опаздывает.
Чтобы сравнение было содержательным, записывайте условия каждого релиза: версию приложения и контроллера, объём и тип трафика, длительность этапа, число запросов на версии, настройки маршрутизации и состояние зависимостей. Без этого «после стало хуже» не объясняет, что изменилось. Если достоверных замеров пока нет, начните с базовой линии на обычном трафике и нагрузочного теста в изолированной среде; не подставляйте вымышленные значения задержки или процента ошибок.
Где обе схемы ломаются
- Несовместимые изменения схемы данных. Новая версия удаляет или меняет поле, которое ещё читает старая. Возврат к старому коду после этого не возвращает совместимость. Разделяйте изменение на совместимые этапы: сначала поддержка старого и нового формата, затем переключение записи, и только после проверки — удаление прежнего.
- Общие побочные эффекты. Обе версии могут отправлять письма, списывать оплату или запускать обработчики очереди. Переключение трафика не отменяет уже отправленное действие. Проверьте идемпотентность операций и владение фоновой обработкой.
- Неполная изоляция. Две версии приложения не дают двух независимых систем, если они делят базу, лимит внешнего API или очередь. Следите за общей ёмкостью, иначе локально успешная проверка закончится перегрузкой зависимости.
- Ложная уверенность в автоматике. Canary-автоматизация может не остановить релиз, если у неё нет метрик по версиям, а blue-green не гарантирует откат, если старая среда уже выключена или несовместима с данными.
Отдельная тема — проектирование миграций и откат изменений данных; здесь важен только вывод: схему маршрутизации нужно проверять вместе с планом работы с состоянием.
Что выбрать и что измерить дальше
Blue-green подходит, когда вы можете содержать две среды, быстро перевести трафик и заранее доказали совместимость данных при возврате. Canary уместен, когда вы умеете маршрутизировать часть запросов, различать версии в метриках и выдерживать период наблюдения. Если нет ни надёжного разреза метрик, ни проверенного отката, смена названия стратегии проблему не решит.
Следующий практический шаг — провести репетицию на тестовом релизе: зафиксировать базовые показатели, проверить переход трафика, остановку продвижения и возврат. В продуктиве следите не только за кодом ответа, но и за задержками по версиям, насыщением базы и очередей, числом запросов в каждой группе и результатом фоновых операций. Именно эти сигналы покажут, что сломалось первым, а не просто подтвердят, что релиз закончился.
Сноска. SLO — целевой уровень надёжности сервиса, выраженный через измеримые показатели, например долю успешных запросов или задержку. Он задаёт основу для порогов остановки релиза, но сам по себе не гарантирует, что выбранные метрики отражают все пользовательские сценарии.
Генератор изображений: Иллюстрация, обложка, баннер, схема — по текстовому описанию, без исходного фото.
Спросить за 20 ₽Источники: Argo Rollouts: BlueGreen, Argo Rollouts: Canary
Частые вопросы
Что безопаснее под нагрузкой: blue-green или canary?
Можно ли откатиться на старую версию после переключения?
Какой процент трафика дать canary?
Почему canary не обнаружил ошибку до полного релиза?
Можно ли использовать обе стратегии вместе?
Как понять, что именно ограничивает релиз?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.