Декомпозиция задач под нагрузкой: что ломается первым
Разбиение большой операции на сервисы, очереди и параллельные шаги ускоряет разработку, но под нагрузкой часто превращает один сбой в каскад. Разбираем, как декомпозировать задачу так, чтобы система сохраняла управляемость.
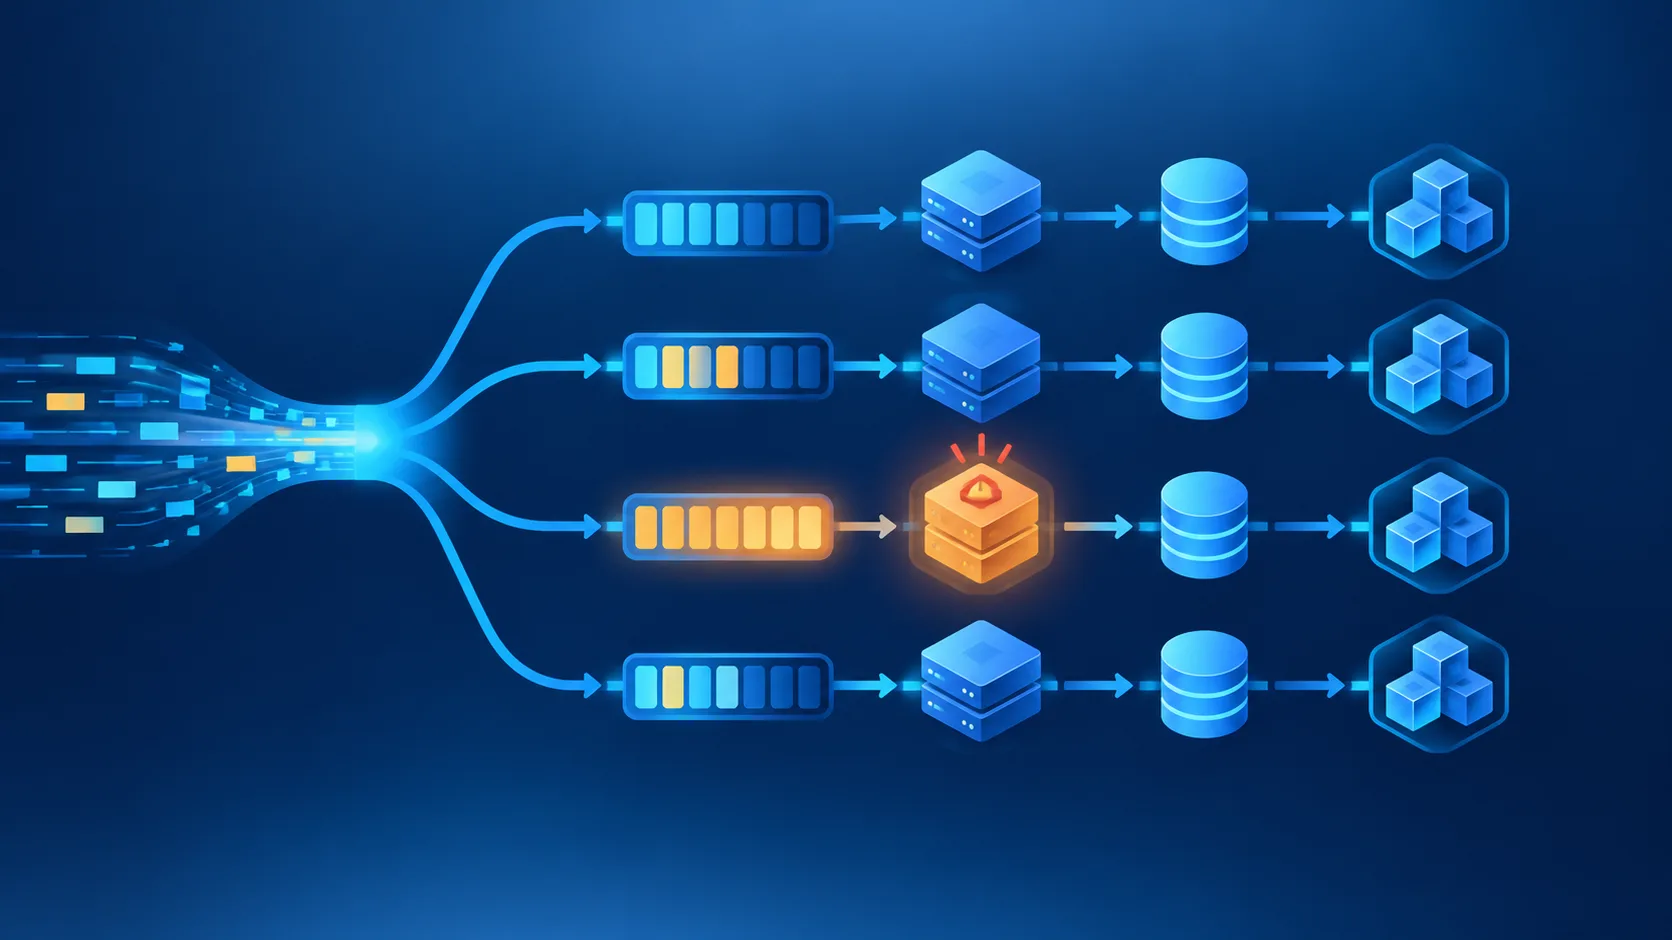
Система редко падает из-за самой большой функции. Обычно первой заканчивается емкость общего ресурса: соединения с базой, пул потоков, очередь сообщений или лимит внешнего API. Плохая декомпозиция лишь ускоряет этот момент: один пользовательский запрос превращается в десятки внутренних вызовов, а повторная попытка умножает нагрузку. Ниже — практический разбор того, как делить операцию на шаги, где ставить границы и что измерять до выхода в продакшен.
Сначала отделите задачу от запроса
Самая частая ошибка — считать единицей декомпозиции HTTP-метод. Например, запрос «создать заказ» начинает синхронно резервировать товар, рассчитывать доставку, списывать деньги, отправлять письмо и обновлять аналитику. Пока трафик мал, такой код выглядит простым. Под нагрузкой каждый медленный внешний вызов удерживает HTTP-воркер, а его таймаут оставляет часть операций в неопределенном состоянии.
Полезнее разделить операцию на две части:
- критический путь — то, без чего нельзя подтвердить результат пользователю;
- побочные действия — уведомления, экспорт, пересчет отчетов, запись событий в аналитическую систему.
Критический путь должен быть коротким и ограниченным по числу зависимостей. Побочные действия можно передать в очередь, выполнить позже и повторить отдельно. Это не означает, что каждую функцию нужно превращать в отдельный сервис. Граница должна появляться там, где меняются требования к надежности, времени выполнения или масштабированию.
Хорошая декомпозиция не убирает нагрузку. Она не дает медленной части незаметно занять ресурсы быстрой.
Как разложить операцию на управляемые шаги
1. Зафиксируйте результат и побочные эффекты
Запишите, что система обязана вернуть клиенту, а что может произойти после ответа. Для заказа это может быть создание записи и резервирование товара в критическом пути, а письмо и отправка события в аналитику — после него.
Для каждого шага укажите владельца данных, максимальное время ожидания, допустимое число повторов и последствия повторного запуска. Если эти параметры неизвестны, задача еще не готова к разделению.
2. Нарисуйте граф зависимостей
Не ограничивайтесь списком функций. Покажите порядок вызовов: какие шаги идут последовательно, какие можно выполнять параллельно, а какие требуют результата предыдущего шага. Отдельно отметьте общие ресурсы — одну базу, общий пул соединений, кэш и внешний API.
Параллельный запуск сокращает время одного запроса, но увеличивает пиковое число обращений. Если один входной запрос запускает восемь операций, то при 100 одновременных запросах downstream-система может получить до 800 обращений в коротком интервале. Это не замер производительности, а верхняя граница для оценки fan-out*.
3. Разделите синхронные и асинхронные границы
Синхронным оставляйте только то, что нужно для корректного ответа. Асинхронная часть должна иметь очередь, ограничение скорости обработки, повторные попытки и место для неуспешных сообщений. Без этих механизмов очередь становится не разгрузкой, а складом необработанных проблем.
Событие или задание должно содержать идентификатор операции, версию схемы и данные, достаточные для обработки. Не заставляйте потребителя каждый раз собирать контекст из пяти таблиц, если это создает дополнительную нагрузку на основную базу.
4. Сделайте повтор безопасным
Таймаут не говорит, выполнилась операция или нет. Клиент, прокси или воркер может повторить запрос, пока первый вызов еще выполняется. Поэтому запись платежа, резервирование товара и создание задания должны иметь идемпотентный ключ или другой способ распознать повтор.
Идемпотентность означает, что повтор одного и того же запроса не создает новый побочный эффект. Это не равно «операцию можно повторять бесконечно»: повтор все равно должен быть ограничен политикой и контролироваться по журналам.
Что ломается первым
Общий пул соединений
При декомпозиции число компонентов растет, но пул соединений к базе часто остается общим узким местом. Каждый воркер держит соединение дольше из-за внешнего вызова или тяжелого запроса. В результате новые запросы ждут свободное соединение, хотя процессор еще не загружен.
Смотрите не только на количество ошибок базы. Нужны время ожидания соединения, занятость пула, длительность транзакций и число активных запросов. Если растет именно ожидание пула, добавление HTTP-воркеров проблему усилит.
Очередь и повторные попытки
Когда downstream-сервис отвечает медленно, очередь начинает расти. Затем потребитель получает таймаут, повторяет сообщение, а объем работы увеличивается еще сильнее. Особенно опасны независимые повторы на каждом уровне: клиент повторяет запрос, API-шлюз повторяет его, сервис повторяет вызов, а обработчик повторяет задание.
У повтора должны быть общий бюджет, задержка между попытками и случайное расхождение времени запуска. Иначе несколько тысяч одинаковых задач снова придут к отказавшему компоненту одновременно.
Согласованность данных
Одна транзакция базы может атомарно изменить несколько таблиц, но не гарантирует, что следующее событие успешно дойдет до брокера. Если запись в базе и публикация события разделены, возможен разрыв: заказ уже создан, а потребитель об этом не знает.
Для такого сценария применяют паттерн outbox: событие записывается в таблицу в той же транзакции, что и бизнес-изменение, а отдельный процесс публикует его в брокер. Это добавляет таблицу, фоновый обработчик и контроль повторной публикации, зато делает потерю события обнаруживаемой.
Наблюдаемость
После разделения один пользовательский запрос может пройти через несколько процессов. Если у них нет общего идентификатора трассировки, расследование превращается в поиск совпадающих временных меток. Логи каждого шага должны связываться по идентификатору операции, а метрики — показывать отдельно время ожидания, обработки и повторов.
Три подхода и их цена
| Подход | Когда подходит | Что выигрываете | Чем платите |
|---|---|---|---|
| Одна синхронная операция | Короткий критический путь, мало зависимостей | Простая отладка и понятный результат | Медленный компонент блокирует весь запрос |
| Синхронный путь плюс очередь | Есть побочные действия с разным SLA | Независимое масштабирование и повторная обработка | Появляются задержка, дубликаты и необходимость следить за очередью |
| Несколько сервисов и событий | Компоненты имеют разные команды, данные и профили нагрузки | Изоляция отказов и отдельное масштабирование | Сложнее контракты, трассировка и согласованность |
| Параллельные вызовы в одном запросе | Шаги независимы, а ответ нужен сразу | Меньше суммарное время ожидания | Растет fan-out и пиковая нагрузка на зависимости |
Как измерять до и после
Сравнивать нужно не только среднее время ответа. Среднее скрывает редкие, но болезненные задержки. Зафиксируйте условия теста: объем данных, число параллельных запросов, лимиты пулов, размер сообщений и версии компонентов. Затем соберите:
- p50, p95 и p99 для полного запроса;
- время каждого внутреннего шага и ожидания соединения;
- число вызовов downstream на один входной запрос;
- глубину очереди и возраст самого старого сообщения;
- долю повторов, таймаутов и сообщений, отправленных в dead-letter queue;
- нагрузку на CPU, память, базу данных и внешние лимиты.
Тестируйте не только успешный сценарий. Остановите один потребитель, замедлите внешний API, заполните пул базы и проверьте, ограничивается ли ущерб. Если после отключения одного компонента растет число запросов к нему, а не уменьшается, в системе работает опасный цикл повторов.
Где декомпозиция ломается
Слишком мелкие шаги. Каждый новый сетевой вызов добавляет задержку, сериализацию, таймаут и точку отказа. Выигрыш от независимого масштабирования должен быть измеримым, иначе дробление только усложняет систему.
Общий источник истины без владельца. Несколько сервисов напрямую пишут в одни таблицы, и изменение схемы одного сервиса ломает другой. Выберите владельца данных и оформите контракт чтения или события.
Бесконечная очередь. Если производитель стабильно создает работу быстрее потребителя, очередь не «рассосется» сама. Нужны ограничение входного потока, отбрасывание необязательной работы или временное снижение функциональности.
Отсутствие дедупликации. Повторное сообщение создает повторный платеж, дубль письма или второе резервирование. Обработка должна признавать повтор нормальным сценарием, а не исключением.
Что делать дальше
Возьмите одну медленную операцию и составьте для нее карту: критический путь, побочные действия, зависимости, общий ресурс и политика повторов. Затем проведите нагрузочный тест с отказом одного downstream-компонента. Первым делом смотрите на p99, ожидание пулов, глубину очереди и количество внутренних вызовов на один запрос.
Если система уже использует события, отдельно проверьте схему outbox, дедупликацию и срок хранения неуспешных сообщений. Инвалидация кэша и выбор конкретного брокера — отдельные темы; здесь важнее границы работы и цена отказа.
Сноска. Fan-out — количество внутренних вызовов, которое порождает одна входная операция. При значении 1 запрос к API может превращаться в десятки обращений к базам и сервисам.
Задачи: математика, физика, химия: Разбор задачи по шагам с проверкой и похожей задачей
Спросить за 10 ₽Источники: Timeouts, retries, and backoff with jitter — AWS Builders’ Library, Addressing Cascading Failures — Google SRE
Частые вопросы
Нужно ли выносить каждую функцию в отдельный микросервис?
Что делать, если я не успеваю обработать очередь?
Как понять, что повторный запрос создает дубликат?
Подход изменится, если у меня другая версия базы, брокера или фреймворка?
Что проверить в продакшене после разделения операции?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.