Graceful degradation: как сервису пережить отказ зависимости
Если сервис ждёт базу данных или внешний API, их отказ может остановить и функции, которые от них не зависят. Разбираем, как ограничить ущерб, что измерять и почему деградация без чётких границ превращается в тихую порчу данных.
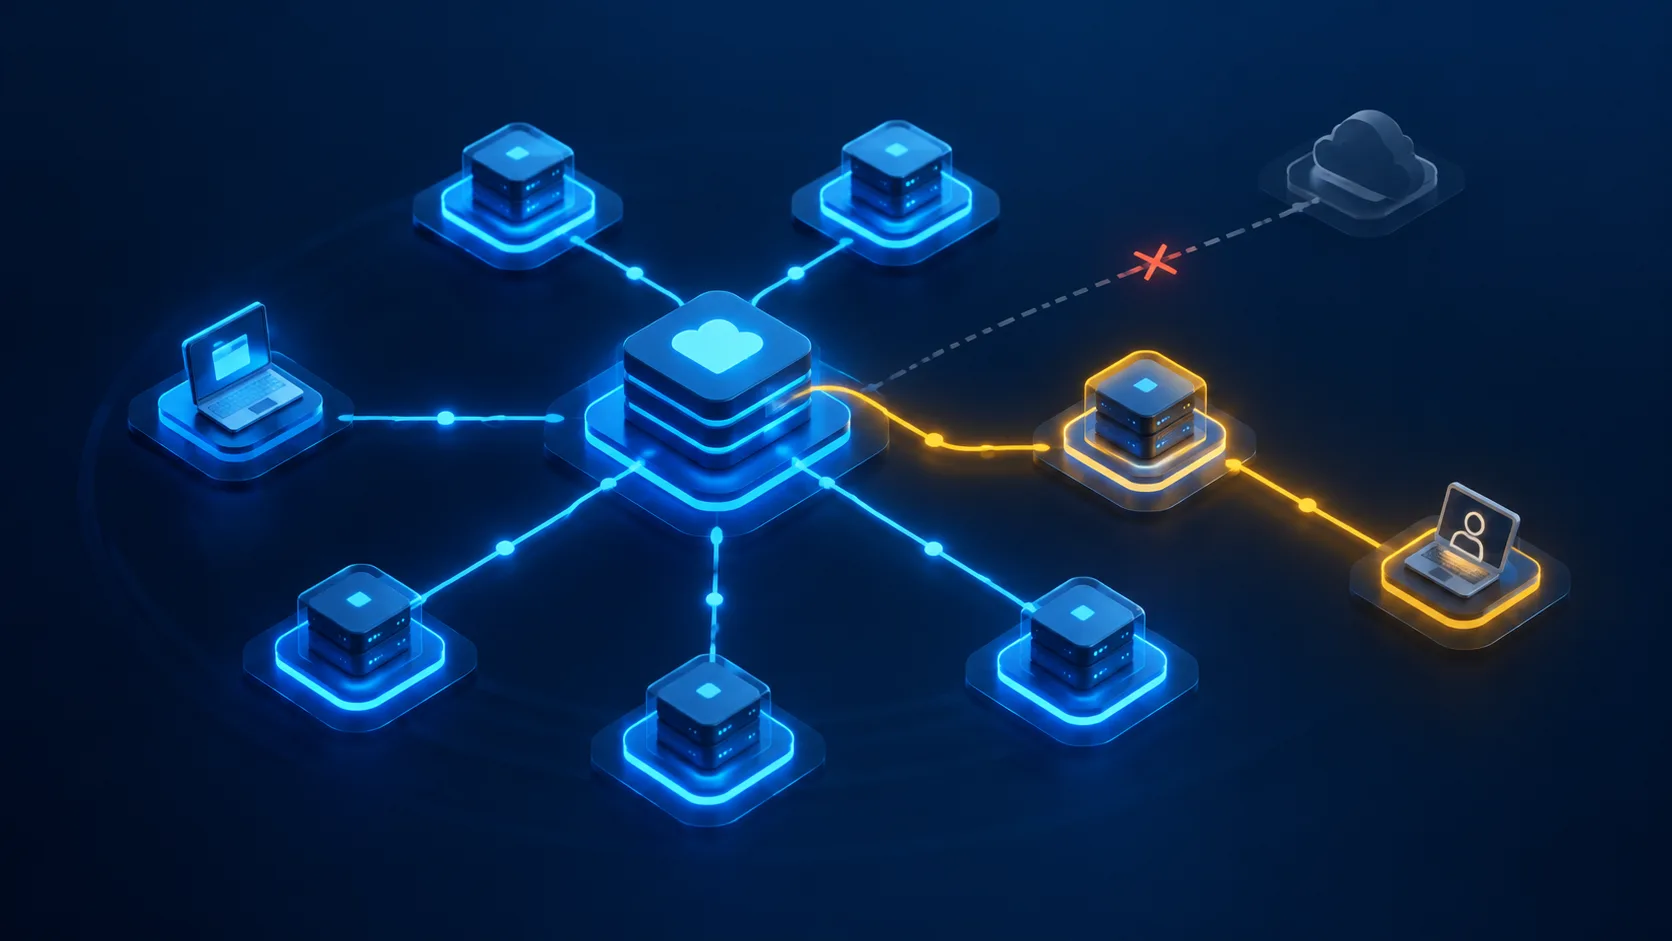
Когда внешний API замедляется, запросы к нему занимают рабочие потоки, очередь растёт, а вслед за ней перестают отвечать и функции, которым этот API не нужен. Graceful degradation помогает сохранить доступность основной части сервиса, отключив или упростив второстепенную. Но у такого решения есть цена: пользователи могут увидеть неполные данные, устаревший результат или временно недоступную функцию.
Деградация — не просто сообщение об ошибке
Сервис деградирует управляемо, если заранее определено, что он продолжит делать при сбое компонента, что перестанет делать и как вернётся к нормальной работе. Например, интернет-магазин может показывать карточки товаров из кеша, даже когда сервис рекомендаций недоступен. Это лучше, чем не отдать страницу целиком, но только если кеш достаточно свежий и цена не выдаётся за актуальную.
Граница проходит по последствиям для пользователя и данных. Убрать блок рекомендаций обычно безопаснее, чем подтвердить заказ без надёжной записи о списании. Для критичной операции правильным поведением может быть отказ с понятным сообщением, а не попытка «продолжить любой ценой».
Цель деградации — сохранить полезный сценарий, а не сделать вид, что отказа не было.
Отказоустойчивость* — способность системы продолжать предоставлять услуги при отказе отдельных компонентов. Она не означает, что все функции обязаны оставаться доступными без потерь.
Сначала определите, что именно можно потерять
Для каждой зависимости запишите, какие пользовательские сценарии от неё зависят. Затем оцените допустимый компромисс: можно ли показать кеш, убрать функцию, поставить операцию в очередь или нужно остановить её до восстановления компонента.
- Сервис рекомендаций. Часто допустимо скрыть блок или показать сохранённый результат.
- Поиск. Можно предложить недавние популярные запросы или сообщить, что поиск временно недоступен; выдавать случайные результаты опасно.
- Платёжный провайдер. Нельзя считать платёж успешным только потому, что запрос завершился тайм-аутом. Состояние нужно выяснить безопасным повторным запросом или проверкой операции.
- Хранилище данных. Если без него нельзя надёжно сохранить изменение, лучше явно отклонить запись, чем подтвердить пользователю то, что система не зафиксировала.
Разделите зависимости на обязательные и необязательные для каждого сценария, а не для приложения целиком. Одна и та же база может быть необязательной для главной страницы с кешированным каталогом и обязательной для оформления заказа.
Четыре способа ограничить ущерб
| Подход | Что сохраняет | Цена и риск |
|---|---|---|
| Кеш или заранее подготовленный ответ | Чтение и отображение части данных | Данные могут устареть; нужно определить срок и допустимую неполноту |
| Отключение необязательной функции | Основной сценарий без второстепенного блока | Пользователь временно теряет эту функцию; нужны понятный статус и условие возврата |
| Очередь для отложенной обработки | Приём работы, которую можно выполнить позже | Результат не мгновенный; возможны дубли, задержка и накопление очереди |
| Отказ до восстановления зависимости | Целостность операции, которую нельзя выполнить безопасно | Сценарий недоступен; пользователь может уйти или повторить действие |
Кеш работает только при ясных правилах свежести. Если цена или остаток товара меняются часто, показывайте время обновления или перепроверяйте значение перед подтверждением заказа. Очередь помогает лишь тогда, когда пользователь понимает, что операция ещё не завершена, а система умеет безопасно обработать повторную доставку сообщения.
Почему одна неудачная зависимость валит всё приложение
Типичная цепочка выглядит так: зависимость отвечает медленно, запросы к ней дольше занимают соединения и потоки, новые запросы копятся, а свободных ресурсов становится меньше. Тогда замедляется уже не только исходная функция. Повторные попытки без ограничений усиливают нагрузку именно в момент, когда зависимость хуже всего справляется.
Поэтому управляемый отказ требует не только запасного ответа, но и ограничений на ожидание и параллельную работу. Если запрос превысил разумное для конкретной операции время, система должна завершить его, освободить ресурсы и перейти к согласованному запасному поведению. Конкретные значения тайм-аутов нельзя назначить универсально: их выбирают по требованиям сценария и проверяют нагрузочными тестами.
Повторять запрос стоит только когда операция допускает повтор и срок ожидания ещё не исчерпан. Для действий, которые меняют состояние, нужна защита от повторного выполнения: например, идентификатор операции, который приложение использует для проверки, не обработан ли запрос раньше. Иначе тайм-аут может привести к ситуации «платёж прошёл, ответ не дошёл, клиент отправил платёж ещё раз».
Что ломается первым и где деградация опасна
- Запасной путь зависит от той же системы. Если при отказе API приложение пытается взять данные из той же базы, которую этот API использует, резервного пути нет.
- Кеш скрывает критичное устаревание. Устаревшая статья и устаревший остаток товара — разный риск. Укажите, какие данные можно показывать неактуальными и как это заметит пользователь.
- Очередь принимает быстрее, чем обработчик успевает разобрать. Накопление создаёт долгий хвост даже после восстановления зависимости. Следите за возрастом самого старого сообщения и скоростью обработки.
- Функция включается сразу после краткого улучшения. Если зависимость снова падает, переключения туда-сюда ухудшают ситуацию. Условия возврата проверяйте на тестах и по наблюдаемым метрикам, а не по одному успешному запросу.
- Запасной ответ принимают за успех. Отделяйте подтверждённую операцию от принятой в очередь и от результата, который показан из кеша.
Есть сценарии, где «хоть какой-то ответ» хуже отказа: списание денег, изменение прав доступа, выдача медицинских или иных критичных данных. Здесь приоритет — не доступность любой ценой, а корректность и безопасность. Решение зависит от характера операции и последствий ошибки.
Как проверить, что план действительно работает
Без измерений нельзя понять, помогла ли деградация или только перенесла проблему. Для каждого сценария зафиксируйте ожидаемый ответ при отказе, затем проверяйте поведение на тестовом окружении, отключая зависимость или искусственно увеличивая время её ответа.
- Доля успешных запросов и время ответа основного сценария при отказе зависимости.
- Число запросов, завершившихся тайм-аутом, и количество повторных попыток.
- Доля ответов из кеша, их возраст и количество ошибок из-за устаревших данных.
- Размер очереди, возраст старейшего сообщения и время возврата к нормальной обработке.
- Ошибки и дубли операций, которые пользователь или система сочли выполненными.
Запишите, что увидит пользователь и какие события попадут в мониторинг. Проверяйте не только отказ, но и восстановление: очередь должна разгребаться, кеш — обновляться, а отключённая функция — возвращаться без всплеска нагрузки. Числа допустимых задержек и устаревания берите из требований продукта и измерений вашей системы, а не из универсального шаблона.
Что делать дальше
Выберите один критичный пользовательский сценарий и нарисуйте его зависимости. Для каждой отметьте запасное поведение, цену ошибки и метрику восстановления. Затем проверьте на тестовом окружении отказ самой медленной зависимости и убедитесь, что основной сценарий сохраняет обещанную целостность. Начните с одной функции: широкая деградация, которую никто не проверял, способна добавить отказов вместо того, чтобы их ограничить.
* Термин часто используют рядом с «устойчивостью к отказам», но graceful degradation подчёркивает не полное сохранение функций, а контролируемое упрощение сервиса.
Источники
Тест и проверочная: Быстрые ответы с объяснением, почему остальные варианты неверны
Спросить за 10 ₽Источники: Google SRE Book: Handling Overload, AWS Builders’ Library: Making retries safe with idempotent APIs
Частые вопросы
Graceful degradation — это то же самое, что резервный сервер?
Что показывать пользователю, если внешний API не отвечает?
Можно ли просто повторять запрос, пока сервис не ответит?
Как понять, что запасной режим работает?
Нужно ли всегда показывать старые данные вместо ошибки?
Нужен ли для такого подхода конкретный фреймворк?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.