Обработка ошибок в проекте: стратегия без хаоса
Если каждый модуль сообщает об ошибках по-своему, сбой трудно найти, а клиенту легко раскрыть лишнее. Разбираем, как договориться о типах ошибок, границах обработки, логах и повторах без привязки к конкретному языку.
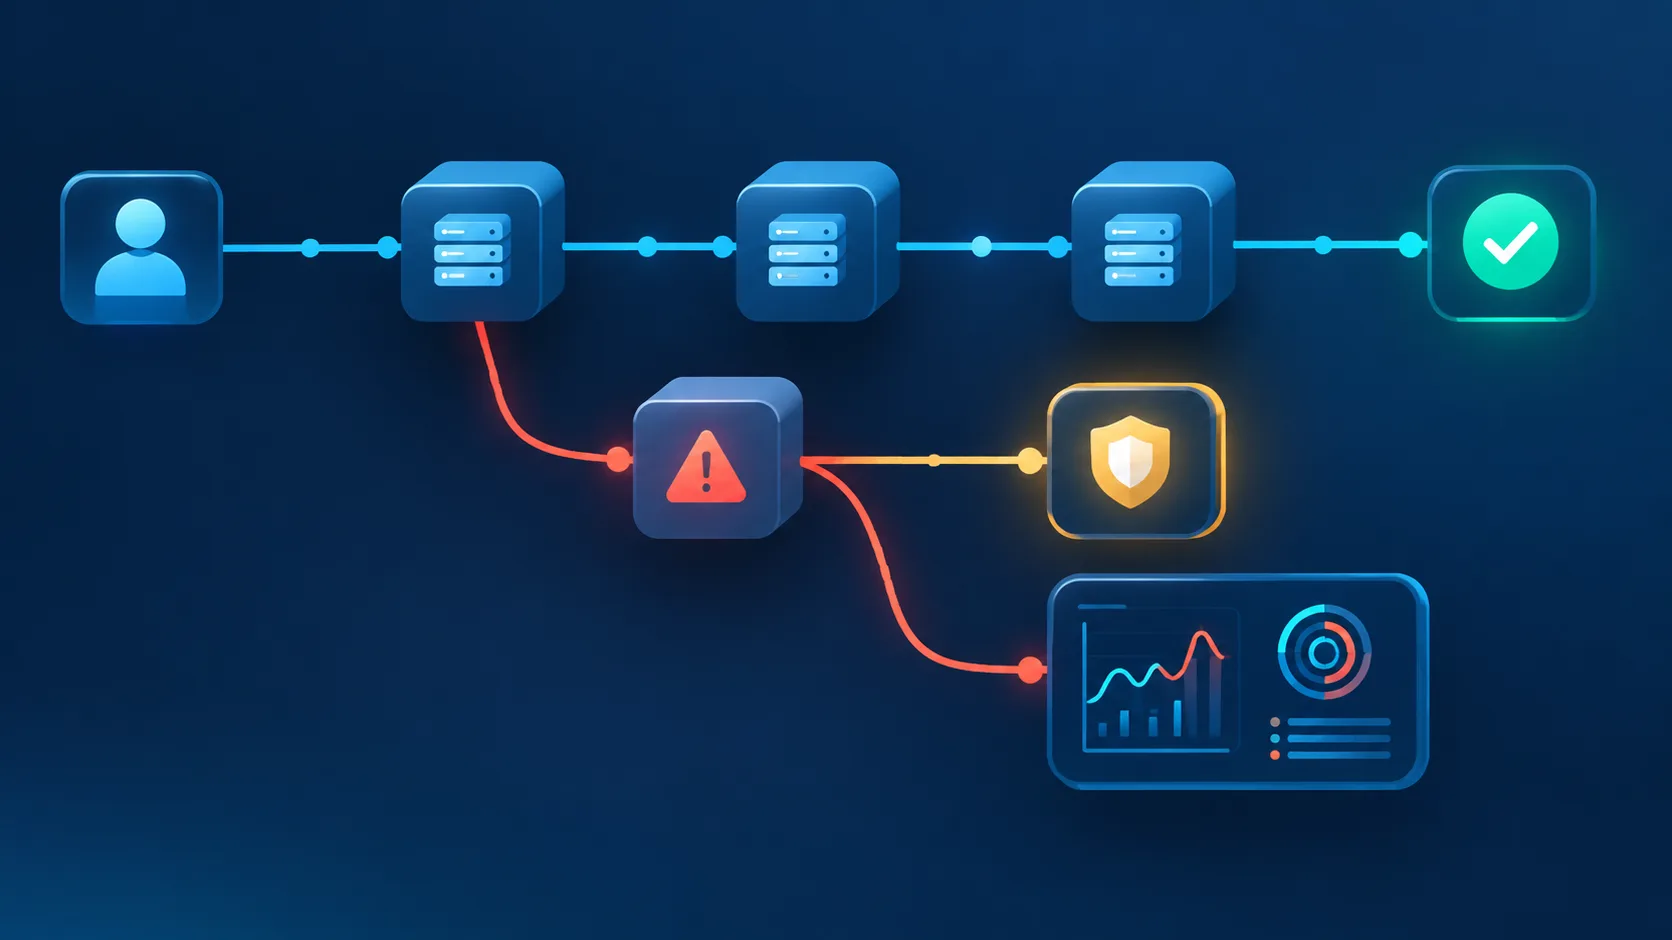
Когда один и тот же сбой в разных частях сервиса превращается то в пустой ответ, то в HTTP 500, то в запись без контекста в логе, проблема не в недостатке блоков try/catch. Нет общего соглашения: кто классифицирует ошибку, кто превращает её в ответ клиенту и какие данные обязаны попасть в журнал. Ниже — практическая стратегия для серверного приложения, независимо от языка и фреймворка. Она не заменяет обработку исключений в конкретной технологии: её имена и поведение сверяйте с документацией вашей версии.
Сначала разделите ошибки по ответственности
Одна универсальная категория «ошибка» слишком груба. Сетевой тайм-аут и неверный адрес электронной почты требуют разных действий. Для проектного соглашения достаточно трёх групп:
- Ожидаемые ошибки запроса: неверные данные, отсутствие доступа, не найденный ресурс. Их можно безопасно объяснить клиенту, не поднимая тревогу как при аварии.
- Временные ошибки зависимости: недоступна база данных, исчерпан тайм-аут внешнего сервиса, соединение оборвалось. Иногда запрос можно повторить; причину нужно сохранить для диагностики.
- Неожиданные ошибки приложения: нарушение инварианта, необработанное исключение, ошибка в логике. Клиенту — нейтральный ответ, команде — событие с контекстом и уровнем серьёзности.
Классификация — не список классов для каждого проекта. Это договорённость о поведении. Например, ошибка «платёжный сервис не ответил вовремя» не должна незаметно превращаться в «платёж отклонён»: клиент может повторить оплату, а операция уже могла пройти.
Выберите, где ошибка меняет форму
В типичном серверном приложении есть три полезных места. Внутри модуля ошибка описывает сбой операции; на границе между модулями её переводят в язык вызывающей стороны; на границе приложения — в безопасный ответ пользователю и запись для диагностики. Если каждый слой перехватывает всё подряд и возвращает «ошибка», теряются причина и возможность принять решение.
| Подход | Что выигрываете | Чем платите | Где уместен |
|---|---|---|---|
| Обрабатывать у места возникновения | Есть доступ к контексту операции | Повторение логики и риск проглотить сбой | Когда здесь можно исправить ситуацию или добавить полезный контекст |
| Передавать ошибку выше | Решение принимает слой, который знает сценарий целиком | Нужно сохранять исходную причину и не терять контекст | Для большинства ошибок, которые локально исправить нельзя |
| Перехватывать на границе приложения | Единый формат ответа и единая политика для необработанных сбоев | Граница не должна маскировать ожидаемые ошибки как аварии | Для последнего безопасного преобразования в HTTP-ответ и записи события |
Практический вариант — сочетать эти подходы. Перехватывайте ошибку рядом с источником, только если там есть осмысленное действие: откатить локальную операцию, добавить сведения или преобразовать ошибку зависимости в понятный доменный результат. Иначе передавайте её выше с исходной причиной. На внешней границе ловите необработанные сбои централизованно.
Ошибка полезна не тогда, когда её удалось перехватить, а когда следующий слой может понять, что делать дальше.
Закрепите единый контракт для клиента и команды
Для HTTP API отдельно определите публичный ответ и внутреннюю запись. Клиенту нужны стабильный код ошибки, короткое безопасное описание и идентификатор запроса, если он помогает обратиться в поддержку. Не возвращайте стек вызовов, SQL, внутренние адреса сервисов, секреты и необработанный текст исключения.
Если API использует формат RFC 9457, задайте для него единый профиль: какие поля обязательны, как называются прикладные коды ошибок и как передаётся идентификатор запроса. Сам стандарт описывает формат проблемы HTTP, но не определяет бизнес-логику конкретного сервиса. Если формат не используется, всё равно зафиксируйте собственный контракт и не меняйте его случайно в отдельных обработчиках.
Внутренняя запись должна отвечать на вопросы: какая операция упала, какая зависимость участвовала, можно ли безопасно повторить запрос и как найти связанные события. Полезные поля — тип ошибки, маршрут или операция, идентификатор трассировки, результат и длительность. Персональные данные и секреты в логи не копируйте. Стек вызовов оставляйте для внутренних диагностических систем, а доступ к ним ограничивайте по правилам команды.
Повторы не лечат каждую ошибку
Повтор имеет смысл только для временного сбоя и только если операция допускает его последствия. Повторить чтение обычно безопаснее, чем повторить создание платежа или заказа. Если клиент или фоновая очередь повторит операцию после тайм-аута, первая попытка могла завершиться успешно, хотя ответ не дошёл.
Перед повтором согласуйте три вещи: какие ошибки считаются временными, сколько попыток разрешено и как система избегает двойного эффекта. Для операций, где повтор может создать дубликат, нужна защита на уровне бизнес-сценария, например проверка уникального идентификатора операции. Не добавляйте автоматический повтор ко всем исключениям: он способен увеличить нагрузку именно тогда, когда зависимость уже перегружена.
Идемпотентность1 — свойство операции давать тот же результат при безопасном повторе, а не создавать новый эффект при каждом запуске.
Как внедрить соглашение без переписывания проекта
- Соберите реальные примеры. Возьмите недавние ошибки из логов, тикетов и ответов API. Для каждой отметьте: ожидаемая она или аварийная, кто её обнаружил, что увидел клиент. Проверка: команда может отнести каждый пример к согласованной категории.
- Опишите контракт на одной странице. Зафиксируйте категории, публичные ответы, обязательные поля логов и правила повторов. Не начинайте с большой иерархии типов. Проверка: разработчик может решить, куда отнести новый сценарий, не спрашивая автора документа.
- Назначьте границы обработки. Укажите, где ошибка преобразуется, где добавляется контекст и где формируется ответ. Для каждого перехвата задайте вопрос: что здесь можно сделать, чего не может сделать вызывающий слой? Проверка: нет обработчика, который молча проглатывает сбой.
- Проверьте опасные сценарии. Убедитесь, что клиент не получает внутренние детали, тайм-аут не выдаётся за подтверждённый отказ, а повтор не создаёт дубликат. Проверка: для каждого сценария есть ожидаемый ответ и запись, которую можно связать с запросом.
- Добавьте проверку в ревью и тесты. Проверяйте не только тип ответа, но и отсутствие секретов, сохранение исходной причины и поведение при отказе зависимости. Проверка: типовые ошибки воспроизводятся автоматическим тестом или понятной ручной проверкой.
Что обычно ломается
- Широкий перехват с успешным ответом. Ошибка исчезает из потока управления, а вызывающий код считает операцию завершённой. Не перехватывайте сбой, если не можете исправить его или явно вернуть неуспех.
- Повторное журналирование на каждом слое. Одна ошибка превращается в несколько похожих записей. Выберите владельца финальной записи; выше по цепочке добавляйте контекст, а не дублируйте событие без причины.
- Разные ответы для одной причины. Клиентская логика начинает зависеть от случайного текста. Стабилизируйте машинно-читаемый код, а сообщение оставьте для человека.
- Слишком широкая политика повторов. Очередь или клиент умножают нагрузку и повторяют операцию с побочным эффектом. Повторяйте только определённые временные ошибки и проверяйте безопасность сценария.
Как проверить стратегию на живом сервисе
Универсальные цифры улучшения здесь были бы выдумкой: результат зависит от архитектуры, трафика и качества наблюдаемости до изменений. Вместо этого сравните период до и после внедрения по одинаковым маршрутам и условиям. Измеряйте долю ошибок по категориям, число повторов, долю ответов без идентификатора запроса, время от появления сбоя до установления причины и случаи, когда клиент получил внутренние детали. Уточните отдельно, как именно в вашей системе считается каждая метрика.
На следующем этапе выберите один часто падающий сценарий и проследите его путь от источника ошибки до ответа и записи в журнале. Если по этим двум следам нельзя понять, что произошло и безопасно ли повторять операцию, сначала улучшите контракт и диагностику этого сценария — только потом переносите правило на весь проект.
1 Идемпотентность не означает, что любая операция безопасна для повтора: это свойство конкретного действия и его реализации.
Аудитор договоров: Word/PDF договоры: скрытые штрафы и пени, протокол разногласий.
Спросить за 20 ₽Источники: RFC 9457: Problem Details for HTTP APIs, OpenTelemetry Documentation
Частые вопросы
Нужно ли перехватывать каждое исключение?
Можно ли вернуть клиенту текст исключения?
Когда повторять запрос после ошибки?
Нужен ли отдельный формат ошибок для HTTP API?
Как понять, что стратегия работает?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.