Обратное давление в конвейерах: разбор работы под нагрузкой
Если источник производит 1000 сообщений в секунду, а следующий этап обрабатывает только 300, очередь растёт на 700 сообщений в секунду. Разбираем, как обратное давление останавливает этот разгон, где оно возникает и чем приходится платить.
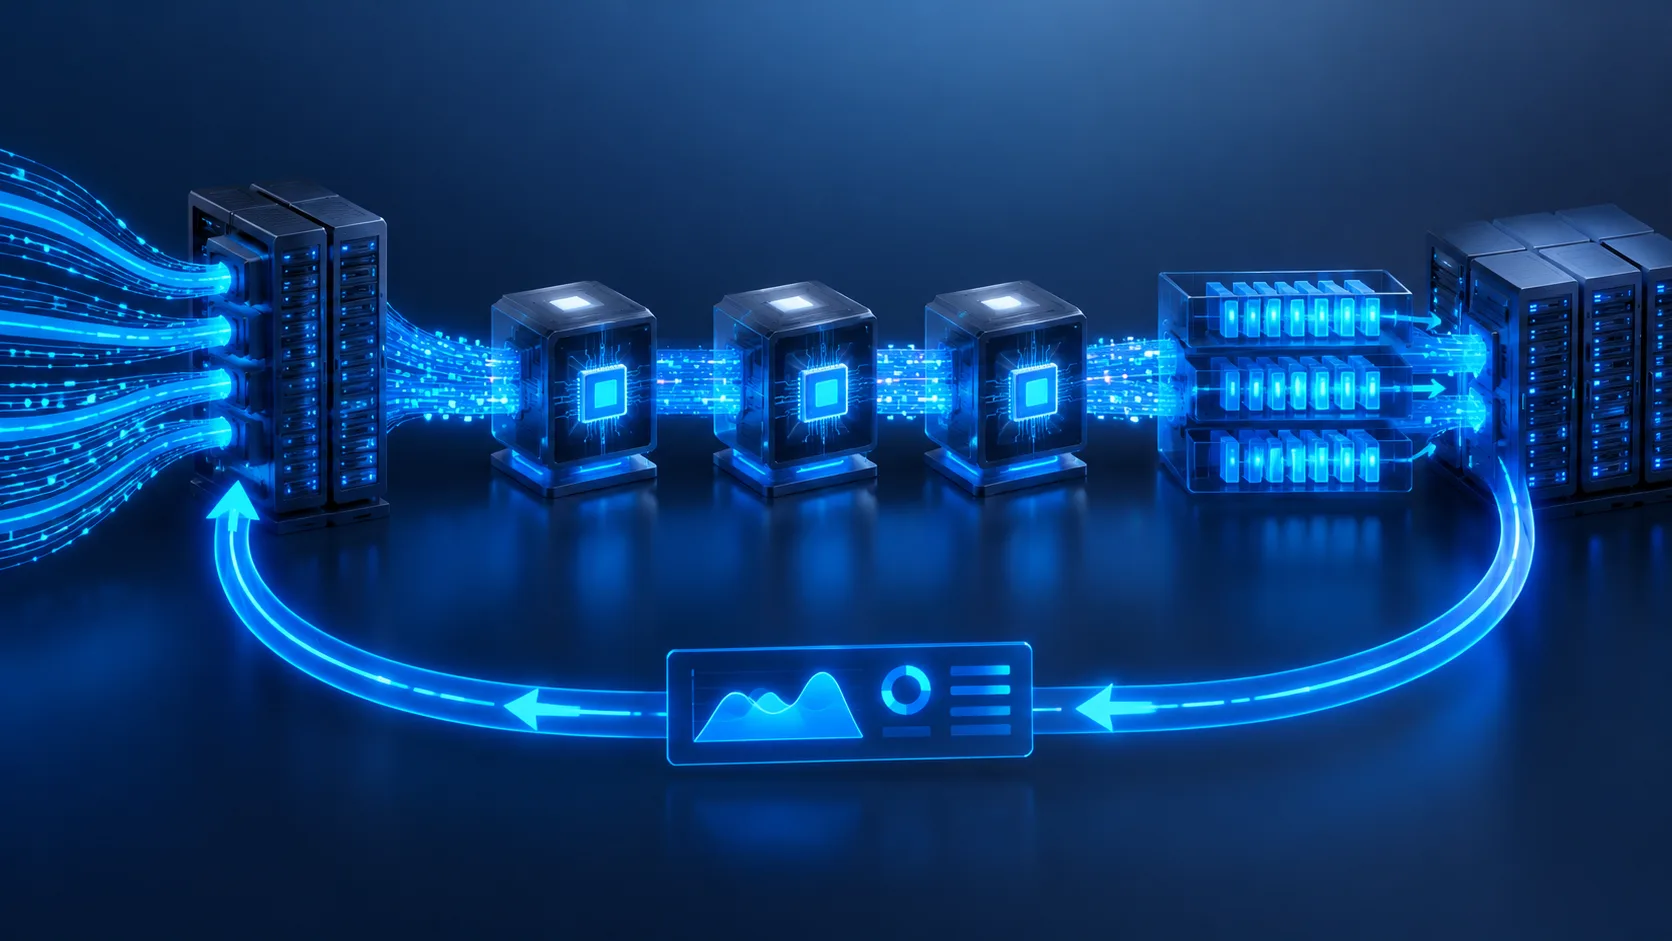
Если источник производит 1000 сообщений в секунду, а следующий этап обрабатывает только 300, очередь растёт на 700 сообщений в секунду. Через минуту это уже 42 000 необработанных элементов. Обратное давление не ускоряет медленный этап: оно заставляет upstream-часть конвейера снизить скорость, остановиться или начать отбрасывать данные до того, как переполнится память и посыпятся таймауты.
Что именно происходит в конвейере
Типичный конвейер состоит из источника, одного или нескольких промежуточных этапов и потребителя. Источник может читать HTTP-запросы, сообщения из брокера, файлы или строки из базы. Каждый этап принимает элементы, выполняет работу и передаёт результат дальше.
Проблема появляется, когда скорость соседних этапов различается. Пусть источник отдаёт 1000 элементов в секунду, первый обработчик успевает 800, а запись в хранилище — только 300. Если между ними нет ограничения, очередь начинает расти с разницей между поступлением и обработкой. Такая очередь временно сглаживает пики, но не устраняет дефицит производительности.
Когда память заканчивается, система выбирает один из плохих сценариев: процесс получает ошибку нехватки памяти, контейнер перезапускается, брокер начинает увеличивать задержку, а клиент видит таймаут. Обратное давление переносит ограничение вверх по цепочке, пока система ещё может управляемо замедлиться.
Обратное давление — это не «ещё одна очередь». Это контракт, который не позволяет производителю считать работу принятой, пока потребитель не готов принять следующий объём.
Сноска. Backpressure, или обратное давление, — механизм согласования скорости producer и consumer. В русской документации также встречается термин «управление скоростью потребления».
Механика: сигнал идёт против потока данных
Данные обычно движутся слева направо: publisher передаёт элементы subscriber. Сигнал готовности идёт в обратную сторону. Потребитель сообщает, сколько элементов он готов принять, а промежуточный этап передаёт этот лимит дальше только в пределах доступной ёмкости.
Модель спроса в Reactive Streams
В спецификации Reactive Streams 1.0.4 эта идея выражена через подписку: потребитель вызывает request(n), где n — разрешённое число элементов. Производитель не должен бесконтрольно отправлять больше данных, чем разрешено текущим спросом.
В реальной библиотеке между ними почти всегда есть буфер. Он нужен не для бесконечного накопления, а для небольшого рассогласования скоростей. Если буфер рассчитан на 256 элементов и уже заполнен, следующий этап должен либо дождаться свободного места, либо применить заранее выбранную политику потерь.
Кредиты, окна и блокировка
Под капотом встречаются три похожих механизма.
- Кредиты. Потребитель выдаёт разрешение на конкретное число сообщений. После обработки кредит восстанавливается.
- Окно. Поток может отправить ограниченный объём данных, после чего ждёт подтверждения обработки. Такой подход часто используется в сетевых протоколах и потоковой передаче.
- Блокировка. Производитель останавливается, когда очередь заполнена. Это просто реализовать, но блокирующий поток может занять рабочий поток пула и ухудшить ситуацию.
Важна граница ответственности. Если библиотека умеет только ограничивать локальный буфер, это ещё не означает, что давление дошло до внешнего источника. Чтобы остановить чтение из брокера, базы или сокета, нужен адаптер, который понимает этот протокол.
Где давление возникает на практике
Потоковая библиотека
В конвейерах на Reactive Streams потребитель явно управляет спросом. Если оператор обработки выполняет медленный вызов к базе, количество новых элементов ограничивается его текущей пропускной способностью. Но это работает только до границы, где следующий источник поддерживает тот же контракт.
Если адаптер превращает поток сообщений в бесконечную очередь в памяти, давление заканчивается на этой очереди. Приложение может выглядеть «реактивным» снаружи, но всё равно накапливать данные внутри.
Apache Kafka
Kafka-клиент получает записи порциями во время вызова poll(). Приложение может временно приостановить назначенные разделы через механизм pause/resume, если обработчик перегружен. Это не универсальная кнопка backpressure: нужно учитывать частоту poll(), время обработки, коммиты смещений и ограничения группы потребителей.
Если потребитель слишком долго не вызывает poll(), он рискует выйти за допустимые интервалы группы и вызвать перераспределение разделов. Поэтому «просто остановить чтение» может привести не к спокойному замедлению, а к постоянным ребалансировкам. Точные значения параметров зависят от версии клиента и конфигурации кластера; их следует сверять с документацией конкретной версии Apache Kafka.
HTTP и очереди заданий
В HTTP-сервисе обратное давление часто начинается слишком поздно. Балансировщик продолжает принимать запросы, веб-сервер держит соединения, а приложение складывает работу в локальную очередь. Если очередь не ограничена, число запросов превращается в потребление памяти.
Правильная граница обычно включает ограниченную очередь и явный ответ при перегрузке. Для синхронного API это может быть отказ с повтором на стороне клиента, для фоновой задачи — запись в надёжный брокер и подтверждение только после принятия сообщения брокером.
Четыре стратегии и их цена
| Стратегия | Что происходит при переполнении | Цена решения | Когда подходит |
|---|---|---|---|
| Остановить источник | Новые элементы временно не читаются | Растёт задержка, источник должен поддерживать паузу | Данные нельзя терять, источник управляемый |
| Ограниченная очередь | Производитель ждёт свободного места или получает отказ | Нужно выбрать размер буфера и таймаут ожидания | Локальные конвейеры, фоновые worker-пулы |
| Отбрасывать элементы | Теряются новые, старые или наименее приоритетные данные | Нужны правила потерь и наблюдаемость | Метрики, телеметрия, промежуточные события |
| Масштабировать потребителя | Добавляются обработчики или партиции | Упирается в базу, сеть, порядок сообщений и бюджет | Нагрузка растёт устойчиво, а работа хорошо распараллеливается |
Самая опасная стратегия — не выбрать никакую. Тогда политика определяется случайно: размером heap, лимитом контейнера, таймаутом балансировщика или поведением брокера.
Как измерять обратное давление
Одной метрики «очередь не пустая» недостаточно. Нужны данные о каждой границе конвейера и одинаковый временной интервал измерения.
- Снимите скорость входа и выхода. Считайте элементы в секунду отдельно для источника, каждого оператора и конечной записи.
- Измерьте глубину очереди. Смотрите не только среднее, но и максимум, время нахождения элементов и долю заполнения буфера.
- Разделите задержки. Запишите время ожидания в очереди, собственно обработки и подтверждения записи.
- Проверьте память и сборку мусора. Растущий heap при стабильной скорости обработки обычно указывает на накопление, а не на «медленный GC» сам по себе.
- Зафиксируйте потери и отказы. Считайте отброшенные элементы, таймауты, повторы, ошибки подтверждения и ребалансировки потребителей.
Замеры до и после оптимизации нельзя честно сравнить без условий: размера сообщения, числа партиций или рабочих процессов, объёма данных, версии клиента, конфигурации очереди и ограничений базы. Если этих параметров нет, число «обработка стала в два раза быстрее» ничего не доказывает.
Граничные случаи и места поломки
Медленная операция с внешним сервисом
Один запрос к API или базе может стать узким местом для всего конвейера. Увеличение параллельности временно сокращает очередь, но способно превратить медленный сервис в источник каскадных таймаутов. Ограничение параллельных запросов должно быть частью договора между этапами, а не случайным значением пула потоков.
Очередь без верхней границы
Буфер «на всякий случай» маскирует проблему до момента, когда её уже нельзя плавно остановить. Размер выбирают из допустимой задержки и доступной памяти, а не из принципа «чем больше, тем надёжнее».
Повторная доставка
При остановке после обработки, но до подтверждения сообщение может прийти повторно. Поэтому обратное давление не делает обработку автоматически ровно один раз. Обработчик должен учитывать идемпотентность, порядок сообщений и момент фиксации результата.
Отбрасывание данных
Политика drop подходит только тогда, когда потеря конкретного элемента допустима. Для платежа, команды изменения состояния или события аудита такой выбор может быть неприемлем. Для метрик нужно заранее определить, какие данные можно потерять, и выставить отдельный счётчик потерь.
Что проверять на ревью
- Есть ли конечный размер каждой очереди, или приложение может накапливать элементы бесконечно.
- Как источник узнаёт о переполнении и что получает клиент: ожидание, отказ, повтор или потерю.
- Дойдёт ли сигнал паузы до внешнего брокера, либо остановится только локальный consumer.
- Что происходит при падении между обработкой и подтверждением.
- Какие метрики покажут, что система упёрлась в потребителя, а не в сеть, CPU или базу.
Формулировка «добавим ещё воркеров» недостаточна. На ревью нужно спросить, какой ресурс станет следующим ограничением: соединения с базой, партиции Kafka, лимит внешнего API, память или порядок обработки.
Что делать дальше
Начните с карты конвейера: источник, очередь, обработчик, внешняя зависимость, подтверждение. Для каждой границы запишите максимальный размер буфера, поведение при заполнении и метрики. Затем проведите контролируемый тест: постепенно увеличивайте входную скорость и отмечайте момент, когда растут задержка, память и число отказов.
В проде первым сигналом проблемы обычно становится не сама ошибка, а постоянный рост возраста самого старого сообщения. Настройте наблюдение за этим показателем, глубиной очередей и временем обработки. Инвалидация кешей и выбор схемы повторных попыток — отдельные темы; здесь важно сначала сделать скорость потребления конечной и видимой.
Проектная работа: От проблемы до защиты: продукт, этапы, вопросы комиссии
Спросить за 15 ₽Источники: Reactive Streams: спецификация и JVM-интерфейсы, Apache Kafka Documentation: Design
Частые вопросы
Чем обратное давление отличается от обычной очереди?
Нужно ли всегда останавливать источник при переполнении?
Можно ли решить проблему, просто добавив воркеров?
Что будет, если обратное давление не успеет остановить поток?
Как понять, что виноват именно потребитель?
Безопасно ли использовать pause в Kafka для снижения нагрузки?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.