Планировщик задач в распределённой системе на Python: что внутри
Два воркера забрали одну и ту же задачу, cron-джоба продублировалась на трёх нодах. Разбираем, как устроены брокер, идемпотентность и лидер-локи в распределённом планировщике на Python.
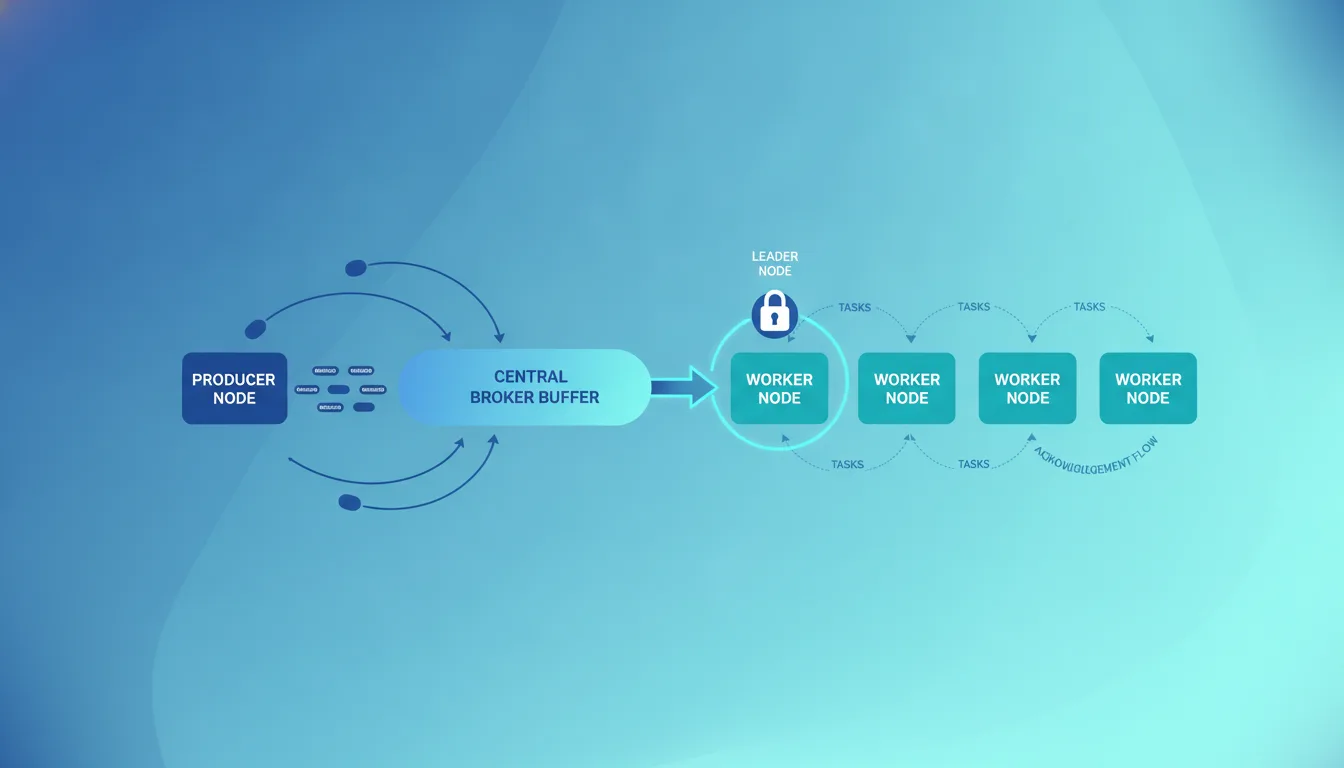
Классическая авария распределённого планировщика: периодическая задача «списать подписки» запустилась одновременно на трёх нодах, и половина клиентов получила тройное списание. Или другое — задача повисла в очереди на 40 минут, потому что воркер, который её забрал, упал, а брокер об этом не узнал. Оба случая — не про баг в коде задачи, а про то, как устроен сам механизм постановки, захвата и подтверждения задач. Разберём этот механизм на уровне брокера, видимости сообщения и лидер-локов, на примере стека Celery 5.x, Redis и APScheduler.
Из чего собран распределённый планировщик
Любая система «поставил задачу здесь — выполнилась там» состоит из трёх независимых частей, и путать их — источник большинства ошибок:
- Продюсер — код, который формирует задачу и кладёт её в брокер. В Celery это вызов
task.delay()илиtask.apply_async(). - Брокер — транспорт, который хранит очередь сообщений между продюсером и воркером: Redis, RabbitMQ, реже базы данных. Именно он определяет, что произойдёт, если воркер упадёт с задачей на руках.
- Воркер — процесс, который тянет задачу из брокера, выполняет и подтверждает результат.
Отдельно стоит планировщик по расписанию (celery beat, APScheduler) — он не выполняет задачи, а только в нужный момент кладёт их в брокер как обычный продюсер. Это ключевой момент: beat — это тикающий будильник, а не исполнитель.
Что происходит с задачей от постановки до подтверждения
Разложим путь одной задачи в Celery на Redis по шагам, потому что каждый переход — потенциальная точка отказа:
- Продюсер сериализует задачу (по умолчанию JSON) и делает
LPUSHв список Redis с именем очереди. - Свободный воркер делает блокирующий
BRPOPи забирает сообщение. - Воркер выполняет функцию задачи.
- По завершении — при включённом
task_acks_late— задача считается подтверждённой. Иначе она подтверждается сразу после получения, ещё до выполнения.
Разница между шагом 2 и шагом 4 — это и есть то место, где задачи теряются или дублируются.
Момент подтверждения: ack early против ack late
По умолчанию Celery подтверждает задачу сразу после того, как воркер её забрал (early ack). Логика: воркер получил — значит взял ответственность. Проблема в том, что если процесс упадёт в середине выполнения, задача уже подтверждена и брокер её не вернёт. Она просто исчезнет.
Альтернатива — task_acks_late = True. Тогда подтверждение уходит после успешного завершения. Если воркер упал в процессе, брокер вернёт задачу другому воркеру.
# Celery 5.x — конфигурация с поздним подтверждением
# celery_app.py
from celery import Celery

app = Celery("billing", broker="redis://localhost:6379/0")

app.conf.update(
    # подтверждать задачу только после успешного выполнения
    task_acks_late=True,
    # если воркер потерял связь с брокером — вернуть задачу в очередь
    task_reject_on_worker_lost=True,
    # сколько задач воркер забирает про запас; при acks_late держите 1
    worker_prefetch_multiplier=1,
)
За позднее подтверждение платят повторным выполнением: если задача завершилась, но воркер упал до того, как ack дошёл до брокера, задача выполнится второй раз. Отсюда железное правило — с acks_late задача обязана быть идемпотентной.
Late ack не гарантирует «ровно один раз». Он гарантирует «хотя бы один раз». Разница между этими формулировками — это разница между «клиент получил письмо» и «клиент получил три письма».
Prefetch: почему воркер держит задачи, которые не выполняет
Воркер забирает из брокера не по одной задаче, а пачкой — количество определяется worker_prefetch_multiplier, умноженным на число процессов. При тяжёлых долгих задачах это вредно: воркер захватил десять задач, выполняет первую пять минут, а остальные девять простаивают в его буфере, хотя рядом есть свободный воркер. При acks_late и долгих задачах ставьте prefetch равным 1, чтобы задача не блокировалась в буфере занятого воркера.
Дубли от планировщика по расписанию
Отдельная и самая частая боль — периодические задачи. Если запустить два процесса celery beat для отказоустойчивости, каждый будет независимо класть задачу в очередь по своему тику. Результат — дубли, как в примере с тройным списанием.
Celery beat не рассчитан на запуск в нескольких экземплярах. Здесь есть три пути:
- Запускать ровно один процесс beat и обеспечивать его перезапуск через systemd или Kubernetes (один реплика-под). Просто, но beat становится единой точкой отказа на время рестарта.
- Использовать внешний планировщик, который сам решает проблему единственности — например, CronJob в Kubernetes с политикой
concurrencyPolicy: Forbid. - Ставить лидер-лок: несколько процессов beat стартуют, но задачу в очередь кладёт только тот, кто захватил распределённую блокировку.
Лидер-лок на Redis: как это работает внутри
Распределённая блокировка на Redis — это ключ с TTL, который может создать только один процесс. Механизм строится на атомарной операции SET key value NX EX ttl: NX означает «установить, только если ключа нет», EX — время жизни в секундах. Кто первым выполнил команду успешно — тот лидер.
# Лидер-лок через redis-py (redis 5.x)
# Только владелец лока ставит периодическую задачу в очередь.
import uuid
import redis

rds = redis.Redis(host="localhost", port=6379, db=0)

LOCK_KEY = "beat:billing:leader"
LOCK_TTL = 30  # секунд; должен быть больше интервала тика

def try_become_leader():
    # уникальный токен, чтобы снять только свой лок
    token = str(uuid.uuid4())
    # SET ... NX EX — атомарный захват
    acquired = rds.set(LOCK_KEY, token, nx=True, ex=LOCK_TTL)
    return token if acquired else None

# Освобождение через Lua: проверить владельца и удалить одной операцией.
# Без этого можно снять чужой лок, если TTL истёк между GET и DEL.
RELEASE_SCRIPT = """
if redis.call('get', KEYS[1]) == ARGV[1] then
    return redis.call('del', KEYS[1])
else
    return 0
end
"""

def release_leader(token):
    rds.eval(RELEASE_SCRIPT, 1, LOCK_KEY, token)
Тонкость, которую пропускают чаще всего: TTL лока должен быть больше интервала тика, но снятие лока обязано проверять владельца. Иначе процесс А захватил лок, завис на паузу GC дольше TTL, лок истёк, процесс Б стал лидером — а проснувшийся А снимает лок, который уже принадлежит Б. Проверка токена в Lua-скрипте закрывает этот сценарий.
Идемпотентность: единственная реальная защита от дублей
Ни late ack, ни лидер-лок не дают строгой гарантии «ровно один раз» — в распределённой системе её в общем случае нет. Практический выход — сделать так, чтобы повторное выполнение было безопасным. Приёмы:
- Ключ идемпотентности — задача несёт уникальный идентификатор операции (например,
payment_id), и перед выполнением проверяет в базе, не обработан ли он уже. - Уникальный индекс в БД — вставка записи о выполненной операции падает на конфликте, если она уже была. Это переносит проверку на уровень базы, где она атомарна.
- Условное обновление —
UPDATE ... WHERE status = 'pending'вместо безусловного, чтобы второй вызов ничего не изменил.
Сравнение стратегий доставки
| Стратегия | Гарантия | Риск | Когда применять |
|---|---|---|---|
| Early ack (по умолчанию) | Не более одного раза | Потеря задачи при падении воркера | Задачи, которые не критично потерять (прогрев кеша) |
| Late ack + идемпотентность | Хотя бы один раз | Повторное выполнение | Списания, письма, изменение данных |
| Late ack без идемпотентности | Хотя бы один раз | Дубли побочных эффектов | Опасно; так делать не стоит |
Где Redis как брокер ломается первым
Redis удобен и быстр, но у него нет встроенного подтверждения на уровне протокола — Celery эмулирует видимость через отдельный механизм. Ключевой параметр — visibility_timeout в настройках транспорта. Если задача выполняется дольше этого таймаута, Redis-транспорт считает воркер потерянным и отдаёт задачу второму воркеру. Тогда одна долгая задача выполняется дважды параллельно.
По умолчанию visibility timeout равен часу. Точное значение и способ его задания сверяйте в актуальной документации Celery для вашей версии — параметр находится в broker_transport_options. Правило простое: он должен превышать самое долгое возможное время выполнения задачи с запасом. Если у вас есть задачи по 90 минут, а таймаут час — вы получите дубли на ровном месте.
RabbitMQ в этом смысле честнее: подтверждение встроено в протокол AMQP, задача помечается неподтверждённой на время выполнения независимо от таймаутов приложения. Цена — более тяжёлая эксплуатация брокера.
Что настроить и мерить дальше
Минимальный набор для системы, где задачи меняют данные:
- Включите
task_acks_lateиtask_reject_on_worker_lost, сделайте задачи идемпотентными. - Держите один экземпляр beat или защитите его лидер-локом с проверкой владельца.
- Выставьте
visibility_timeoutзаведомо больше самой долгой задачи. - Мерьте длину очередей (например,
LLENпо ключам Redis) и время от постановки до выполнения — рост этого лага раньше всего сигналит о нехватке воркеров.
Инвалидация результатов и хранение состояния задач в бэкенде результатов — отдельная тема, здесь мы разбирали только доставку и захват. Следующий шаг для продакшена — настроить мониторинг воркеров через Flower или экспорт метрик очередей в вашу систему наблюдения.
Риелтор и ипотечный брокер: Сравнение льготных ипотек, приёмка квартиры, проверка ДДУ.
Спросить за 15 ₽Источники: Celery — Optimizing and Tasks configuration, Redis — SET command (NX, EX options)
Частые вопросы
У меня Celery другой версии, настройки называются иначе?
Late ack включил, а задачи всё равно дублируются. Что не так?
Нужен ли лидер-лок, если beat запущен в одном экземпляре?
Redis или RabbitMQ выбрать брокером?
Можно ли добиться доставки строго один раз?
Почему воркер держит задачи, которые не выполняет?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.