Плавающие ошибки под нагрузкой: что ломается первым
Сервис работает в одиночном тесте, но под параллельными запросами начинает случайно отдавать 502, таймауты или ошибки базы. Разбираем, как воспроизвести сбой, найти первый отказавший слой и не перепутать симптом с причиной.
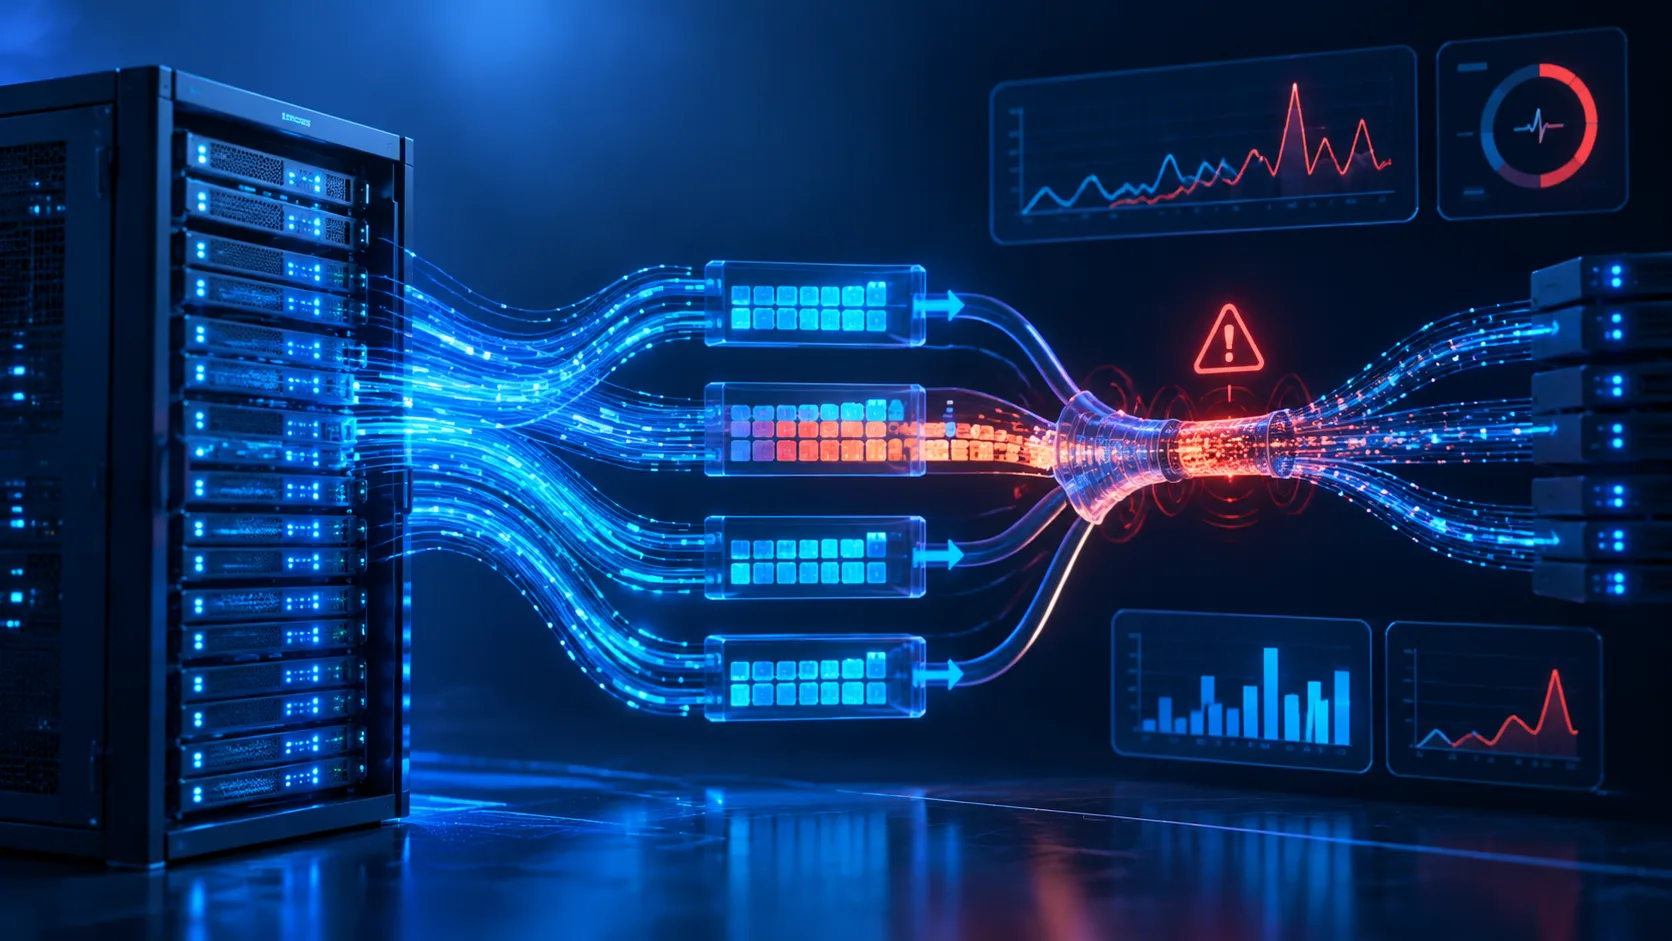
Сервис может отвечать без ошибок на десяти запросах в секунду, а на сотне начать случайно возвращать 502, таймауты и отказы подключения к базе. Такой сбой трудно поймать обычным функциональным тестом: повторный запуск проходит, а в логах остаются только последствия. Ниже — методика для staging или изолированного тестового контура: как зафиксировать профиль нагрузки, найти первый отказавший ресурс и проверить гипотезу без угадывания. Полный цикл обычно занимает от одного до нескольких часов, если уже есть метрики и трассировка.
Что считать плавающей ошибкой
Плавающая ошибка — это сбой, который возникает не на каждом запросе, а только при определённом сочетании параллельности, длительности операции и состояния системы. Один и тот же endpoint может вернуть 200, затем 504, а через секунду снова 200.
Важна не только доля ошибок. При росте нагрузки сначала часто меняется распределение времени ответа: среднее значение ещё выглядит приемлемо, но p95 и p99 резко уходят вверх.
p95 — перцентиль времени ответа: 95% запросов завершились не медленнее указанного значения, а 5% были ещё дольше. Среднее время может скрыть именно эти пять процентов.
Первый HTTP-код 502 не доказывает, что сломан прокси. Ищите ресурс, который исчерпался раньше всех: очередь, соединения, CPU, память или лимит внешнего сервиса.
Сначала зафиксируйте эксперимент
Нагрузка без описания условий не воспроизводит инцидент. Перед запуском запишите:
- версию приложения, веб-сервера, драйвера базы данных и операционной системы;
- размер и состав тестовых данных;
- число виртуальных пользователей или запросов в секунду;
- длительность разгона, плато и остановки нагрузки;
- таймауты клиента, reverse proxy, приложения и базы;
- какие фоновые задачи, кэши и интеграции включены;
- CPU, память, файловые дескрипторы, сетевые соединения и ошибки каждой зависимости.
Один запуск должен менять только один фактор. Если одновременно увеличить RPS, размер ответа и число worker-процессов, вы получите симптом, но не поймёте, какая перемена его вызвала.
Как воспроизводить сбой ступенями
1. Найдите безопасную базовую линию
Начните с небольшой нагрузки, при которой ошибок нет. Для API полезно отдельно проверить лёгкий endpoint, типичный пользовательский сценарий и самый дорогой запрос. В тестовом контуре уберите реальные платежи, письма и вызовы, которые могут создать побочные эффекты.
Проверка результата: при повторных запусках совпадают доля ответов 2xx, p95, число запросов к базе и потребление памяти. Если базовая линия уже нестабильна, нагрузочный тест только усложнит диагностику.
2. Увеличивайте параллельность небольшими шагами
Поднимайте интенсивность, например, на 10–20% за шаг и выдерживайте каждый уровень несколько минут. Фиксируйте не только количество ошибок, но и момент, когда начали расти p95 и p99.
Проверка результата: в отчёте есть таблица «нагрузка — p95 — ошибки — CPU — память — соединения». Критическая точка — не обязательно первый ответ 500. Ею может быть уровень, после которого задержка уже не возвращается к прежнему значению.
3. Разделите ошибки клиента и ошибки сервера
Таймаут генератора нагрузки означает, что клиент не дождался ответа. Это не то же самое, что HTTP 500, отказ TCP-соединения или разрыв соединения со стороны прокси. Сохраняйте статус, длительность, размер ответа и текст сетевой ошибки отдельно.
Проверка результата: для каждого сбоя можно ответить, был ли запрос принят приложением. Если в access log нет записи, ищите проблему перед приложением: балансировщик, сеть, лимит соединений или очередь.
4. Проверьте цепочку по временной шкале
Сопоставьте timestamp одного запроса в access log, логах приложения, базе и внешнем сервисе. Для этого нужен идентификатор корреляции, который проходит через весь запрос. Если его нет, сначала добавьте его в тестовый контур.
Проверка результата: для нескольких неудачных запросов виден порядок событий. Например, приложение ждало базу 2,8 секунды, затем прокси прервал запрос на третьей секунде. В таком случае 504 — следствие несовпадения таймаутов, а не самостоятельная причина.
5. Повторите запуск после восстановления
Некоторые дефекты проявляются только после накопления состояния: утечки памяти, рост очереди, исчерпание пула соединений, заполнение временного диска. После остановки нагрузки подождите, пока система вернётся к исходным значениям, и повторите тот же сценарий.
Проверка результата: вы знаете, зависит ли сбой от мгновенной интенсивности или от времени работы. Если ошибка появляется через 20 минут независимо от RPS, проверяйте накопительный ресурс.
Минимальный воспроизводимый сценарий в k6
Для управляемого теста можно использовать k6 0.49.0 или более новую совместимую версию. Сценарий ниже рассчитан только на тестовый адрес: замените https://staging.example.test/health на endpoint, который безопасно вызывать многократно. Запускайте его исключительно в своём контуре.
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  scenarios: {
    steady_rate: {
      executor: 'constant-arrival-rate',
      rate: 30,
      timeUnit: '1s',
      duration: '2m',
      preAllocatedVUs: 20,
      maxVUs: 100
    }
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<500']
  }
};

export default function () {
  const response = http.get('https://staging.example.test/health');

  check(response, {
    'status is 200': (result) => result.status === 200
  });

  sleep(1);
}
Здесь задаётся постоянная скорость — 30 итераций в секунду, а не фиксированное число одновременно работающих пользователей. Это помогает проверить, выдерживает ли сервис заданный поток, но не моделирует сложный пользовательский сценарий. Перед запуском убедитесь, что endpoint не изменяет данные.
Проверка результата: k6 показывает число неудачных запросов и p95, а серверные метрики позволяют связать их с конкретным ресурсом. Если тестовый генератор сам упёрся в CPU или сеть, его показатели нельзя принимать за показатели приложения.
Что ломается первым
Точный порядок зависит от архитектуры и лимитов, но полезно проверять слои в следующей последовательности. Не ограничивайтесь графиком CPU: система может быть перегружена при 40% загрузки процессора из-за очереди или блокировок.
| Слой | Первый признак | Что проверить | Типичная ошибка |
|---|---|---|---|
| Клиент и генератор | Таймауты без записи на сервере | CPU, сеть, число открытых соединений | client timeout, connection reset |
| Прокси или балансировщик | Ошибки после фиксированного времени ожидания | upstream timeout, очередь, лимит соединений | 502, 503, 504 |
| Worker-процессы | Растёт очередь, но CPU не всегда занят | число workers, блокирующие операции, длина очереди | 502 или зависшие запросы |
| Пул базы данных | Запросы ждут соединение | занятые и свободные соединения, время ожидания | pool exhausted, timeout |
| Сама база | Растёт время SQL и блокировки | планы запросов, locks, I/O, временные файлы | медленный ответ или отказ |
| Внешний сервис | Ошибки только в сценариях с интеграцией | лимиты, retry, circuit breaker, таймауты | 429, 5xx, cascading timeout |
Если приложение запускает повторные попытки без общего дедлайна, один медленный вызов превращается в несколько. Под нагрузкой это создаёт обратную связь: очередь растёт, workers заняты ожиданием, а новые запросы получают ещё более поздний ответ.
Граничные случаи и место, где метод ломается
- Кэш скрывает проблему. Повторный запрос может не обратиться к базе. Сравнивайте холодный и прогретый кэш, но не смешивайте их в одном результате.
- Тестовый контур слишком мал. На нём не проявятся проблемы с сетевой полосой, размером пула или распределёнными блокировками. Помечайте, какие параметры отличаются от production.
- Одинаковые данные и URL искажают картину. База может обслуживать один популярный ключ из кэша, тогда как реальные запросы используют широкий набор данных.
- Логи сами создают нагрузку. Подробная синхронная запись может изменить порядок отказов. Для диагностики заранее ограничьте объём и проверьте задержку логирования.
- Ретраи маскируют первичную ошибку. Считайте исходные попытки и повторные отдельно. Иначе 1% отказов внешнего сервиса может превратиться в кратный рост внутренней нагрузки.
Метрика «ошибки за минуту» недостаточна. Разбивайте её по endpoint, коду ответа, версии приложения, зоне размещения и зависимости. Иначе редкий сбой в одном маршруте растворится в общем среднем.
Что делать после воспроизведения
Сохраните артефакт теста: конфигурацию нагрузки, версии, временной диапазон метрик, логи и несколько trace ID неудачных запросов. Затем сформулируйте одну гипотезу — например, «запросы ждут свободное соединение с базой» — и измените только один параметр.
После исправления повторите тот же профиль нагрузки, а затем добавьте ступень выше найденного порога. В production смотрите не только на 5xx, но и на p95, p99, длину очередей, время ожидания пула, число ретраев и возраст самых долгих запросов. Инвалидация кэша и подбор индексов — отдельные темы; здесь важнее сначала доказать, какой слой отказал первым.
Тест и проверочная: Быстрые ответы с объяснением, почему остальные варианты неверны
Спросить за 10 ₽Источники: Grafana k6: constant-arrival-rate executor, Prometheus: Histograms and summaries
Частые вопросы
Почему ошибка появляется только при повторном запуске?
Что проверять первым: CPU или базу данных?
Можно ли запускать такой тест на production?
Что делать, если k6 показывает ошибки, а в логах приложения их нет?
А если у меня другая версия k6 или другой генератор?
Как понять, что исправлена причина, а не симптом?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.