Проектирование импорта данных: приёмы без дублей и потерь
Импорт часто ломается не на чтении файла, а на повторном запуске, частично записанных данных и неожиданном формате источника. Разбираем, как выбрать режим загрузки, сделать процесс повторяемым и понять, где именно он остановился.
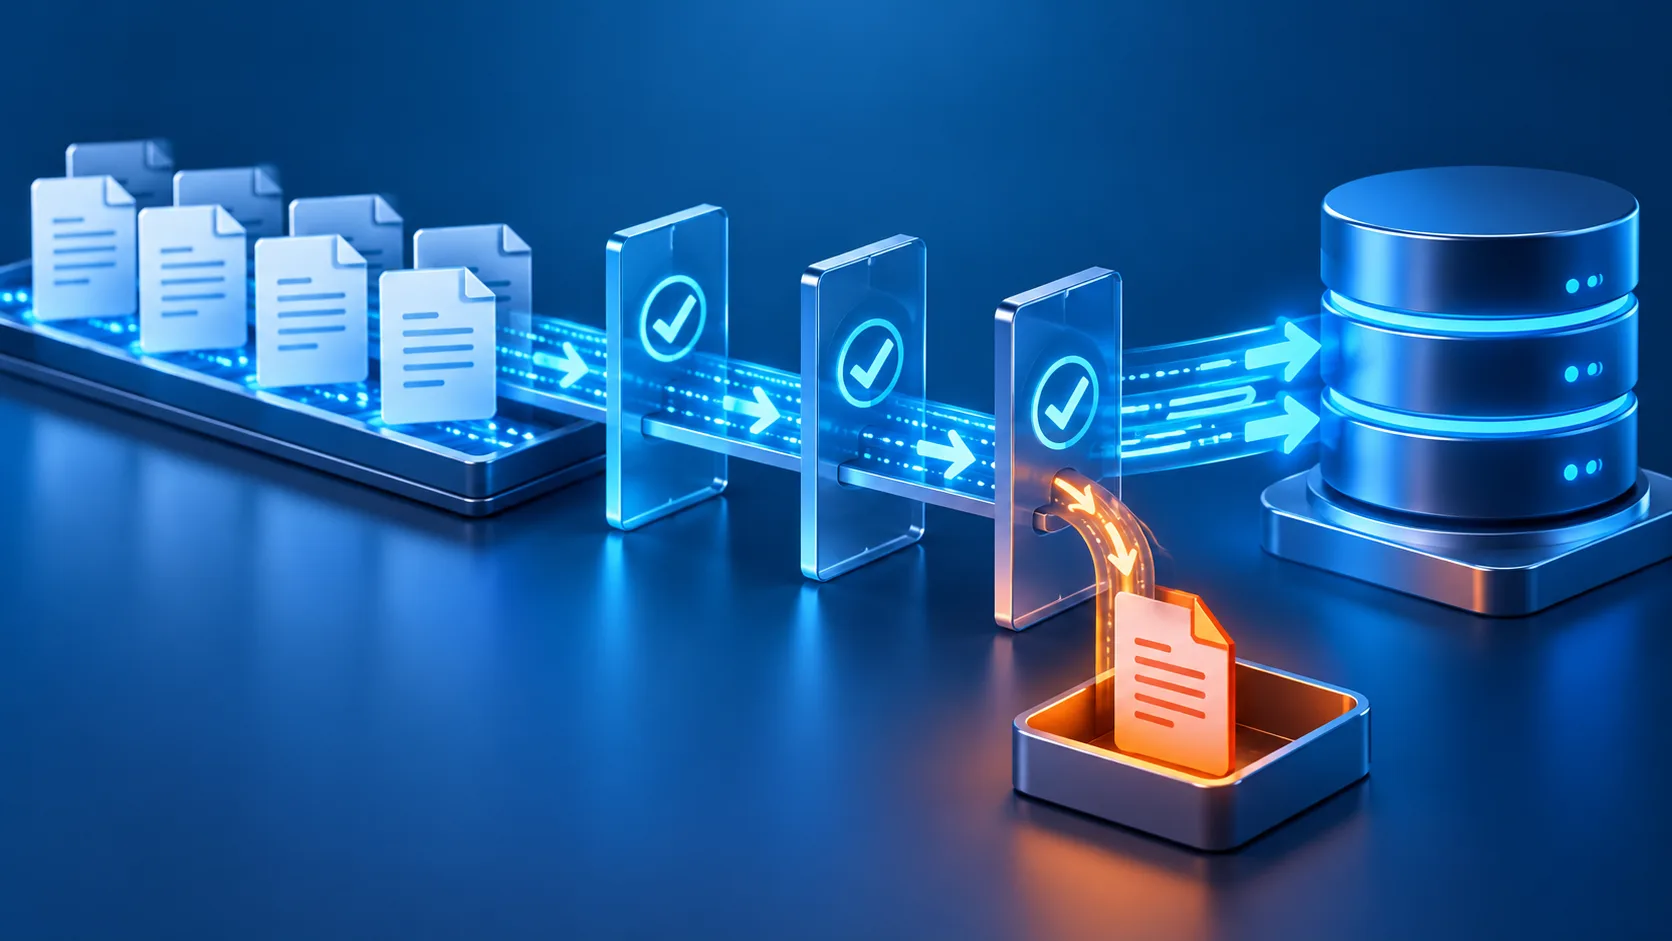
Сначала решите, что означает повторный запуск
Файл обработан, часть строк записана, соединение оборвалось — и импорт запускают снова. Если повторная обработка создаёт дубли или затирает более свежие данные, проблема не в ретраях: у процесса нет определённых правил идентификации и фиксации результата. Проектируйте импорт так, чтобы сбой можно было безопасно пережить, а не так, чтобы он «обычно проходил».
Ниже — практические решения для импорта из файлов, внешних систем и очередей. Здесь нет привязки к конкретной СУБД или библиотеке: схема таблиц, транзакционные возможности и точные гарантии зависят от выбранного стека. Код не нужен — статья о проектировании процесса, а не о вызовах конкретного API.
Разделите загрузку на этапы
Не связывайте чтение источника, проверку данных и запись в целевые таблицы в один неделимый шаг. Разделение помогает отличить испорченный вход от ошибки базы и не оставлять систему в неизвестном состоянии.
- Получить вход. Сохраните исходный файл или зафиксируйте идентификатор порции из API. Запишите, откуда пришли данные и когда началась обработка. Для большого файла полезно хранить контрольную сумму: она помогает понять, тот ли вход повторно загрузили.
- Разобрать формат. Проверьте заголовки, кодировку, разделитель и структуру. Ошибка схемы должна остановить обработку до массовой записи, а не проявиться после сотен тысяч строк.
- Проверить записи. Отделите ошибки всего набора от ошибок отдельных строк. Например, отсутствующая обязательная колонка — причина отклонить вход целиком; некорректная дата в одной записи может быть причиной поместить именно её в карантин, если бизнес-правила это допускают.
- Записать данные. Используйте выбранный режим — добавление, обновление или полную замену — и явно задайте границы транзакций.
- Зафиксировать итог. Сохраните идентификатор запуска, число прочитанных, принятых и отклонённых записей, а также состояние завершения. Успешное чтение файла ещё не означает успешный импорт.
Проверка результата на каждом этапе — не абстрактный «лог есть», а наблюдаемый факт: известна контрольная сумма входа, число разобранных строк, число записанных строк и причина отказа, если он был.
Выберите режим записи, а не надейтесь на случай
Одна и та же операция «загрузить данные» может означать три разных действия. Их нельзя безопасно подменять друг другом: ошибочный выбор меняет смысл данных, а не только скорость обработки.
| Режим | Что происходит | Цена и риск | Когда уместен |
|---|---|---|---|
| Добавление | Новые записи присоединяются к имеющимся | Повторный импорт может создать дубли; нужен способ распознать уже обработанные записи | Журнал событий или источник, где каждая запись имеет устойчивый уникальный идентификатор |
| Обновление по ключу | Запись создаётся или обновляется по бизнес-идентификатору | Неверный ключ склеит разные сущности; устаревшая запись может затереть актуальную | Снимки сущностей из внешней системы, если определены правила конфликтов и свежести |
| Полная замена | Текущий набор заменяется новым | При сбое между очисткой и загрузкой читатели могут увидеть пустые или частичные данные | Справочник или витрина, которую можно подготовить отдельно и переключить целиком |
Для обновления по ключу сначала определите, что считать одной и той же записью. Идентификатор источника обычно надёжнее имени или адреса: последние могут меняться и совпадать у разных объектов. Если источник присылает версии или время изменения, задайте правило конфликта заранее: более старая запись не должна молча победить более новую.
Повторяемость — это не обещание, что импорт никогда не упадёт. Это гарантия, что после сбоя вы знаете, что уже произошло, и можете продолжить без гадания.
Повторный запуск и частичный успех
Сетевой тайм-аут не сообщает, успела ли база сохранить запрос. Поэтому автоматический повтор без защиты от дублей опасен. Для каждой входной записи выберите устойчивый ключ, а для каждого запуска — идентификатор, по которому можно найти его состояние. Повторная обработка тогда либо обновит ту же сущность, либо будет распознана как уже выполненная.
Идемпотентность* не означает, что любая операция должна давать одинаковый результат при любых данных. Она означает, что повтор одного и того же входного действия не создаёт побочных эффектов сверх предусмотренных правил. Если вход изменился, это уже новый импорт — его нужно отличать по версии, времени или контрольной сумме.
Для частичного успеха предусмотрите отдельный путь для отклонённых строк: сохраните исходное значение, причину ошибки и идентификатор запуска. Не помещайте туда секреты или персональные данные без необходимости и контроля доступа. Если ошибка относится к общей структуре входа, останавливайте весь запуск; если к конкретной строке — решайте, допустимо ли продолжать по правилам продукта.
Размер порции — компромисс
Мелкие порции упрощают повтор и ограничивают объём незавершённой работы, но увеличивают накладные расходы на обращения к хранилищу. Крупные порции снижают число операций, зато дольше занимают транзакции и усложняют восстановление после сбоя. Универсального размера нет: он зависит от размера строк, ограничений СУБД, доступной памяти и требований к задержке.
Подбирайте размер на реалистичном наборе и фиксируйте условия измерения: объём данных, состав строк, конфигурацию хранилища, число параллельных обработчиков. Сравнивайте не только общую длительность, но и пиковое потребление памяти, задержку чтения и записи, число повторов и размер очереди отложенных записей. Не увеличивайте параллельность, пока не проверили ограничения источника и целевой базы: ускорение одного запуска может замедлить всю систему.
Что ломается первым
- Схема источника изменилась. Новая колонка может быть безвредной, а переименование обязательного поля — нет. Задайте явную политику совместимости: какие изменения допускаются, а какие останавливают загрузку.
- Порядок событий не гарантирован. Поздно доставленная старая запись перезаписывает новую. Нужны правило сравнения версий или времени и обработка конфликтов.
- Счётчики не сходятся. Число прочитанных строк не равно числу записанных: есть фильтры, дубли и ошибки валидации. Считайте эти категории отдельно и объясняйте разницу.
- Импорт запущен параллельно дважды. Один вход обрабатывают два процесса. Нужна защита от одновременной обработки одного и того же запуска — конкретный механизм выбирают с учётом СУБД и оркестратора.
- Сбой оставил промежуточные данные. Проверьте, могут ли пользователи прочитать частичный результат. Для полной замены подготавливайте новый набор отдельно и переключайте чтение после успешной проверки, если архитектура это позволяет.
Когда какой подход выбирать
Для событий с уникальными идентификаторами подходит добавление с защитой от повторов. Для регулярно обновляемых сущностей — обновление по устойчивому ключу и правилу свежести. Для небольших справочников или формируемых целиком снимков — полная замена, но только если промежуточное состояние не видно потребителям.
Перед запуском в продакшене проверьте три сценария: повтор того же входа, сбой посередине и два одновременных запуска. После каждого теста сверяйте не только статус задачи, но и фактическое состояние данных. Детали атомарной загрузки и конфликтов зависят от СУБД; например, документация PostgreSQL описывает загрузку через COPY, но выбор конкретного способа записи должен учитывать вашу версию и схему.
Что делать дальше
Возьмите один существующий импорт и составьте для него короткий контракт: формат входа, уникальный ключ, режим записи, правила ошибок и условия безопасного повтора. Затем добавьте проверку на сбой после частичной записи и замерьте время, память и число отклонённых строк на реальном объёме. Если невозможно ответить, какие данные уже попали в систему после падения, начните именно с журнала запусков и сверки счётчиков.
* Идемпотентность — свойство операции, при котором её повтор с теми же входными данными не приводит к дополнительному изменению результата.
Поиск источников: Реальные статьи и книги со ссылками, библиография по ГОСТ
Спросить за 15 ₽Источники: PostgreSQL: команда COPY, PostgreSQL: транзакции
Частые вопросы
Можно ли просто повторить импорт после тайм-аута?
Что делать, если часть строк неверная, а остальные корректны?
Какой размер порции выбрать?
Нужна ли отдельная таблица для временной загрузки?
Как не дать двум импортам обработать один файл одновременно?
Какие метрики важнее всего после запуска?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.