Агент прошёл тест — это не значит, что он готов к проду
Бенчмарки вроде SWE-bench и WebArena показывают проценты решённых задач, но лабораторный успех агента почти ничего не говорит о его поведении на живых данных и деньгах.
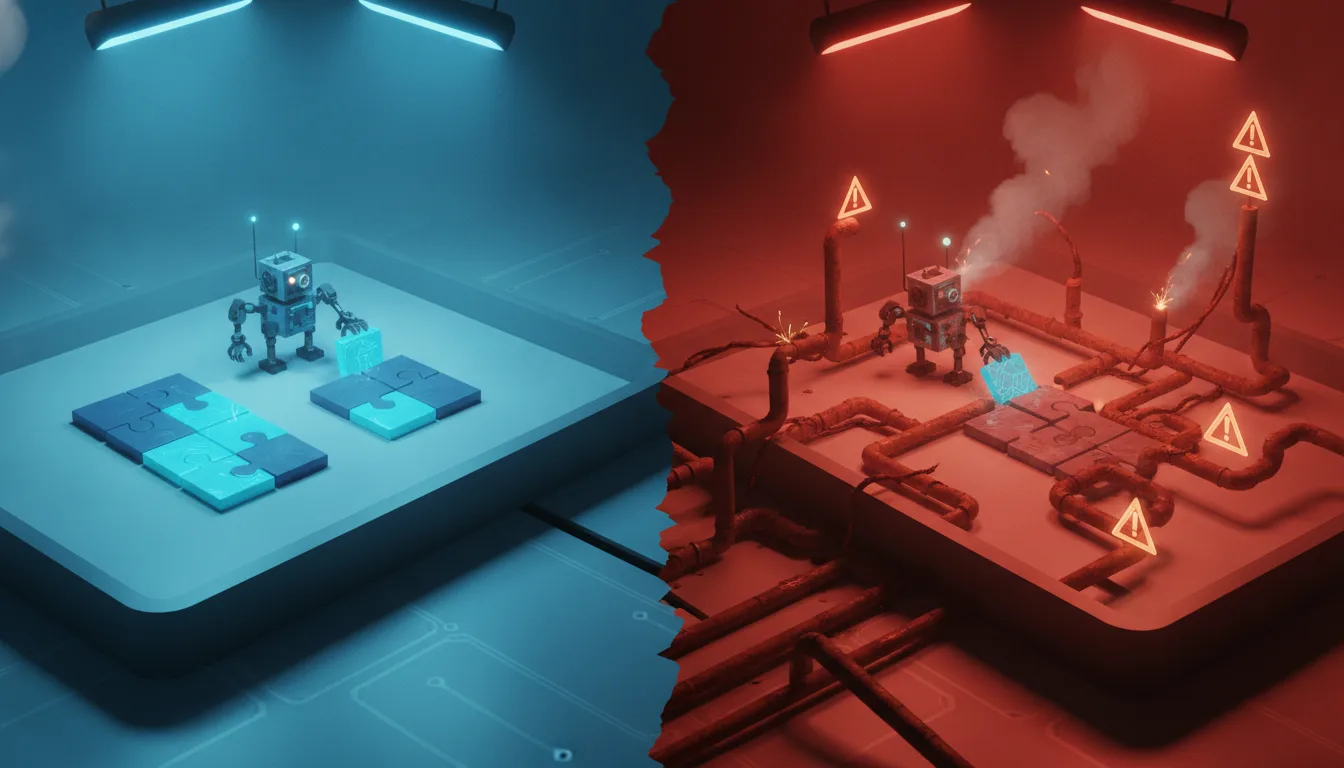
Что случилось с метриками агентов
За последний год почти каждый релиз LLM-агента сопровождается строчкой вроде «решает 70% задач SWE-bench Verified» или «обходит предыдущую версию на WebArena». Эти цифры выглядят убедительно и идут в пресс-релизы. Проблема в том, что процент на закрытом наборе задач и надёжность в продакшене — разные величины, и разница между ними стоит реальных денег: удалённого прода, списанного с карты платежа, отправленного не тому клиенту письма.
Разберём, почему «агент1 прошёл тест» — это начало проверки, а не её конец, и что именно между лабораторией и боевым контуром ломается.
Чем бенчмарк отличается от прода
Публичные бенчмарки строятся так, чтобы результат был воспроизводим и сравним. Отсюда их встроенные ограничения:
- Фиксированный набор задач. SWE-bench — это issue из открытых репозиториев с известным «правильным» патчем. В проде задачи формулирует живой человек, часто неполно и противоречиво.
- Один прогон — один результат. Бенчмарк обычно отчитывается про pass@1 или усреднённый успех. В проде важнее худший случай: что агент делает в 1% запусков, когда идёт не по плану.
- Изолированная песочница. У теста нет доступа к вашей платёжной системе, CRM и почте. У продового агента — есть.
- Утечка данных в обучение. Популярные бенчмарки со временем попадают в обучающие корпуса. Модель может «помнить» задачу, а не решать её.
Бенчмарк отвечает на вопрос «может ли модель в принципе». Прод задаёт другой: «что случится в тот раз, когда она ошибётся, и кто за это заплатит».
Где именно ломается перенос из теста в прод
Распределение задач смещается
Тестовый набор — это узкий срез. Реальные пользователи приносят формулировки, которых в наборе не было: опечатки, смешанные языки, задачи на грани компетенции агента. Метрика, снятая на чистом распределении, не предсказывает поведение на хвостах.
Композиция ошибок
Агент выполняет не один шаг, а цепочку. Если каждый шаг надёжен на 95%, то цепочка из десяти шагов даёт примерно 0.95 в десятой степени — около 60% успеха на всю задачу. Бенчмарк, измеряющий отдельные умения, скрывает этот эффект накопления.
Побочные действия
В песочнице агент, который «почти справился», просто получает более низкий балл. В проде тот же «почти» может означать отправленное письмо, изменённую запись в базе или вызванный внешний API с необратимым эффектом. Цена частичного успеха несимметрична.
Состязательная среда
Бенчмарк не пытается вас обмануть. Реальный веб — пытается. Prompt injection через содержимое страницы, подменённые инструкции в документах, вредоносные ссылки в письмах — всё это не входит в WebArena, но входит в жизнь браузерного агента.
Сравнение: что меряют популярные бенчмарки
Ниже — что именно проверяет каждый тест и чего он принципиально не проверяет. Конкретные проценты моделей меняются от релиза к релизу — сверяйте их на актуальных лидербордах, а не по памяти.
| Бенчмарк | Что меряет | Чего не меряет |
|---|---|---|
| SWE-bench Verified | Решение реальных GitHub-issue с проверкой тестами | Работу с недоописанным ТЗ, безопасность правок в чужом проде |
| WebArena | Выполнение веб-задач в самоуправляемой среде | Prompt injection, необратимые действия, платежи |
| GAIA | Многошаговые задачи с инструментами и рассуждением | Стабильность на потоке разнородных запросов |
| τ-bench (tau-bench) | Диалоговые задачи с соблюдением правил и вызовом функций | Поведение на масштабе и под нагрузкой реальных пользователей |
Ни один из этих тестов не «плохой» — они просто отвечают на свой вопрос. Ошибка не в бенчмарке, а в чтении его результата как гарантии продовой надёжности.
Что проверять перед выкатом агента
Если вы ставите агента в контур, где он совершает действия, а не только отвечает текстом, минимальный список проверок выглядит так:
- Свой оффлайн-набор. Соберите 50–200 задач из реальных логов, а не из публичного бенчмарка. Именно на них меряйте.
- Худший случай, а не средний. Смотрите, что агент делает в проваленных прогонах: молча ошибается или ломает данные.
- Разграничение прав. Необратимые действия (платёж, удаление, отправка) — через подтверждение или отдельный сервис с лимитами.
- Тест на инъекции. Прогоните агента на страницах и документах с вредоносными инструкциями внутри контента.
- Логи и откат. Каждое действие агента должно быть воспроизводимо и обратимо, иначе разбор инцидента невозможен.
- Канареечный выкат. Сначала на малую долю трафика с человеком в контуре, потом расширение.
Кому это пригодится, а кому нет
Пригодится тем, кто:
- ставит агента на задачи с побочными эффектами — работа с кодом, оплаты, рассылки, изменения в CRM;
- выбирает модель для продукта по лидербордам и хочет понять, что цифра реально обещает;
- отвечает за инцидент, если агент сделает лишнее — тимлид, продакт, инженер по надёжности.
Можно расслабиться тем, кто:
- использует агента как ассистента-подсказчика, где человек всегда проверяет результат перед применением;
- работает в закрытой песочнице без доступа к деньгам, проду и внешним данным;
- прототипирует, а не выкатывает на пользователей.
Граница простая: чем ближе агент к необратимым действиям и чужим деньгам, тем меньше веса имеет строчка из пресс-релиза и тем больше — ваш собственный оффлайн-набор и разграничение прав.
1 Агент — LLM, которой дали инструменты (браузер, API, файловую систему) и цикл, в котором она сама планирует и выполняет шаги, а не просто отвечает на один запрос. Именно наличие действий, а не текста, делает вопрос безопасности острым.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: SWE-bench: официальный сайт и лидерборд, WebArena: A Realistic Web Environment for Building Autonomous Agents
Частые вопросы
Значит ли высокий процент на SWE-bench, что агент хорошо пишет код в моём проекте?
Могут ли бенчмарки завышать результат из-за утечки данных?
Что такое prompt injection и почему обычные тесты его не ловят?
Почему цепочка из надёжных шагов может давать ненадёжный результат?
Как безопасно выкатывать агента с необратимыми действиями?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.