Энергетические функции: как модель учит понятия без меток
Energy-based модели присваивают каждой комбинации данных число — энергию. Правильные сочетания получают низкую энергию, абсурдные — высокую. На этом строится способ обучать понятия без явных ярлыков.
Что такое энергия в машинном обучении
Обычная классификационная сеть выдаёт вероятность: этот снимок — кошка на 0,93. Energy-based модель (EBM) работает иначе. Она принимает пару «вход и предполагаемый ответ» и выдаёт одно число — энергию. Чем ниже энергия, тем лучше ответ согласуется со входом. Обучение сводится к тому, чтобы правильные пары получали низкую энергию, а неправильные — высокую.
Идея не новая: её продвигал Ян Лекун ещё в середине 2000-х как альтернативу вероятностному подходу. Разница принципиальная. Вероятностная модель обязана нормировать выход так, чтобы сумма по всем возможным ответам равнялась единице — это дорогая операция, когда вариантов ответа бесконечно много. EBM от нормировки отказывается: ей достаточно относительного порядка энергий, а не корректных вероятностей.
Где здесь понятия
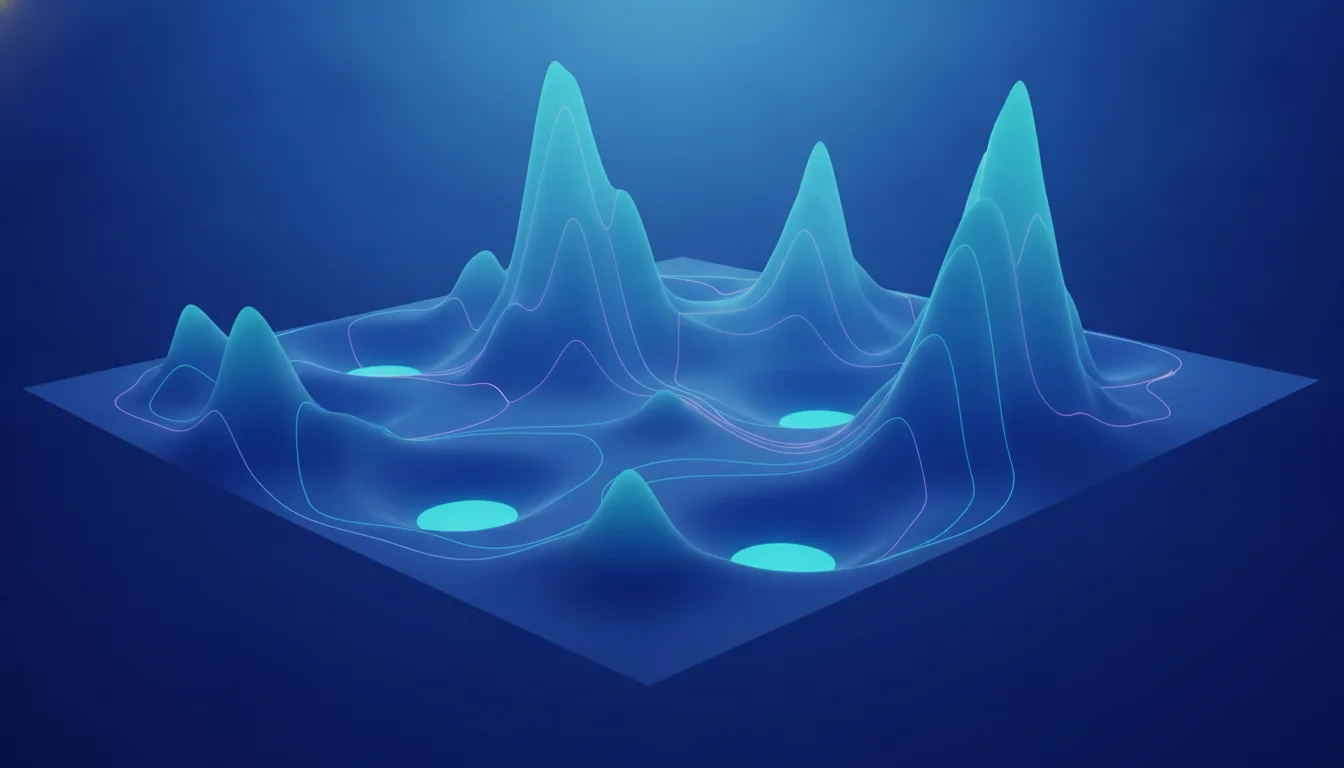
«Понятие» в этом контексте — не философская категория, а область в пространстве данных, где энергия низкая. Модель, обученная на изображениях стульев, формирует энергетический ландшафт: конфигурации пикселей, похожие на стул, лежат в долинах, всё остальное — на возвышенностях. Само понятие «стул» — это форма долины, а не отдельный нейрон с ярлыком.
Отсюда вытекает интересное свойство: понятия можно комбинировать арифметикой энергий. Если у вас есть функция энергии для «красного» и функция для «квадрата», их сумма задаёт ландшафт для «красного квадрата» — без единого примера красных квадратов в обучении. Композиция получается почти бесплатно, потому что энергии просто складываются.
Вероятностная модель отвечает на вопрос «насколько это вероятно». Энергетическая — на вопрос «насколько это совместимо». Второй вопрос честнее, когда правильных ответов много и они равнозначны.
Как это обучается
Главная сложность EBM — заставить модель поднимать энергию там, где данных нет. С низкой энергией на реальных примерах проблем нет: их показывают напрямую. А вот «негативные» примеры — правдоподобные, но неверные конфигурации — нужно откуда-то брать. Основной инструмент называется контрастивным обучением1.
- Позитивная фаза. Берём реальный пример из данных и опускаем его энергию — сдвигаем параметры так, чтобы число на выходе стало меньше.
- Негативная фаза. Генерируем «фейковый» пример — обычно методом Ланжевеновской динамики, когда из случайного шума спускаются по градиенту энергии в сторону низких значений. Этому сгенерированному образцу энергию, наоборот, поднимаем.
- Баланс. Модель сходится, когда сгенерированные примеры становятся неотличимы от реальных: обеим группам присваивается одинаково низкая энергия, и толкать больше некуда.
Ланжевеновская динамика — это градиентный спуск с добавленным случайным шумом на каждом шаге. Шум не даёт застрять в одной долине и позволяет исследовать разные области ландшафта. На практике сэмплирование медленное: чтобы получить один приличный негативный пример, нужны десятки, иногда сотни шагов.
Чем это отличается от диффузионных моделей
Диффузионные генераторы вроде Stable Diffusion идейно близки: они тоже учатся восстанавливать данные из шума и по сути оценивают градиент логарифма плотности — так называемый score. Score-based и energy-based подходы связаны напрямую: score — это градиент отрицательной энергии. Разница в акцентах. Диффузия оптимизирована под генерацию картинок и обучается стабильнее. EBM гибче в композиции понятий и рассуждении, но капризнее в обучении.
| Свойство | Вероятностная модель | Energy-based модель |
|---|---|---|
| Выход | Нормированная вероятность (сумма = 1) | Ненормированная энергия (любое число) |
| Нормировка | Обязательна, часто дорогая | Не нужна |
| Композиция понятий | Через сложные приёмы | Сложением энергий |
| Скорость обучения | Обычно быстрее | Медленнее из-за сэмплирования |
| Генерация образцов | Прямая или через декодер | Итеративный спуск по энергии |
Зачем это нужно на практике
Энергетический подход интересен не тем, что бьёт рекорды точности на бенчмарках — обычно не бьёт. Ценность в другом.
- Композиция без переобучения. Складывая энергии концептов, вы получаете новые понятия без сбора новых данных. Это исследовали, в частности, в работах группы Игоря Мордача и Ючуаня Ду про композиционную генерацию.
- Единый механизм для генерации и распознавания. Одна и та же функция энергии умеет и оценивать, насколько пример реален, и порождать новые примеры спуском по ландшафту.
- Естественная работа с несколькими правильными ответами. Если у задачи много одинаково верных решений, вероятностная модель размазывает массу и выдаёт усреднённую кашу. EBM формирует несколько отдельных долин.
- Основа для рассуждения. Поиск конфигурации с минимальной энергией — это форма вывода. Модель не просто предсказывает следующий токен, а ищет ответ, максимально согласованный со всеми ограничениями сразу.
Практический минус честнее назвать сразу: обучать EBM тяжело. Негативная фаза нестабильна, сэмплирование медленное, гиперпараметры чувствительны. Именно поэтому в продакшене доминируют диффузионные и авторегрессионные модели, а энергетические живут в основном в исследованиях. Но идея энергетического ландшафта проникает в мейнстрим — тот же Лекун продвигает архитектуры JEPA, где предсказание строится в пространстве представлений, а не пикселей, и опирается ровно на энергетическую логику совместимости.
Если вы строите систему, где важна композиция понятий или множественность правильных ответов, EBM стоит держать в поле зрения — хотя бы как способ думать о задаче. Начать проще всего с чтения оригинальных заметок Лекуна и разборов контрастивного обучения, а не с попытки обучить большую энергетическую модель с нуля.
1 Контрастивное обучение — метод, при котором модель учится различать «настоящие» и «поддельные» примеры, сближая представления похожих объектов и раздвигая непохожие.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: Yann LeCun et al. A Tutorial on Energy-Based Learning, Yang Song. Generative Modeling by Estimating Gradients of the Data Distribution
Частые вопросы
Чем энергия отличается от вероятности?
Почему EBM обучать сложнее, чем обычную сеть?
Связаны ли энергетические модели с диффузионными?
Можно ли комбинировать выученные понятия?
Используют ли EBM в реальных продуктах?
С чего начать изучение темы?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.