Gemini Robotics 2: как модель управляет роботом целиком
Google DeepMind показал новое поколение робо-моделей семейства Gemini Robotics. Главное обещание — управление всем корпусом робота, а не отдельными манипуляторами.
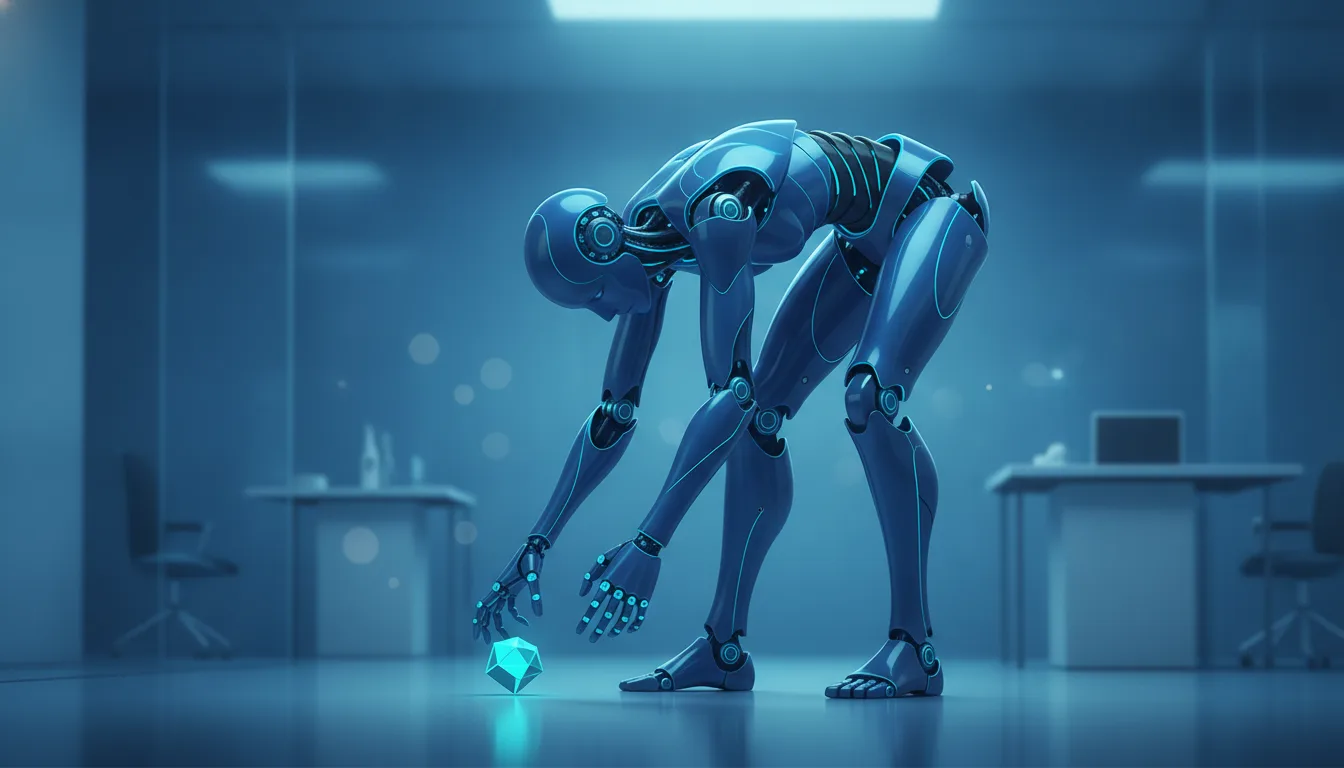
Google DeepMind в 2025 году развивает линейку Gemini Robotics — семейство моделей, которые переносят рассуждения больших языковых моделей в физический мир: робот видит сцену, понимает команду на естественном языке и планирует действия. Ключевая идея нового витка — так называемый whole body control, управление роботом как единым целым: не только захватом или рукой, но и корпусом, положением, перемещением. Ниже разбираем, что это меняет на практике, где проходит граница между демо и рабочим внедрением и на какие цифры стоит смотреть скептически.
Что стоит за формулировкой «whole body intelligence»
Классический промышленный робот годами делал одно движение по жёсткой программе. Модели вроде Gemini Robotics меняют подход: вместо ручного программирования траекторий робот получает задачу словами и сам решает, как её выполнить. VLA-модель (см. сноску) связывает картинку с камеры, текстовую команду и команды на приводы.
«Whole body» в этой логике означает, что модель управляет не изолированным манипулятором, а координирует несколько степеней свободы сразу — например, наклон корпуса, чтобы дотянуться до дальнего предмета, вместо того чтобы двигать только рукой. Для человека это очевидно: чтобы поднять что-то с пола, вы приседаете, а не тянетесь одной кистью. Для робота согласовать десятки суставов в одном движении — вычислительно и алгоритмически сложная задача.
Разница между «управлять рукой» и «управлять телом» — примерно как между печатью одним пальцем и слепой печатью всеми десятью. Итог тот же, цена движения — разная.
Почему это не просто маркетинг
Ценность координации всего корпуса измеряется в двух вещах: какие задачи вообще становятся выполнимыми и насколько устойчиво робот работает вне лаборатории. Узкая манипуляция «взять кубик со стола» решалась и раньше. Сложность начинается там, где предмет тяжёлый, далеко, в неудобной позе или сцена меняется на ходу. Здесь координация корпуса, баланса и захвата даёт роботу больше способов достичь цели.
Что реально известно, а что стоит проверять
Вокруг робо-моделей много красивых видео, и это главная ловушка. Демонстрация показывает лучший дубль, а не среднюю надёжность в цеху или на складе. Прежде чем делать выводы, разделяйте три вещи.
- Что показано в демо — отдельные успешные выполнения задач в контролируемой обстановке.
- Что заявлено в бенчмарках — метрики обобщения на новые объекты и сцены; их стоит смотреть в оригинальной публикации, а не в пересказе.
- Что доступно вам — API, партнёрская программа, конкретные модели роботов и цена доступа.
Конкретные названия версий, доступность через API, список партнёров-производителей роботов и точные метрики я намеренно не привожу цифрами по памяти: эти данные быстро устаревают и часто различаются между анонсом и публичным релизом. Их нужно сверять в официальном блоге Google DeepMind и в сопроводительной технической документации на момент, когда вы это читаете.
Как устроен рынок вокруг
DeepMind здесь не в вакууме. Направление VLA-моделей и «фундаментальных моделей для роботов» развивают и другие команды и стартапы. Общая ставка одна: одна универсальная модель, которую можно адаптировать под разные корпуса роботов, вместо отдельного софта под каждую железку.
| Подход | Как задаётся поведение | Гибкость к новым задачам |
|---|---|---|
| Классическое программирование траекторий | Инженер прописывает движения вручную | Низкая: новая задача — новая программа |
| Обучение под узкую задачу | Датасет под конкретную операцию | Средняя внутри домена |
| Фундаментальная VLA-модель | Команда на естественном языке плюс камера | Высокая по замыслу, ограничена реальной надёжностью |
Что это значит для тех, кто следит за темой
Если вы разработчик или планируете внедрение, практический интерес представляют не эффектные ролики, а ответы на приземлённые вопросы.
- Через что доступна модель — открытый API, закрытая программа или только исследовательский релиз.
- С какими корпусами роботов она совместима и нужна ли дообучка под ваше железо.
- Какая заявлена частота управления и латентность — для реального времени это критично.
- Как решены вопросы безопасности: что делает робот при сбое или неоднозначной команде.
- Сколько это стоит и на каких условиях, включая коммерческое использование.
Пока индустрия ещё не прошла путь, который в своё время прошли облачные API для текста: универсальный, дешёвый и предсказуемый доступ к физическому интеллекту роботов остаётся впереди, а не позади. Whole body control — важный шаг именно потому, что расширяет класс достижимых задач. Но перенос из лаборатории на склад или в дом по-прежнему упирается в надёжность, безопасность и стоимость.
VLA (vision-language-action) — класс моделей, которые на входе принимают изображение и текстовую команду, а на выходе выдают действия для приводов робота, а не текст.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: Google DeepMind — Robotics
Частые вопросы
Чем Gemini Robotics отличается от обычной языковой модели?
Что означает whole body control простыми словами?
Можно ли уже сейчас купить доступ к модели?
Насколько надёжно это работает вне демо-роликов?
Заменит ли это классических промышленных роботов?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.