Границы сервисов: как устроено разделение внутри системы
Сервисная граница — это не отдельный репозиторий и не контейнер в Kubernetes. Это место, где система делит данные, ответственность и цену сбоя. Разбираем, что происходит внутри вызова и где проходит рабочая граница.
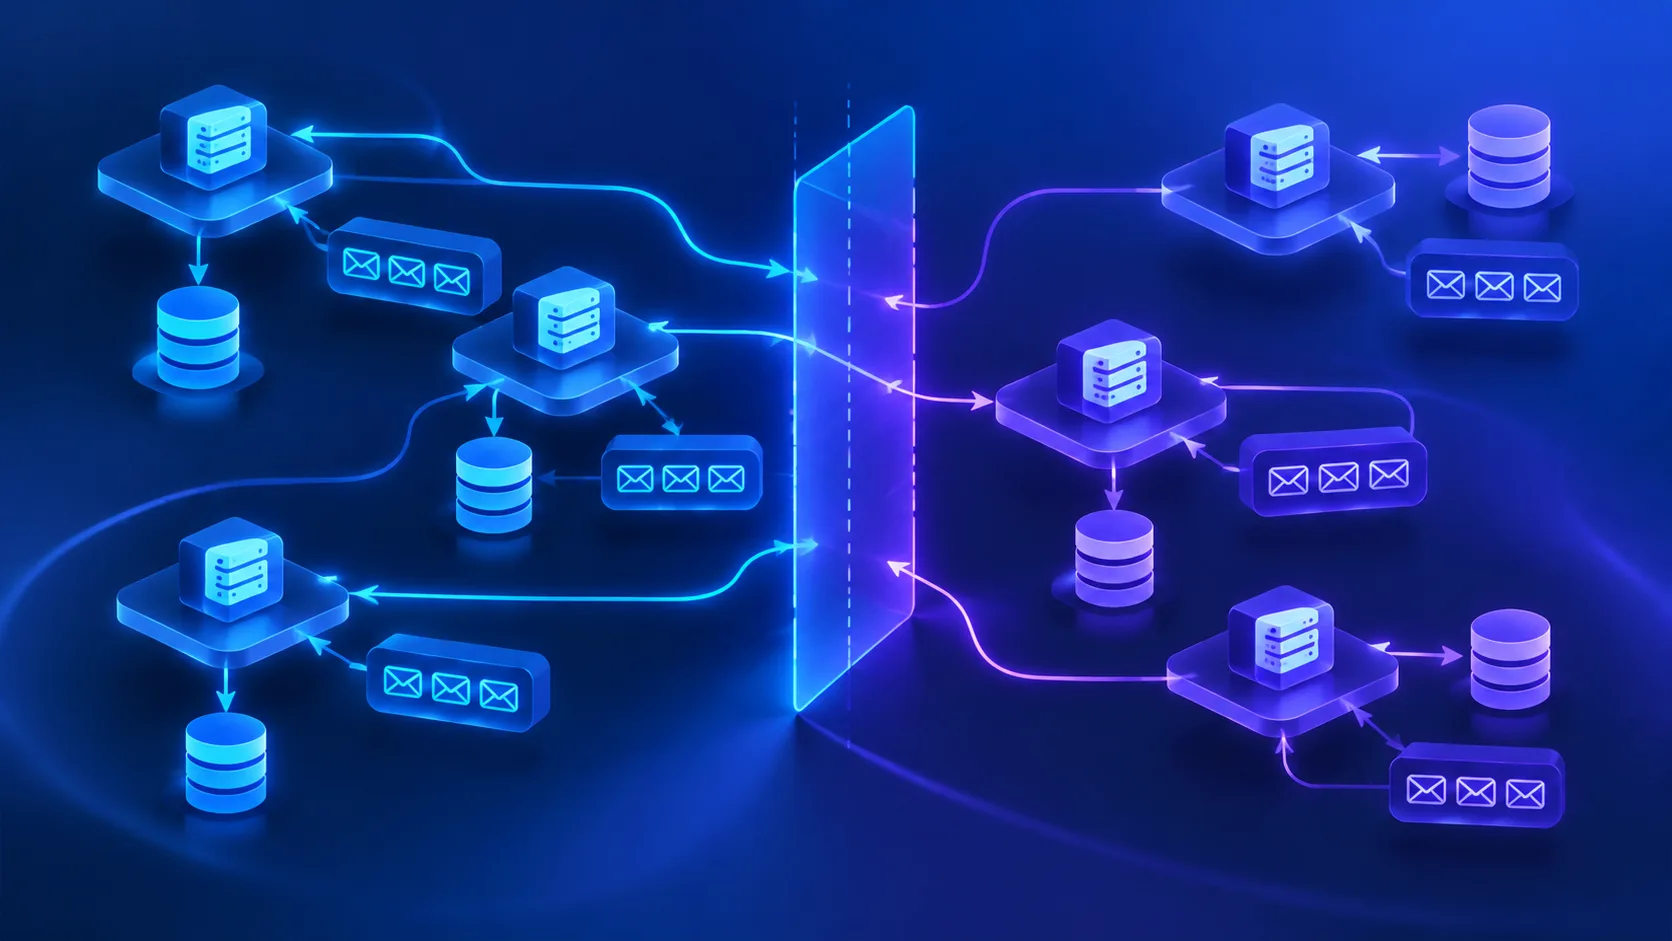
Когда один пользовательский запрос проходит через пять сервисов, задержка и отказ одного из них становятся проблемой всей цепочки. Граница сервиса определяет, кто владеет данными, где начинается транзакция, как передаётся ошибка и сколько компонентов придётся менять при новом бизнес-правиле. Поэтому делить систему по папкам или по таблицам недостаточно: рабочая граница проходит между обязанностями и контрактами.
Что на самом деле отделяет один сервис от другого
Сервис — это не обязательно отдельный процесс. На раннем этапе им может быть модуль внутри монолита, а позже — самостоятельное приложение. Существенны четыре свойства:
- собственная ответственность — сервис принимает решения в одной области, а не пересылает вызовы дальше;
- владение данными — другие части системы не меняют его таблицы напрямую;
- контракт — HTTP API, очередь событий или другой явно описанный способ общения;
- локальная отказоустойчивость — сбой соседа не должен автоматически превращать сервис в неисправный.
Если два приложения используют одну базу и свободно обновляют таблицы друг друга, перед вами скорее распределённый монолит. Процессы разделены, а правила и связность остались общими.
Граница сервиса — это не линия между репозиториями. Это договор о том, кто имеет право принимать решение и менять данные.
Данные принадлежат не таблице, а правилам
Представьте интернет-магазин. Заказы, платежи и остатки могут храниться в одной СУБД, но это ещё не говорит, где проходит граница. Важнее другое: кто решает, можно ли отменить заказ, кто резервирует товар и кто подтверждает оплату.
Если сервис доставки напрямую меняет статус заказа в таблице orders, он получает не только доступ к данным, но и скрытую зависимость от всех ограничений заказа. Изменение схемы, статуса или правила отмены начинает требовать синхронной правки нескольких приложений.
Более устойчивая схема выглядит иначе: сервис заказов принимает команду на отмену, проверяет собственные правила и публикует событие. Сервис склада реагирует на событие по своему контракту. Платёжный сервис не читает таблицы заказа, а получает только необходимые ему сведения.
Событие1 сообщает, что факт уже произошёл. Команда просит другой сервис выполнить действие. Подмена одного другим создаёт путаницу: подписчик может воспринять просьбу как свершившийся факт.
Как запрос проходит через границу
У синхронного вызова есть несколько независимых этапов: клиент отправляет запрос, пограничный сервис проверяет контракт, вызываемый сервис читает свои данные, принимает решение и возвращает результат. На каждом этапе могут возникнуть задержка, повтор, тайм-аут или частичный успех.
Главная ловушка — считать сетевой вызов обычным вызовом функции. Функция обычно завершается или возвращает ошибку в рамках одного процесса. Межсервисный вызов зависит от сети, DNS, балансировщика, лимитов соединений и загрузки удалённого сервиса. У него должны быть тайм-аут, понятная политика повторов и наблюдаемая корреляция запроса.
Синхронный запрос и асинхронное событие
| Механизм | Когда подходит | Цена и риск |
|---|---|---|
| Синхронный API | Нужен немедленный ответ: цена, наличие, результат проверки | Задержка и отказ вызываемого сервиса попадают в пользовательский запрос |
| Событие через брокер | Изменение нужно доставить нескольким потребителям независимо | Появляются повторная доставка, задержка и необходимость идемпотентной обработки |
| Команда через очередь | Операцию можно выполнить позже, а клиенту достаточно статуса принятия | Сложнее объяснить пользователю итог и отслеживать зависшие сообщения |
Нельзя выбрать асинхронность только ради меньшей связанности. Если пользователь должен получить точный ответ до завершения операции, очередь лишь переносит проблему и добавляет состояние «результат ещё не готов».
Где граница ломается первой
Общая база
Общая база ускоряет старт: проще делать отчёты, миграции и транзакции. Но она связывает сервисы схемой и блокировками. Особенно опасны прямые записи в чужие таблицы и запросы, которые объединяют данные нескольких владельцев.
Безопасный промежуточный вариант — одна СУБД с разделением по схемам и запретом чужой записи. Это не превращает систему в независимые сервисы, но делает зависимости видимыми и облегчает последующее разделение.
Транзакция через несколько сервисов
Распределённая транзакция редко является хорошим способом сохранить привычную атомарность. Между сервисами чаще используют последовательность локальных транзакций и компенсацию: один сервис фиксирует действие, публикует факт, а следующий либо применяет его, либо сообщает об ошибке.
Такой подход не делает операцию мгновенно согласованной. На короткое время интерфейс может показать заказ в состоянии «оплата ожидается», а остаток — в состоянии «резерв проверяется». Это не баг, если переходы и повторная обработка описаны явно.
Повторы и частичные сбои
Повтор запроса может создать двойной платёж, два резерва или два письма. Для операций, которые должны применяться один раз по смыслу, нужен идемпотентный ключ: сервис сохраняет факт обработки и возвращает тот же результат при повторе. Конкретный формат ключа зависит от протокола и домена, но правило одно: повтор должен быть безопасным, а не просто быстрым.
Отдельно проектируют:
- тайм-аут на каждый исходящий вызов;
- ограничение числа повторов и задержку между ними;
- очередь или журнал для сообщений, которые не удалось обработать;
- метрики ошибок, задержки и размера очереди;
- трассировку одного пользовательского запроса через все сервисы.
Как проверить границу до выделения отдельного сервиса
Сначала соберите карту изменений, а не карту классов. Возьмите несколько реальных сценариев: создание заказа, возврат, изменение цены, отмена платежа. Для каждого запишите, какие правила меняются, какие данные читаются и кто принимает решение.
- Найдите слова и команды бизнеса. Если одна группа правил постоянно меняется вместе, вероятно, ей нужна общая граница.
- Назначьте владельца каждой записи. Укажите, какой компонент может изменить заказ, платёж, остаток или профиль.
- Опишите контракты. Для каждого вызова зафиксируйте вход, успешный результат, ошибки, тайм-аут и поведение при повторе.
- Смоделируйте отказ. Остановите зависимость и ответьте, что увидит клиент, где сохранится незавершённая операция и кто выполнит повтор.
- Сверьте границу с командой. Если для одного изменения приходится синхронно править несколько сервисов, разделение, вероятно, слишком мелкое или выбрано не по бизнес-правилам.
После этого измерьте систему на реальном профиле нагрузки. Зафиксируйте процент ошибок, p95 и p99 задержки, число исходящих вызовов на запрос, долю повторов, глубину очередей и время восстановления. Без исходных данных о железе, объёме запросов и параллельности универсальные цифры «до и после» ничего не доказывают.
Как понять, что сервис выделен неправильно
- каждый пользовательский запрос требует длинной цепочки синхронных вызовов;
- команды не могут выпустить сервис отдельно из-за общей миграции базы;
- одни и те же поля копируются в несколько хранилищ, но правила синхронизации не определены;
- сервис почти не принимает решений и только проксирует запросы;
- для исправления одной бизнес-ошибки приходится менять контракты сразу в нескольких командах.
Разделять нужно не всё подряд. Иногда модульный монолит с чёткими владельцами данных лучше десятка маленьких сервисов: меньше сетевых отказов, проще локальная транзакция и дешевле сопровождение. Микросервисная граница оправдана, когда различаются темп изменений, требования к масштабированию, права доступа или ответственность команд.
Что делать дальше
Выберите один сквозной сценарий и нарисуйте его цепочку: команда, сервис-владелец, локальная транзакция, событие, повтор и конечный статус. Затем добавьте к каждому межсервисному вызову тайм-аут, метрику и идентификатор трассировки. Следующим шагом проверьте сценарий отключением одной зависимости: система должна не только сообщить об ошибке, но и сохранить понятный путь восстановления.
Аналитик звонков: Разбор записи звонка по этапам сделки: где сорвалось, что упущено, три исправляемые рекомендации с цитатами.
Спросить за 90 ₽Источники: Microservices Architecture — Microsoft Azure Architecture Center, Microservices — Martin Fowler
Частые вопросы
Нужно ли делать каждый сервис отдельным контейнером?
Можно ли оставить одну базу данных для всех сервисов?
Что будет, если один сервис не успеет ответить в срок?
Как избежать двойной обработки сообщения?
Изменится ли подход в другой версии фреймворка или брокера?
Что проверить в проде после разделения сервиса?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.