Инструменты статического анализа в Git под нагрузкой
Линтеры, типизаторы и SAST находят ошибки до запуска кода, но не видят очередь запросов, исчерпание пула соединений и гонки. Разбираем, что ломается первым в Git-процессе и как измерять цену проверок.
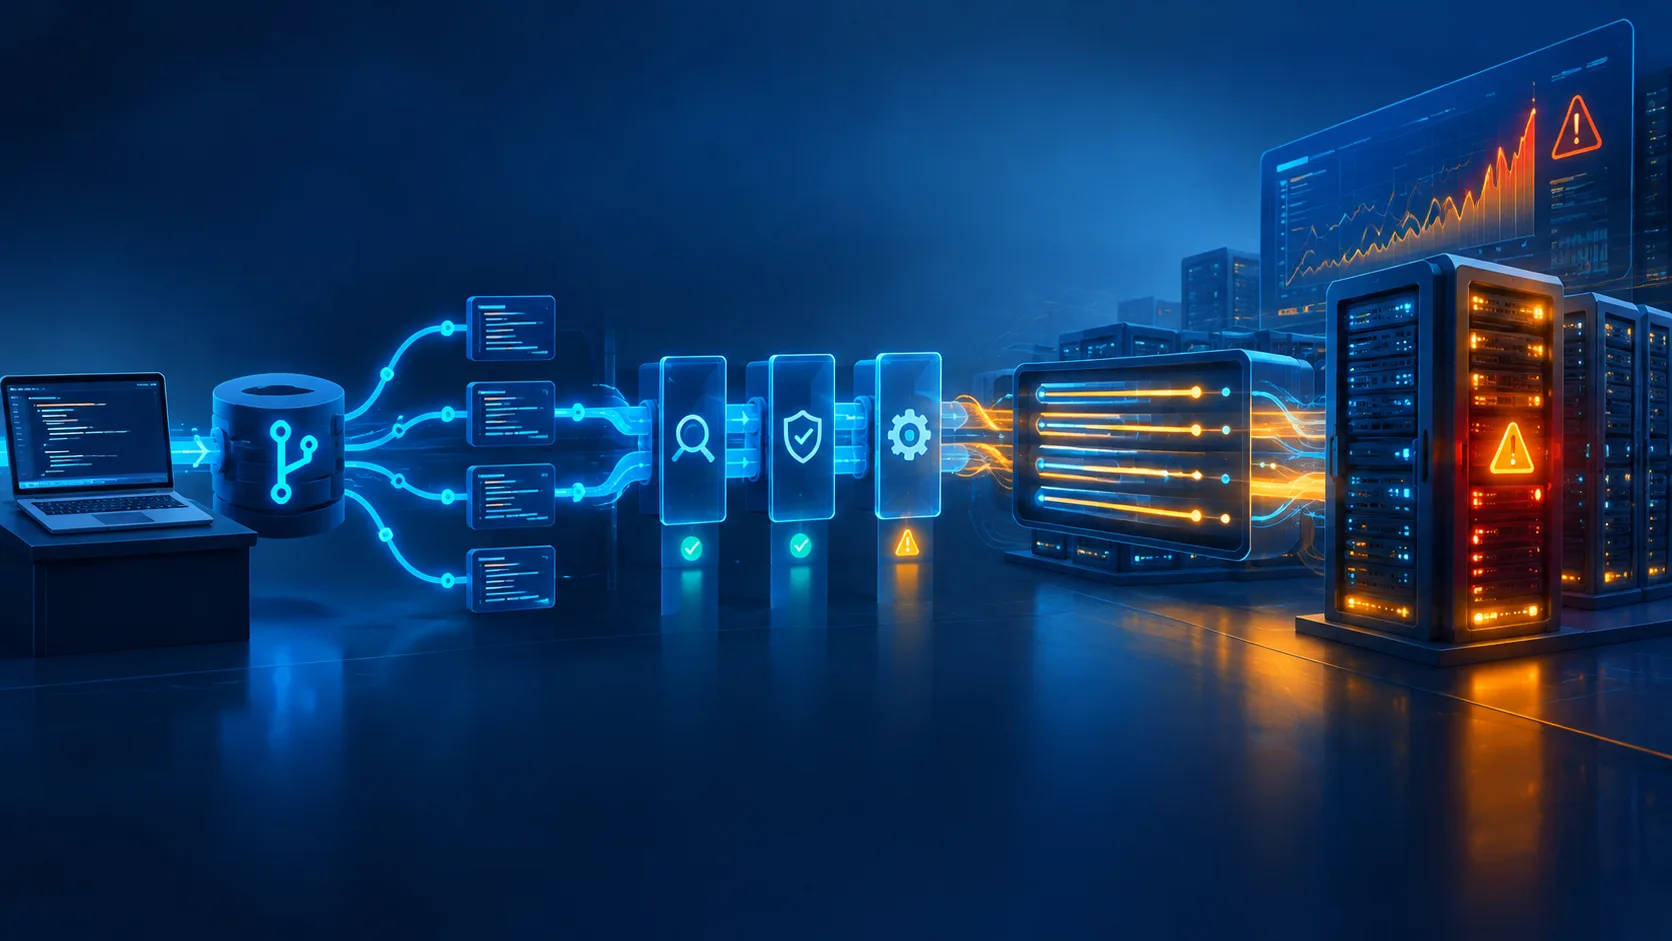
Статический анализ часто ставят первым барьером в Git: Ruff или ESLint проверяют стиль, mypy — типы, Semgrep — опасные конструкции, а CI не пускает ветку дальше после ошибки. Но под нагрузкой ломается обычно не сам анализатор. Сначала растёт очередь сборок, затем проверки начинают пропускать изменения из-за слишком узкого diff, а последними обнаруживаются проблемы, которых статический код-анализ принципиально не видит: таймауты, конкуренция за блокировки и исчерпание пулов. Ниже — разбор для Git 2.43+, GitHub Actions и инструментов веток Semgrep OSS 1.x, Ruff 0.11.x и mypy 1.15.x.
Что именно проверяет Git-пайплайн
Git сам по себе не анализирует исходники. Он хранит изменения и запускает хуки, если вы подключили их отдельно. Проверки появляются на трёх уровнях: локально перед коммитом, в CI после push или pull request и на этапе сборки релиза.
Статический анализ — проверка исходного кода без его выполнения. Инструмент строит собственную модель файлов, импортов, типов или потоков данных и ищет известные паттерны ошибок.
У каждого слоя своя цена. Локальный hook даёт быстрый сигнал, но его можно обойти. CI видит чистое окружение и защищённую ветку, однако конкурирует за CPU и время с другими сборками. SAST ищет классы уязвимостей, но не знает, сколько запросов одновременно обслуживает приложение.
Статический анализ отвечает на вопрос «может ли в коде быть такая ошибка». Нагрузочный тест отвечает на другой вопрос: «что произойдёт, когда эту ошибку начнут эксплуатировать одновременно сотни клиентов».
Что ловят разные инструменты
| Инструмент и слой | Что обычно находит | Что остаётся за пределами проверки | Цена под нагрузкой |
|---|---|---|---|
| Ruff 0.11.x или ESLint актуальной ветки | Синтаксические и стилевые нарушения, часть очевидных ошибок, неиспользуемые импорты | Медленный SQL, гонки, неверные таймауты, деградацию внешнего API | Время CPU и очередь jobs при полном проходе монорепозитория |
| mypy 1.15.x или другой статический типизатор | Несовпадение типов, часть недостижимых веток, ошибки контрактов между модулями | Неверные данные из базы, переполненный кэш, блокировки и сетевые сбои | Память на больших графах импортов и время проверки изменившихся пакетов |
| Semgrep OSS 1.x | Опасные вызовы, подозрительные конструкции, отдельные пути прохождения данных | Реальную конфигурацию продакшена, распределённые гонки, насыщение CPU | Количество правил, глубина анализа и размер рабочей копии |
| Git hook | Нарушение локального минимального набора правил до коммита | Изменения без hook, push из другого клиента, поведение сервиса | Задержка каждого коммита и раздражение разработчика |
| CI на pull request | Воспроизводимый набор проверок для конкретного изменения | Нагрузочную динамику и ошибки, возникающие только в продакшене | Очередь раннеров, лимиты параллельных jobs и стоимость минут CI |
Таблица показывает важную границу: «статический» не означает «полный». Инструмент может доказать нарушение правила, но не доказать хорошую работу сервиса под трафиком.
Что ломается первым в Git-процессе
1. Локальные хуки перестают быть источником истины
Hook удобен для быстрых проверок, но Git не заставляет всех разработчиков запускать одинаковую конфигурацию. Его можно не установить, отключить или обойти коммитом без запуска hook. Он также работает на машине разработчика, где могут отличаться версия Python, Node.js, правила линтера и набор зависимостей.
Поэтому локальная проверка — ускоритель обратной связи, а не контроль безопасности. Обязательным барьером должна оставаться проверка в защищённой ветке CI.
2. Diff-only анализ пропускает контекст
При росте числа pull request полный анализ репозитория становится дорогим, и команда ограничивает его изменёнными файлами. Это сокращает время проверки, но создаёт слепую зону: новая функция может использовать старый небезопасный модуль, а изменение конфигурации — менять поведение десятков неизменённых файлов.
Решение не в том, чтобы всегда проверять только весь репозиторий. Разделите проверки:
- быстрый анализ изменённых файлов — на каждый pull request;
- проверка зависимостей, типов и межмодульных связей — для затронутого пакета или сервиса;
- полный прогон — по расписанию и перед релизом;
- нагрузочные и интеграционные тесты — в отдельном окружении, близком к продакшену.
3. CI упирается в очередь, а не в скорость правила
Даже быстрый линтер становится проблемой, когда десятки pull request запускают одинаковые jobs параллельно. Первым симптомом будет не ошибка анализатора, а рост времени ожидания раннера. Разработчик видит старый результат позже, чем успевает изменить код, и начинает повторно запускать проверки. Так очередь растёт ещё быстрее.
Измеряйте не только длительность команды. Нужны четыре значения: время ожидания job в очереди, время подготовки окружения, время самого анализа и доля повторных запусков. Без такого разбиения нельзя понять, помогает ли оптимизация правил или вы просто добавили раннеров.
4. Полный анализ начинает съедать память
Типизаторы и SAST строят графы импортов и потоки данных. В монорепозитории их размер зависит не только от числа изменённых строк, но и от связности пакетов. Добавление одного общего модуля может расширить область анализа для множества сервисов.
Здесь опасно лечить проблему увеличением лимита памяти без замера. Если процесс CI завершается с кодом 137 или раннер сообщает об убийстве процесса из-за нехватки памяти, проверьте область анализа, кэш зависимостей и параллельность jobs. Увеличение машины маскирует причину и повышает стоимость каждого прогона.
Что статический анализ не увидит под нагрузкой
У анализатора нет очереди запросов, реального пула соединений и задержек внешней системы, если вы не описали их в модели. Поэтому он может пропустить:
- исчерпание пула соединений с PostgreSQL при росте параллельности;
- очередь задач, которая растёт быстрее, чем обрабатывается;
- таймаут между сервисами, установленный выше таймаута балансировщика;
- гонку при обновлении одного объекта несколькими воркерами;
- утечку памяти, заметную только после длительной работы процесса;
- падение производительности из-за неудачного плана запроса или разогрева кэша.
Некоторые инструменты могут предупредить о подозрительном синхронном вызове внутри асинхронного кода или о потенциально дорогой операции. Но это предупреждение о конструкции, а не замер её поведения. Подтверждение дают метрики и тест: задержка p95 и p99, частота ошибок, загрузка CPU, память, длина очереди, число активных соединений.
Как строить проверки без ложного чувства безопасности
Разделите правила по последствиям. Ошибка синтаксиса, нарушение обязательного типа или подтверждённая уязвимость могут блокировать merge. Стилевые предупреждения, спорные эвристики и медленные проверки лучше сначала собирать в отчёт, иначе команда начнёт отключать весь инструмент из-за шума.
Для каждого правила зафиксируйте четыре параметра:
- какой дефект оно ловит и на каком языке;
- на каком этапе запускается — hook, pull request или nightly-проверка;
- что происходит при срабатывании — блокировка, предупреждение или задача на исправление;
- как измеряется полезность — число подтверждённых находок, ложных срабатываний и пропущенных дефектов.
Отдельно следите за исключениями. Исключение для одной строки может быть оправдано, но исключение для каталога без владельца быстро превращает анализ в декорацию. У каждого подавленного предупреждения должны быть причина, ответственный и дата пересмотра.
Где подход ломается
Первый граничный случай — динамический код и конфигурация, которые появляются только при запуске. Статический инструмент видит строку с именем класса, но может не знать, какой класс загрузит окружение. Второй — сгенерированный код: он создаёт большой шум и раздувает граф анализа, хотя вручную его не редактируют. Третий — общий репозиторий с несколькими языками, где единый статус «проверка прошла» скрывает падение одного из анализаторов.
Четвёртый — изменение схемы данных. Типы приложения могут быть корректны, но новая миграция, старый воркер и параллельный релиз создадут несовместимое состояние. Статический анализ может проверить отдельные вызовы, однако совместимость версий во времени проверяется миграциями, контрактными тестами и планом отката.
Не смешивайте эту тему с инвалидацией кэша и профилированием запросов: это отдельные задачи, требующие собственных измерений.
Что делать дальше
Начните с журнала CI за последние несколько недель. Для каждой проверки соберите время ожидания, время выполнения, потребление памяти, число повторных запусков и количество блокирующих находок. Затем сравните два режима на одинаковом наборе pull request: анализ изменённых файлов и полный анализ затронутого компонента.
После этого добавьте нагрузочный сценарий для тех мест, которые статические правила не видят: пул соединений, очередь фоновых задач, таймауты и конкуренцию за общие данные. В продакшене смотрите не только на процент ошибок, но и на p95 или p99 задержки, длину очередей и насыщение ресурсов. Следующий полезный шаг — связать находку анализатора с тестом или метрикой, которая подтверждает её влияние. Только тогда Git-проверка перестаёт быть формальностью и становится частью контроля над системой.
IT-архитектор / SQL-оптимизатор: Поиск N+1, оптимизация запросов, code review, поиск багов.
Спросить за 20 ₽Источники: Git documentation: githooks, Semgrep documentation
Частые вопросы
Может ли статический анализ показать, что сервис выдержит нагрузку?
Нужно ли запускать полный анализ на каждый pull request?
Почему локальный Git hook прошёл, а CI нашёл ошибки?
Что означает завершение анализа с кодом 137?
Можно ли считать проект безопасным, если Semgrep или другой SAST не нашёл проблем?
Что делать, если статический анализ слишком долго стоит в очереди?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.