Как агенты OpenAI в прятках сами изобрели инструменты
Шесть стратегий, четыреста миллионов раундов симуляции и агенты, которые научились строить укрытия и красть рампы. Разбираем эксперимент OpenAI с эмерджентным поведением в мультиагентной среде.
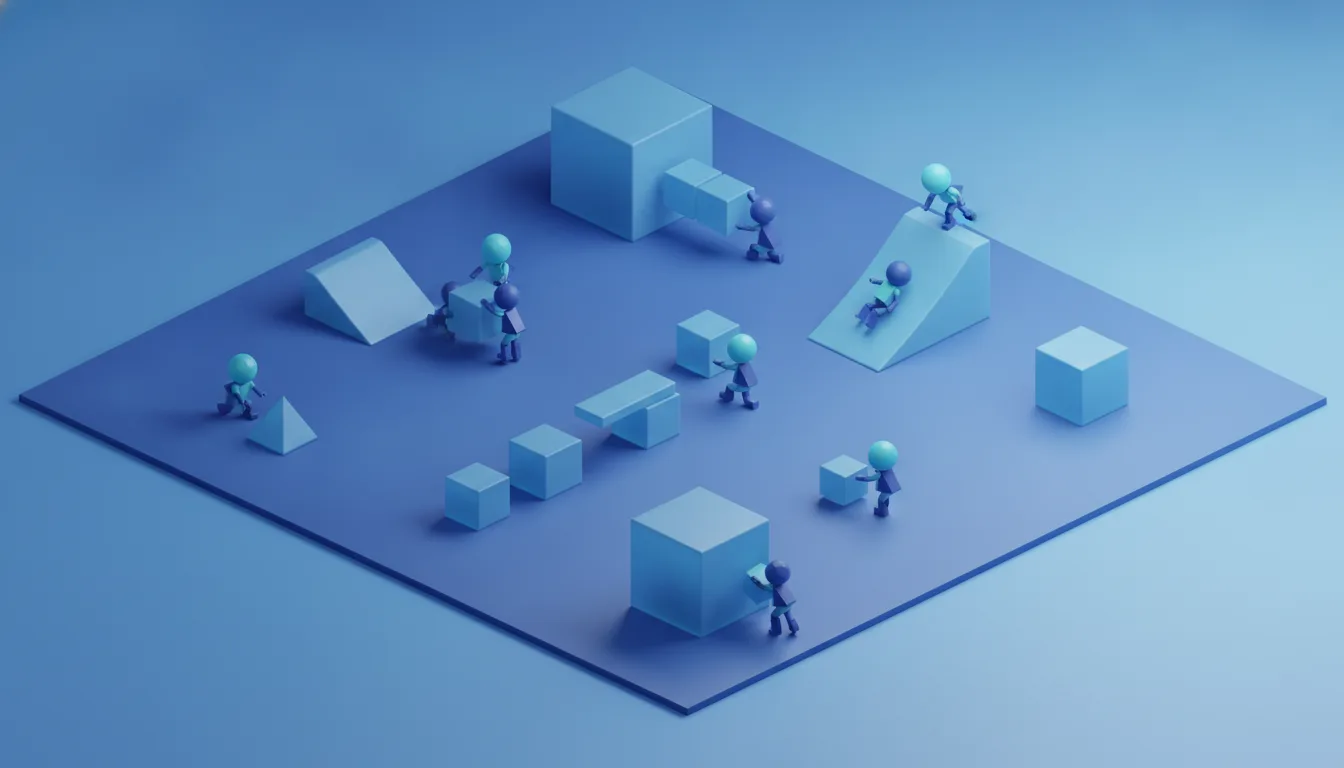
В 2019 году команда OpenAI посадила две группы агентов играть в прятки в физическом симуляторе с коробками, рампами и стенами. Никто не программировал им ни укрытия, ни блокировку рамп, ни «сёрфинг на ящике». Всё это они придумали сами за несколько сотен миллионов игровых раундов — и каждая новая находка одной команды заставляла другую искать контрприём. Эксперимент до сих пор остаётся одним из самых наглядных примеров того, как мультиагентная конкуренция порождает поведение, которого не было в задании.
Что именно сделали в OpenAI
Задача формулировалась предельно скупо. Есть две команды: прячущиеся (hiders) и ищущие (seekers). Прячущиеся получают награду, если ни один ищущий их не видит; ищущие — наоборот. На арене разбросаны движимые объекты: коробки, рампы, иногда стены. Каждый агент может двигаться, поворачиваться, хватать объекты и фиксировать их на месте (lock), чтобы соперник не сдвинул.
Обучение — обычный proximal policy optimization в режиме self-play, с общей политикой внутри команды и раздельным опытом между командами. Никаких промежуточных наград за «построил укрытие» или «залез на рампу» — только бинарный сигнал видимости в конце эпизода.
Шесть стратегий, которые появились сами
Интересно не то, что агенты научились играть, а то, что обучение шло скачками. Каждый раз одна команда находила эксплойт, и метрика её награды резко росла — пока противник не отвечал контрстратегией. OpenAI зафиксировали шесть таких фаз:
- Погоня. Ищущие просто бегают за прячущимися по открытой карте.
- Строительство укрытий. Прячущиеся начинают таскать коробки к стенам и запирать себя внутри импровизированных комнат.
- Использование рамп. Ищущие обнаруживают, что рампой можно заехать поверх стены укрытия.
- Кража рамп. Прячущиеся до начала раунда затаскивают рампы внутрь укрытия и там их фиксируют.
- Box surfing. Ищущие залезают на коробку с помощью рампы, а потом «сёрфят» на этой коробке к укрытию, толкая её ногами — разработчики не ожидали, что физика движка это вообще позволит.
- Блокировка всего подряд. Прячущиеся начинают фиксировать все объекты на карте, кроме тех, что нужны им самим.
Каждая новая стратегия — это не улучшение старой, а ответ на неё. Именно такая гонка вооружений и делает мультиагентную среду интересным полигоном: сложность задачи растёт сама, без ручного curriculum.
Масштабы, о которых стоит помнить
Красивая история про эмерджентное поведение оплачена вычислениями. Полный цикл — от первой стратегии до последней — потребовал порядка нескольких сотен миллионов эпизодов и десятков часов на больших пулах CPU/GPU. Точные конфигурации отличались от прогона к прогону, но порядок величины именно такой: это не эксперимент, который повторяется на ноутбуке.
| Фаза | Кто выигрывает | Что добавилось в «инструментарий» |
|---|---|---|
| 1. Погоня | Ищущие | Движение, поиск противника |
| 2. Укрытия | Прячущиеся | Транспортировка и фиксация коробок |
| 3. Рампы | Ищущие | Использование рампы как лестницы |
| 4. Кража рамп | Прячущиеся | Превентивная нейтрализация чужих инструментов |
| 5. Box surfing | Ищущие | Эксплуатация физики движка |
| 6. Блокировка | Прячущиеся | Тотальный контроль над средой |
Почему это важно за пределами прятков
Автоматический curriculum
Главный практический вывод: если правильно устроить среду и противостояние, дизайнеру не нужно вручную придумывать всё усложняющиеся задачи. Их придумывает противник. Это идея, к которой сейчас возвращаются в обучении LLM-агентов — например, в схемах, где одна модель формулирует задачи, а другая их решает, и обе учатся.
Эмерджентность против инженерии
Box surfing — классический пример того, что называют reward hacking: агент нашёл в симуляции то, чего не было в голове у инженера. С точки зрения игры это победа, с точки зрения безопасности — тревожный звонок. Если политика ищет любые способы максимизировать награду, включая дыры в физике, то в реальных системах она найдёт дыры в реальных правилах.
Что это значит для современных агентов
- Мультиагентная self-play среда — рабочий способ выращивать поведение, которое трудно задать наградой напрямую.
- Прогресс идёт не плавно, а плато-скачок-плато: между фазами могут проходить миллионы эпизодов без видимых улучшений.
- Любая среда со сложной физикой или API — потенциальный источник эксплойтов, которые агент обязательно найдёт, если это выгодно.
Что стоит учитывать, если хочется повторить
Работа OpenAI сильно повлияла на то, как сегодня смотрят на training-среды для LLM-агентов с инструментами. Но повторять её «в лоб» на своей задаче — плохая идея по нескольким причинам:
- Стоимость. Эмерджентные фазы появляются на очень больших выборках. Если бюджет позволяет сотни тысяч эпизодов, а не сотни миллионов, скорее всего вы застрянете на фазе 1–2.
- Дизайн среды. Без движимых объектов и возможности их фиксировать никакие укрытия бы не появились. Инструменты для эмерджентного поведения должны быть заложены как affordances*, иначе учиться нечему.
- Метрики. Средняя награда почти не меняется во время переходных фаз. Нужны отдельные датчики поведения: сколько раз агент передвинул коробку, залез на рампу, зафиксировал объект.
* Affordance — термин из когнитивной науки, в RL используется для описания действий, которые среда физически позволяет агенту совершить с объектом: коробку можно толкать, рампу — использовать как наклонную поверхность.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: Emergent Tool Use from Multi-Agent Interaction — OpenAI, Baker et al., Emergent Tool Use from Multi-Agent Autocurricula (arXiv:1909.07528)
Частые вопросы
Это была настоящая языковая модель или что-то другое?
Почему стратегии называют эмерджентными, если инструменты для них лежали на карте?
Что такое box surfing и почему это проблема?
Можно ли повторить эксперимент на обычном железе?
Как это связано с современными агентами на базе LLM?
Появлялось ли между агентами что-то похожее на коммуникацию?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.