Как ИИ прошёл Montezuma’s Revenge по одному прохождению человека
OpenAI показала метод, который обучает агента играм с редкой наградой всего по одной человеческой записи. На Montezuma’s Revenge агент набрал больше 74 000 очков — там, где обычный RL застревал на нуле.
Montezuma’s Revenge — платформер 1984 года для Atari 2600 — на годы стал символом провала обучения с подкреплением. Классические алгоритмы вроде DQN набирали на ней околонулевой счёт: игра почти не даёт награды, пока агент не соберёт ключ, не откроет дверь и не пройдёт целую цепочку правильных действий. Случайными тычками до первой награды агент не доходит никогда. В 2018 году OpenAI показала подход, который решает эту задачу иначе — берёт одну-единственную запись прохождения человеком и учится по ней. Результат: счёт выше 74 000 очков, что превосходит средний результат человека на этой игре.
Почему Montezuma’s Revenge ломала RL
Проблема называется разреженная награда¹. Агент совершает тысячи действий, прежде чем игра хоть как-то отреагирует очками. А обучение с подкреплением по своей природе опирается на сигнал награды: нет награды — нет градиента, который подсказал бы, что делать. В большинстве игр Atari награда капает регулярно (сбил врага — плюс очки), поэтому DQN и его наследники там работали. В Montezuma’s Revenge между стартом и первым плюсом лежит длинная цепочка прыжков по лестницам, уклонений от черепа и сбора ключа.
Стандартный ответ — исследование (exploration): заставить агента специально лезть в неизведанные состояния. Методы вроде любопытства и счётчиков посещённых состояний давали прогресс, но дорого: миллиарды кадров симуляции и всё равно нестабильный результат. OpenAI зашла с другой стороны — не через исследование с нуля, а через демонстрацию.
Идея: учиться, откатываясь назад от финала
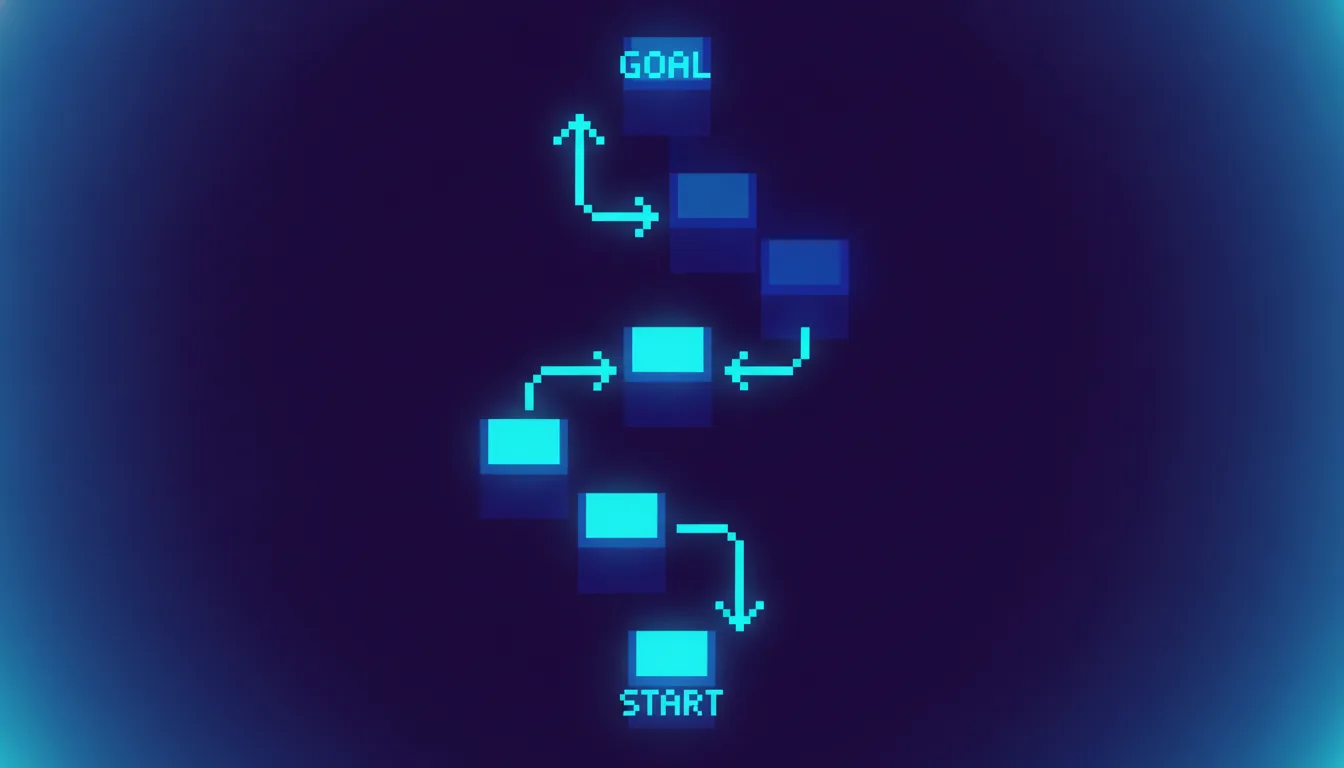
Ключевой приём метода — обратный курс обучения (backward curriculum). Вместо того чтобы стартовать с начала уровня и надеяться случайно добраться до награды, агента ставят почти в конец записанного человеком прохождения — за пару шагов до цели. Оттуда дойти до награды легко, и агент быстро учится закрывать этот короткий финальный отрезок.
Когда он уверенно справляется, стартовую точку сдвигают чуть раньше по демонстрации. Теперь агенту надо пройти немного больший кусок — но конец пути он уже знает. Так точка старта постепенно ползёт к самому началу игры, и к концу обучения агент проходит весь уровень с настоящего старта.
Демонстрация здесь — не то, что агент копирует по кадрам. Это разметка удобных точек старта, из которых сложную задачу удаётся разбить на цепочку простых.
Важная деталь: агент не имитирует действия человека напрямую. Он заново учит собственную политику обычным RL-алгоритмом (в работе использовался PPO), просто на удачно подобранных стартовых состояниях. Поэтому итоговое поведение может отличаться от записи и в некоторых местах оказаться эффективнее, чем у человека, — отсюда и счёт выше среднечеловеческого.
Что для этого нужно
- Одна запись прохождения человеком — последовательность состояний игры.
- Возможность сбрасывать эмулятор в произвольное состояние из этой записи. Это ограничение: метод требует управляемой среды, где можно задавать точку старта.
- Обычный алгоритм policy-optimization поверх — здесь PPO.
Чем это отличается от соседних подходов
Тему разреженной награды в 2018 году штурмовали сразу с нескольких сторон. Полезно видеть разницу.
| Подход | Что использует | Слабое место |
|---|---|---|
| DQN и обычный RL | Только сигнал награды | На разреженной награде не сходится |
| Curiosity / внутренняя мотивация | Награду за новизну состояний | Дорого по кадрам, нестабильно |
| Behavioral cloning | Много демонстраций, копирует действия | Нужен большой датасет, не превосходит учителя |
| Демонстрация + обратный курс (этот метод) | Одну запись как точки старта | Нужен сброс среды в произвольное состояние |
Отдельно стоит держать в голове работу Go-Explore той же эпохи: она тоже добивалась рекордов на Montezuma’s Revenge, но через запоминание и повторное посещение состояний, а не через одну демонстрацию. Это разные ветки решения одной проблемы, и путать их не стоит.
Почему это важно за пределами игры
Atari — полигон, а не цель. Смысл в том, что демонстрация резко удешевляет обучение задачам с длинной цепочкой действий и редким итоговым сигналом. Таких задач много: робот, который должен выполнить последовательность манипуляций ради одной цели в конце; агент, проходящий многошаговый интерфейс; любая среда, где промежуточную награду придумать трудно, а финальный успех очевиден.
Ограничение никуда не делось: чтобы стартовать из середины демонстрации, среду нужно уметь ставить в произвольное состояние. В эмуляторе это бесплатно, в физическом мире — почти невозможно. Поэтому метод в чистом виде живёт там, где есть симулятор: игры, обучение роботов в симуляции с последующим переносом, синтетические среды.
Что стоит запомнить
- Разреженная награда — не проблема «слабого» алгоритма, а структурная: без сигнала учиться нечему.
- Одна демонстрация способна заменить миллиарды кадров слепого исследования, если использовать её как лестницу точек старта.
- Обратный курс — учить с конца к началу — общий приём, применимый далеко за пределами Atari.
- Цена метода — требование к среде: нужен сброс в произвольное состояние.
¹ Разреженная награда (sparse reward) — ситуация, когда среда выдаёт агенту ненулевую награду очень редко, обычно только по достижении цели. Противоположность — плотная награда, где обратная связь приходит почти на каждом шаге.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: OpenAI — Learning Montezuma’s Revenge from a Single Demonstration
Частые вопросы
Агент копирует действия человека из демонстрации?
Почему нельзя просто обучить обычный DQN на этой игре?
Сколько демонстраций нужно методу?
Можно ли применить это к реальному роботу?
Это то же самое, что Go-Explore?
74 000 очков — это много?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.