Как модель сама придумывает типы для разрешения сущностей
Классический подход к disambiguation опирается на готовый список типов вроде «человек» и «город». Новый метод предлагает модели самой открывать типы под конкретный корпус — и это меняет цену ошибки.
Проблема одного слова с десятком значений
Строка «Jordan» в тексте может означать страну, реку, баскетболиста, бренд кроссовок или чьё-то имя. Задача разрешения сущностей (entity disambiguation) — привязать это упоминание к конкретной записи в базе знаний, например к странице в Wikidata. Ошибка здесь стоит дорого: поисковая система выдаёт кроссовки вместо Иордании, а система заполнения графа знаний записывает баскетболиста в список рек.
Долгое время у упоминания сначала определяли тип — грубую категорию вроде «персона», «организация», «место», — а уже потом искали подходящую запись внутри этой категории. Тип резко сужает пространство кандидатов: если «Jordan» помечен как «страна», баскетболист и кроссовки отпадают сразу. Вопрос в том, откуда брать сами типы.
Откуда берутся типы и почему готовый список мешает
Обычно типы берут из фиксированной онтологии. Это может быть небольшой набор из нескольких классов (person, location, organization, misc — как в старом корпусе CoNLL) или иерархия на тысячи узлов, вроде типов Wikidata или классов из FIGER и Wikidata NER-разметки. У готового набора два практических минуса.
- Слишком грубый. Класс «организация» одинаково накрывает футбольный клуб, звукозаписывающий лейбл и министерство. Для разрешения сущности внутри этого класса тип почти не помогает.
- Слишком общий. Онтология Wikidata строилась под весь мир, а не под ваш корпус биомедицинских статей или ленту новостей о спорте. Половина типов в вашем тексте не встречается ни разу, а нужных гранул нет.
Отсюда идея, которую разбирает подход «discovering types»: не брать типы из внешнего справочника, а вывести их из самого корпуса и из того, как модель уже различает сущности. Типы становятся не входными данными, а результатом работы.
Как типы открывают, а не задают
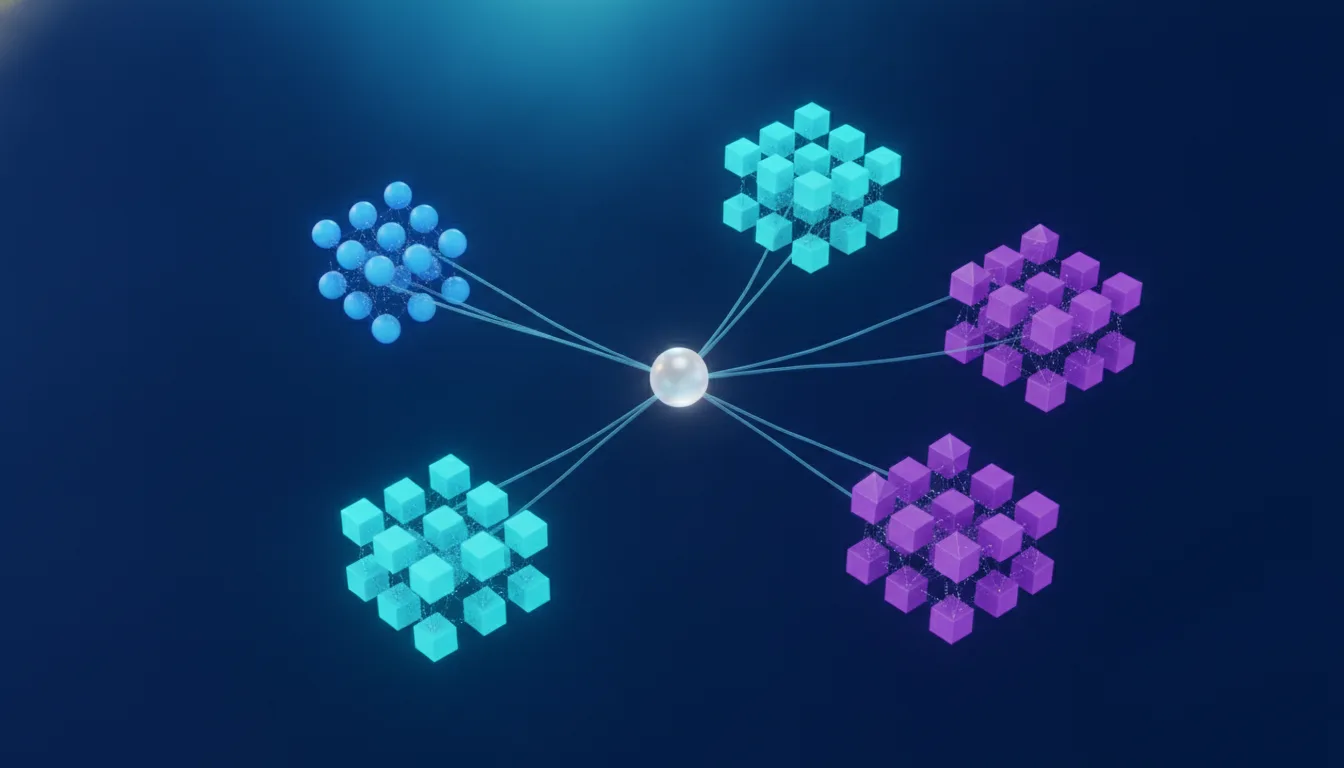
Общая логика метода такая. Есть корпус упоминаний, для части из которых известна правильная привязка к базе знаний. Модель кодирует каждое упоминание вместе с контекстом в вектор — эмбеддинг1. Дальше вместо того, чтобы навешивать заранее заданный ярлык, система группирует эти векторы и смотрит, какие группы реально отделяют одну сущность от другой.
Шаг за шагом
- Собрать упоминания и их контексты, прогнать через энкодер (обычно на базе трансформера) и получить векторные представления.
- Кластеризовать эти представления. Каждый устойчивый кластер — кандидат в «тип»: группа упоминаний, которые модель считает похожими по смыслу и употреблению.
- Оценить, насколько кластер помогает различать сущности: если внутри него упоминания уверенно разводятся по разным записям базы знаний, тип полезен.
- Оставить набор типов, который максимально сужает список кандидатов, не теряя правильных ответов.
Ключевое отличие от привычного few-shot или классификации: набор меток не фиксирован. Если в корпусе про музыку важно отличать «сольного исполнителя» от «группы», метод способен выделить такой тип, даже если в исходной онтологии его не было.
Тип полезен ровно настолько, насколько он сокращает число кандидатов, не выкидывая правильного. Всё остальное — красивая, но бесполезная таксономия.
Что это даёт на практике
Главный выигрыш — в редких и доменных сущностях, где готовая онтология молчит. Если ваш корпус — юридические документы, у вас нет заранее готового типа «спецсубъект по конкретной статье», зато данные его подскажут. Второй выигрыш — устойчивость: открытые из данных типы не устаревают вместе с внешним справочником.
Сравнение подходов
| Подход | Откуда типы | Сильная сторона | Слабое место |
|---|---|---|---|
| Фиксированная онтология | Внешний справочник | Прозрачно, воспроизводимо | Не подстраивается под корпус |
| Без типов вовсе | Нет | Просто в реализации | Огромное пространство кандидатов |
| Discovering types | Из данных и эмбеддингов | Подстройка под домен, гранулярность | Типы труднее интерпретировать |
Плата за гибкость — интерпретируемость. «Person» понятен любому аналитику, а «кластер №47» требует ручного осмотра, чтобы понять, что модель туда собрала. Для аудита систем, где важно объяснить решение, это ощутимый минус.
Где это уместно, а где нет
Метод оправдан, когда у вас узкий домен без хорошей онтологии, много редких сущностей и достаточно размеченных примеров, чтобы кластеры были устойчивыми. Он менее оправдан, когда речь про общий текст, для которого Wikidata и так хорошо работает, или когда команде критична объяснимость каждого шага.
Точных цифр прироста качества по конкретной публикации я приводить не буду, чтобы не выдавать за факт то, чего не проверял: метрики сильно зависят от корпуса, энкодера и того, с чем сравнивать. Если решаете внедрять, гоняйте свой бенчмарк на своих данных, а не ориентируйтесь на числа из чужой статьи о другом наборе.
1 Эмбеддинг — представление текста (слова, упоминания, предложения) в виде числового вектора, где близкие по смыслу фрагменты оказываются рядом в пространстве. Именно на близости этих векторов и строится кластеризация.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Частые вопросы
Чем разрешение сущностей отличается от их распознавания?
Зачем вообще типы, если можно сразу искать нужную запись?
Открытые из данных типы можно как-то назвать по-человечески?
Нужна ли для метода разметка?
Стоит ли отказываться от Wikidata-онтологии в пользу этого подхода?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.