LlamaIndex Agents против LangGraph: что выбрать под задачу
Два фреймворка для агентов на LLM решают разные проблемы: один заточен под поиск и работу с данными, второй — под управление сложными графами состояний. Разбираем, где кончается зона комфорта каждого.
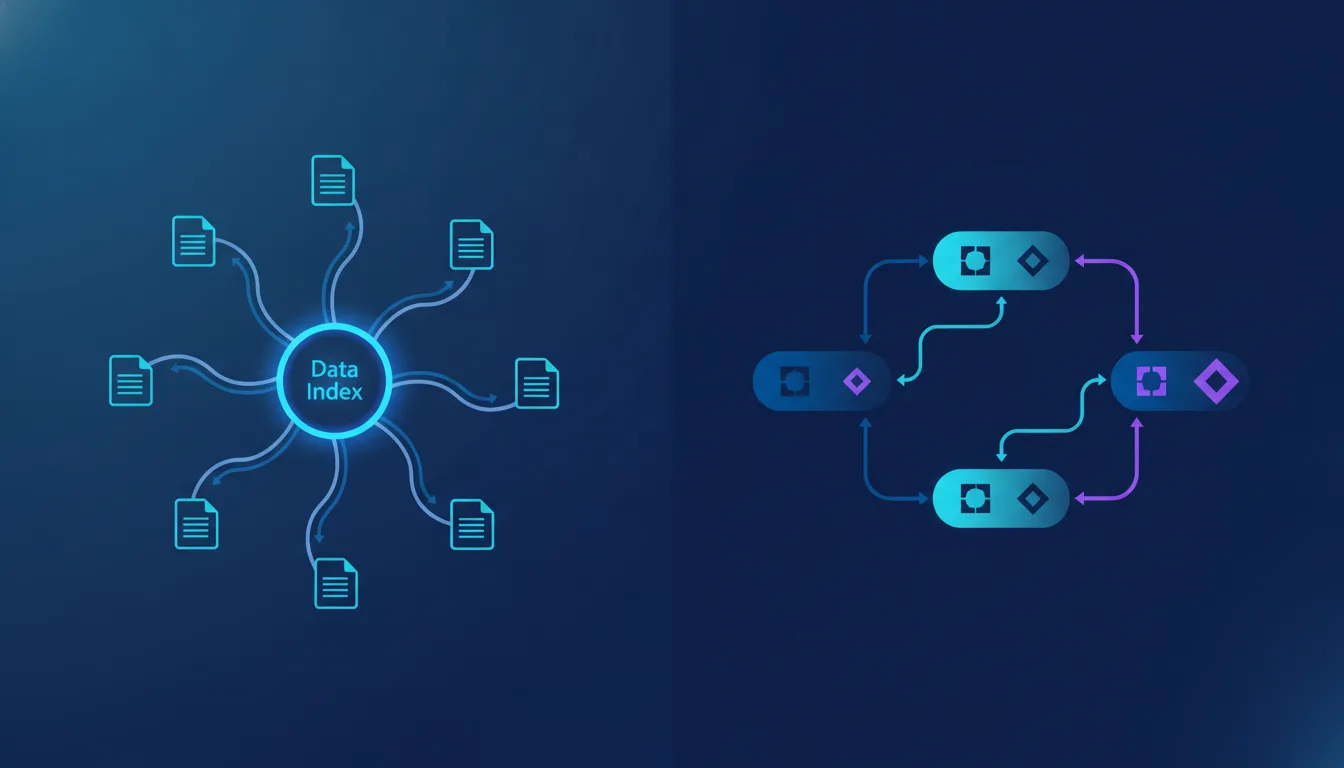
Если вы строите приложение поверх LLM сложнее, чем «промпт — ответ», рано или поздно упрётесь в выбор оркестратора. Два очевидных кандидата в экосистеме Python — LlamaIndex с его агентными абстракциями и LangGraph от команды LangChain. Их часто ставят рядом, хотя они выросли из разных задач: LlamaIndex начинался как инструмент для RAG1 и работы с индексами документов, а LangGraph — как низкоуровневый движок для описания рабочих процессов в виде графа. Отсюда и практическая разница, которую видно уже на второй неделе разработки.
Откуда растут корни
LlamaIndex решает проблему «у меня есть тонна данных, дайте LLM отвечать по ним точно». Индексация, чанкинг, векторный поиск, реранкинг, query engines — это его родная территория. Агенты появились как надстройка: дать модели набор инструментов (в первую очередь — те самые query engines) и позволить ей самой решать, куда идти за ответом.
LangGraph заходит с другого конца. Здесь агент — это граф: узлы (nodes) выполняют работу, рёбра (edges) описывают переходы, а состояние (state) прокидывается между ними. Никакой магии «модель сама разберётся»: вы явно проектируете, кто кого вызывает, где цикл, где условное ветвление и где человек вмешивается в процесс.
LlamaIndex спрашивает «что модель должна знать», LangGraph — «как модель должна действовать». Большинство реальных проектов упираются в оба вопроса сразу.
Модель управления: неявная против явной
В LlamaIndex базовый агентный цикл — это ReAct или function-calling поверх набора инструментов. Вы описываете инструменты, отдаёте их агенту, а дальше он в цикле «мысль — действие — наблюдение» сам решает, когда остановиться. Это быстро для типовых сценариев, но управляемость ограничена: как только логика ветвится нетривиально, вы начинаете бороться с абстракцией.
LangGraph заставляет описать граф руками. Это больше кода на старте, но у вас появляется то, чего в неявном цикле нет: детерминированные переходы, встроенные чекпоинты состояния, возможность прервать выполнение и возобновить с середины, human-in-the-loop без костылей. Для длинных многошаговых процессов и агентов, которые должны переживать перезапуск сервиса, это решающий фактор.
Пример: минимальный ReAct-агент в LlamaIndex
from llama_index.core.agent import ReActAgent
from llama_index.core.tools import FunctionTool
from llama_index.llms.openai import OpenAI

def multiply(a: int, b: int) -> int:
    """Перемножить два числа."""
    return a * b

tool = FunctionTool.from_defaults(fn=multiply)
llm = OpenAI(model="gpt-4o-mini")

agent = ReActAgent.from_tools([tool], llm=llm, verbose=True)
resp = agent.chat("Сколько будет 21 умножить на 2?")
print(resp)
Здесь вы не описываете поток управления вообще — агент сам решает, вызвать ли инструмент. API LlamaIndex активно менялось между версиями (класс ReActAgent и путь импорта в новых релизах могут отличаться), поэтому сверяйтесь с документацией под вашу версию пакета.
Тот же принцип в LangGraph
from langgraph.graph import StateGraph, END
from typing import TypedDict

class State(TypedDict):
    query: str
    result: str

def call_model(state: State) -> State:
    # здесь вызов LLM или инструмента
    return {"result": f"обработано: {state['query']}"}

def should_continue(state: State) -> str:
    return END if state["result"] else "call_model"

graph = StateGraph(State)
graph.add_node("call_model", call_model)
graph.set_entry_point("call_model")
graph.add_conditional_edges("call_model", should_continue)
app = graph.compile()

print(app.invoke({"query": "привет", "result": ""}))
Кода заметно больше даже для тривиального случая. Зато переходы и состояние видны глазами, а не спрятаны внутри агента. На сложных сценариях эта многословность окупается предсказуемостью.
Где что сильнее
| Критерий | LlamaIndex Agents | LangGraph |
|---|---|---|
| Работа с данными и RAG | Родная территория: индексы, query engines, реранкинг из коробки | Нет своего слоя данных, RAG собираете сами |
| Контроль над потоком | Неявный агентный цикл, ветвление ограничено | Явный граф с условными рёбрами и циклами |
| Персистентность состояния | Базовая, через память агента | Чекпоинты, возобновление, история состояний |
| Human-in-the-loop | Требует ручной сборки | Встроенная поддержка прерывания и возобновления |
| Порог входа | Ниже для типового RAG-агента | Выше: нужно проектировать граф |
| Мультиагентные сценарии | Есть AgentWorkflow / оркестрация агентов | Граф из подграфов, естественная композиция |
Как выбирать под задачу
Разложим по типичным ситуациям, без универсального «берите вот это».
- Чат-бот по вашей документации или базе знаний. LlamaIndex почти всегда быстрее к результату: индексация, поиск и агент поверх них — один стек, минимум клея.
- Многошаговый бизнес-процесс с ветвлениями и одобрениями. LangGraph: явный граф, чекпоинты, возможность вставить проверку человеком между узлами.
- Долгоживущий агент, который должен переживать рестарт сервиса. LangGraph с чекпоинтерами. В LlamaIndex это придётся собирать вручную.
- Прототип на выходные, где важна скорость проверки гипотезы. LlamaIndex, если задача крутится вокруг данных.
- Сложная координация нескольких агентов с общим состоянием. LangGraph композирует подграфы естественнее.
Их можно совмещать
Ложная дилемма — думать, что нужно выбрать одно навсегда. Оба фреймворка живут в общей Python-экосистеме и не конкурируют на уровне примитивов. Рабочая связка: LlamaIndex отвечает за retrieval-слой (индексы, query engines, реранкинг), а LangGraph оркеструет процесс и вызывает эти движки как инструменты внутри узлов графа. Вы получаете сильный слой данных и явный контроль над потоком одновременно.
Минус подхода — две зависимости и две модели ментальных абстракций в одном проекте. Для небольшой команды это реальная цена в поддержке, и иногда честнее взять один фреймворк и дожать его до нужного, чем тащить оба.
1 RAG (Retrieval-Augmented Generation) — подход, при котором LLM перед ответом подтягивает релевантные фрагменты из внешних источников (векторной базы, документов) и генерирует ответ с опорой на них, а не только на знания из обучения. Снижает галлюцинации и позволяет отвечать по актуальным и приватным данным.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: LlamaIndex — официальная документация, LangGraph — официальная документация
Частые вопросы
Что проще освоить новичку в агентах на LLM?
Можно ли использовать LlamaIndex и LangGraph вместе?
Нужен ли LangGraph, если у меня простой чат-бот по документам?
Как в LangGraph переживать перезапуск сервиса?
Почему примеры кода могут не завестись на моей версии?
Какой фреймворк лучше для мультиагентных систем?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.