Логирование в проекте: чек-лист для команды
Проверьте, помогают ли логи найти причину ошибки, а не просто подтверждают, что приложение работает. Чек-лист охватывает события, поля, уровни, хранение и риски в продакшене.
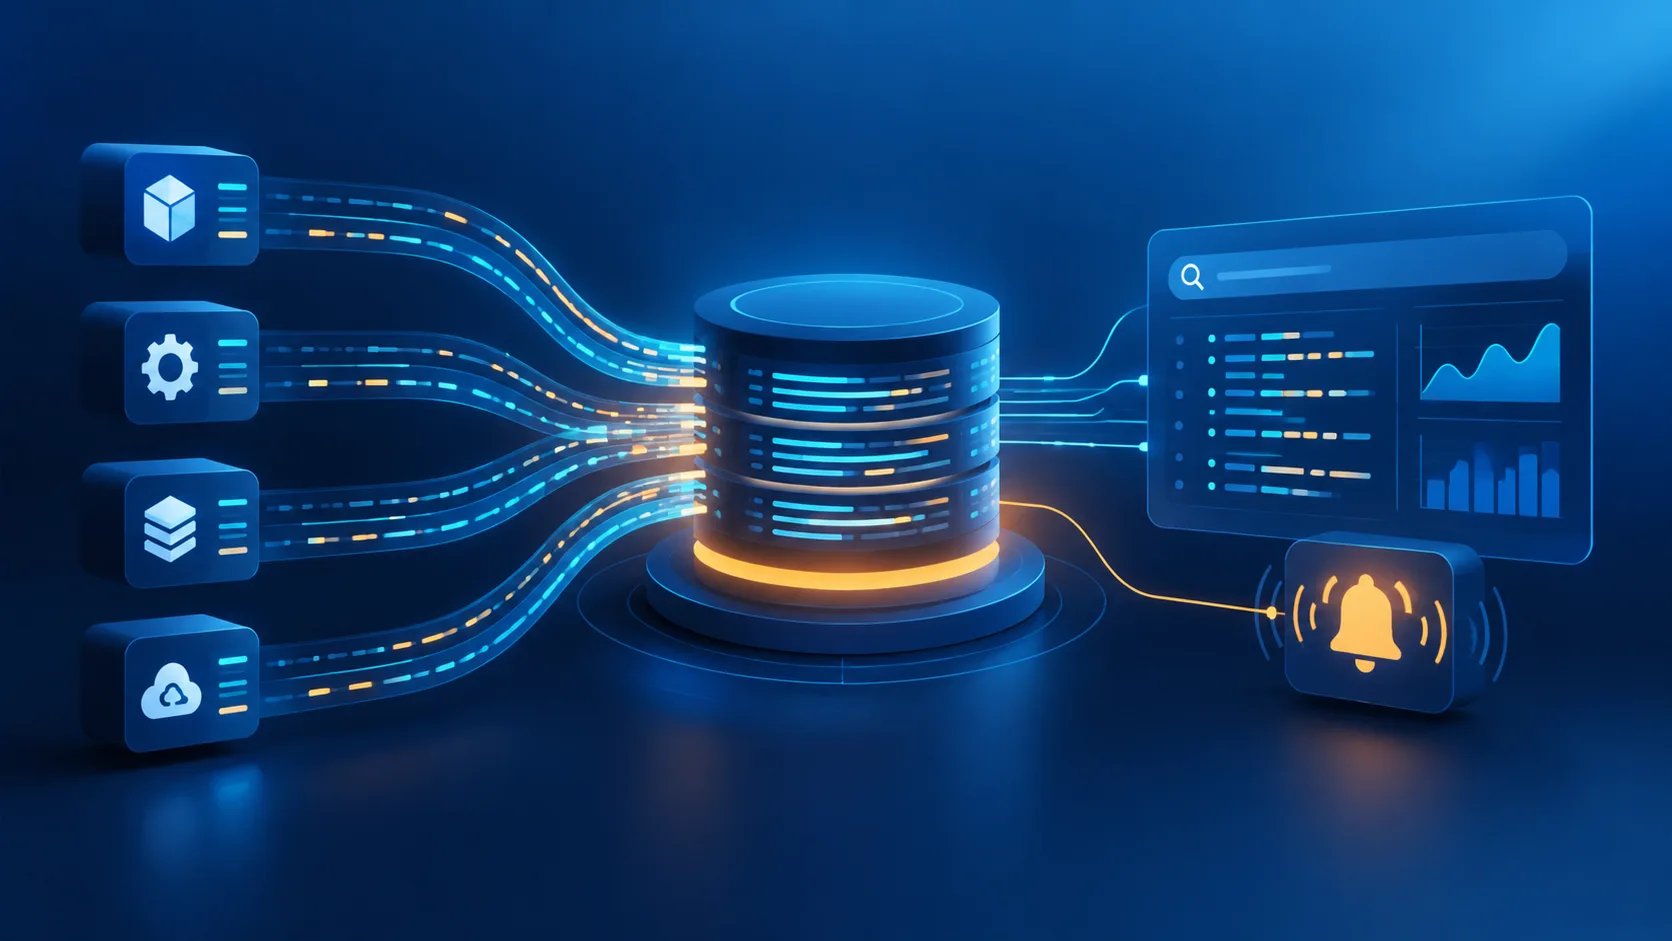
Логи должны отвечать на вопросы дежурного
Когда запрос падает в продакшене, разработчику нужно связать ошибку с конкретным действием, увидеть контекст и понять, где искать причину. Запись «что-то пошло не так» этого не даёт, а подробный лог с паролем пользователя создаёт новую проблему. Этот чек-лист поможет проверить систему логирования без привязки к языку и фреймворку.
Речь не о выборе библиотеки или настройке конкретного сервера: сначала определите, какие события нужны команде и как она будет их искать. Синтаксис конфигурации зависит от стека, поэтому перед внедрением сверяйте его с документацией используемого инструмента.
Чек-лист: что проверить до релиза
- Опишите задачи логов. Для каждого важного сценария сформулируйте вопрос, на который лог должен помочь ответить: почему не создался заказ, какой внешний сервис не ответил, сколько заняла операция. Если запись не помогает расследованию, мониторингу или аудиту, проверьте, нужна ли она вообще. Проверка: команда может назвать, кто и зачем будет искать это событие.
- Логируйте значимые переходы, а не каждую строку кода. Полезны начало и результат операции, отказ зависимости, ошибка обработки сообщения, важное изменение состояния. Повторяющиеся записи внутри тесного цикла могут раздуть объём и затруднить поиск. Проверка: по одному пользовательскому сценарию можно восстановить ключевые этапы, не просматривая поток технических деталей.
- Задайте единый набор полей. Как минимум согласуйте время, уровень, название события, компонент и идентификатор запроса или операции, если он доступен. Добавляйте контекст вроде идентификатора сущности только тогда, когда он помогает поиску и не раскрывает лишнего. Проверка: записи из разных компонентов можно отфильтровать по общим полям.
- Выберите структурированный формат для событий. Запись, где поля отделены и имеют стабильные имена, обычно проще фильтровать и передавать в систему сбора, чем свободный текст. Человекочитаемое описание можно оставить отдельным полем. Проверка: инструмент обработки извлекает поля, а не заставляет команду искать значения внутри произвольной фразы.
- Согласуйте уровни серьёзности. Команда должна одинаково понимать, что считать отладочной информацией, предупреждением и ошибкой. Не помечайте каждый неуспешный ответ внешнего сервиса как критический: сначала определите последствия для пользователя и возможность повтора. Проверка: дежурный понимает, какие записи требуют реакции, а какие нужны только при расследовании.
- Связывайте записи одного запроса. Передавайте идентификатор корреляции между компонентами, насколько позволяет архитектура. Не используйте для этого секреты или данные пользователя. Проверка: поиск по идентификатору показывает связанные события на всём пути запроса.
- Проверьте ошибки и внешние зависимости. Записывайте, какая операция не удалась и какой компонент участвовал; сохраняйте достаточный контекст, чтобы различить сетевой сбой, отказ зависимости и ошибку приложения. Не превращайте сообщение об ошибке в дамп запроса с персональными данными. Проверка: типовую ошибку можно классифицировать без доступа к секретам и без догадок по одному слову «ошибка».
- Защитите чувствительные данные. Проверьте, не попадают ли в логи пароли, токены доступа, платёжные реквизиты, содержимое заголовков авторизации и персональные данные, не нужные для расследования. Маскирование лучше дополнить запретом на запись чувствительных полей в источнике. Проверка: команда проверила реальные примеры записей, включая ошибки и отладочный режим.
- Ограничьте доступ и срок хранения. Определите, кто может читать логи и сколько они хранятся. Учитывайте, что доступ к журналам может дать больше сведений о пользователях и внутреннем устройстве системы, чем доступ к обычной панели мониторинга. Проверка: есть владелец хранилища, правила доступа и понятная причина выбранного срока.
- Проверьте доставку и поведение при сбое. Уточните, что происходит, если сборщик недоступен, диск заполняется или приложение резко увеличивает поток записей. Логирование не должно незаметно блокировать критический путь приложения, а ошибки доставки нельзя считать невозможными. Проверка: команда знает, где увидеть сбой отправки и какой сигнал предупредит о потере событий.
- Сверьте логи с мониторингом. Логи помогают разобрать отдельные события; метрики показывают тенденцию и масштаб. Для инцидента полезна связка: сигнал о росте ошибок, фильтр по компоненту и запросу, затем подробная запись. Проверка: по тревоге можно перейти к относящимся к ней логам, а не искать их вручную по всем сервисам.
- Проверьте стоимость объёма. Избыточные записи увеличивают хранение, передачу и расходы на поиск. Сначала убирайте дубли и шум, затем решайте, нужно ли менять частоту или детализацию. Не снижайте объём так, чтобы исчезли ошибки, необходимые для разбора инцидента. Проверка: команда знает, какие события дают основной объём и какую диагностическую ценность они несут.
Структурированный лог или обычный текст
| Подход | Что выигрываете | Чем платите | Когда уместен |
|---|---|---|---|
| Свободный текст | Простая запись и удобное чтение в терминале | Поля сложно одинаково фильтровать; формат сообщения может меняться | Локальная отладка и небольшие компоненты, если записи не нужно анализировать как данные |
| Структурированные события | Фильтры по полям, согласованная обработка и поиск по идентификаторам | Нужно договориться о схеме, следить за совместимостью полей и контролировать объём | Сервисы и системы, где события собирают и анализируют централизованно |
| Смешанный формат | Машиночитаемые поля плюс короткое пояснение для человека | Нужно поддерживать оба слоя и не дублировать контекст в сообщении | Командам, которым важны и поиск, и быстрое чтение записи при разборе |
Сравнивайте не формат сам по себе, а цену расследования. Если команда регулярно ищет одинаковые фрагменты текста вручную, стабильные поля могут сэкономить время. Если система не умеет обрабатывать такие записи, переход потребует дополнительных инструментов и договорённостей.
Что чаще всего ломает логи
События есть, контекста нет
Сообщение «операция не удалась» не говорит, какая именно операция, на каком этапе и с каким результатом. Добавьте название события и безопасный идентификатор, который поможет найти связанные записи. Не добавляйте в контекст всё содержимое запроса «на всякий случай».
Одна проблема создаёт сотни записей
Повторная попытка может породить одинаковые сообщения при каждом обращении к недоступной зависимости. В итоге важные события тонут в шуме, а объём хранения растёт. Проверьте поведение на повторяющихся ошибках и решите, какие записи действительно нужны для каждого повтора. Не скрывайте первую ошибку и итог операции.
Уровень не соответствует последствиям
Если ожидаемый отказ помечен как ошибка, дежурный получает ложные сигналы. Если серьёзный сбой записан как обычное информационное событие, его можно пропустить. Зафиксируйте правила уровней на примерах из вашего проекта и проверьте, что разработчики применяют их одинаково.
Детальный режим раскрывает секреты
Отладочные записи нередко содержат больше данных, чем обычные. Перед включением подробного режима проверьте, какие поля он добавляет, кто увидит результат и как долго записи останутся в хранилище. Отключение подробного режима не заменяет фильтрацию секретов на стороне приложения.
Как выбрать следующий шаг
Начните с одного пользовательского пути, который команда уже расследовала или боится расследовать. Проследите его от входящего запроса до результата, выпишите нужные события и поля, затем проверьте их на реальных ошибках без чувствительных данных. После этого решите, какой формат поиска поддерживает ваша инфраструктура и какие сигналы нужно связать с мониторингом.
Не внедряйте единую схему сразу во все сервисы без проверки: сначала согласуйте названия ключевых полей и попробуйте их на одном компоненте. В продакшене следите за объёмом логов, задержкой доставки, ошибками сбора и временем, которое уходит на поиск причины инцидента. Инвалидация данных и правила аудита — отдельные темы; здесь речь только о логах приложения и их использовании для диагностики.
Хороший лог — не тот, где записано всё. Это тот, который помогает ответить на вопрос дежурного, не раскрывая лишнего и не пряча важное в шуме.
Термин: идентификатор корреляции — значение, по которому можно связать записи об одной операции или запросе, прошедшие через несколько компонентов.
Проверка рекламы на риски: Что в макете вызовет вопросы ФАС: превосходные степени, сравнения, обещания результата, маркировка.
Спросить за 40 ₽Источники: OpenTelemetry: Logs, OWASP Logging Cheat Sheet
Частые вопросы
Обязательно ли переводить все логи в JSON?
Можно ли писать в лог полный запрос пользователя?
Что выбрать: логирование или мониторинг?
Как понять, что логов слишком много?
Нужно ли записывать ошибки внешних сервисов?
Как долго хранить логи?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.