Мониторинг в конвейере: что проверять на код-ревью
Конвейер может завершиться без ошибки, а данные всё равно опоздают, потеряют часть строк или окажутся неполными. На ревью мониторинга проверьте не число метрик, а то, сможет ли дежурный заметить сбой и понять, где он произошёл.
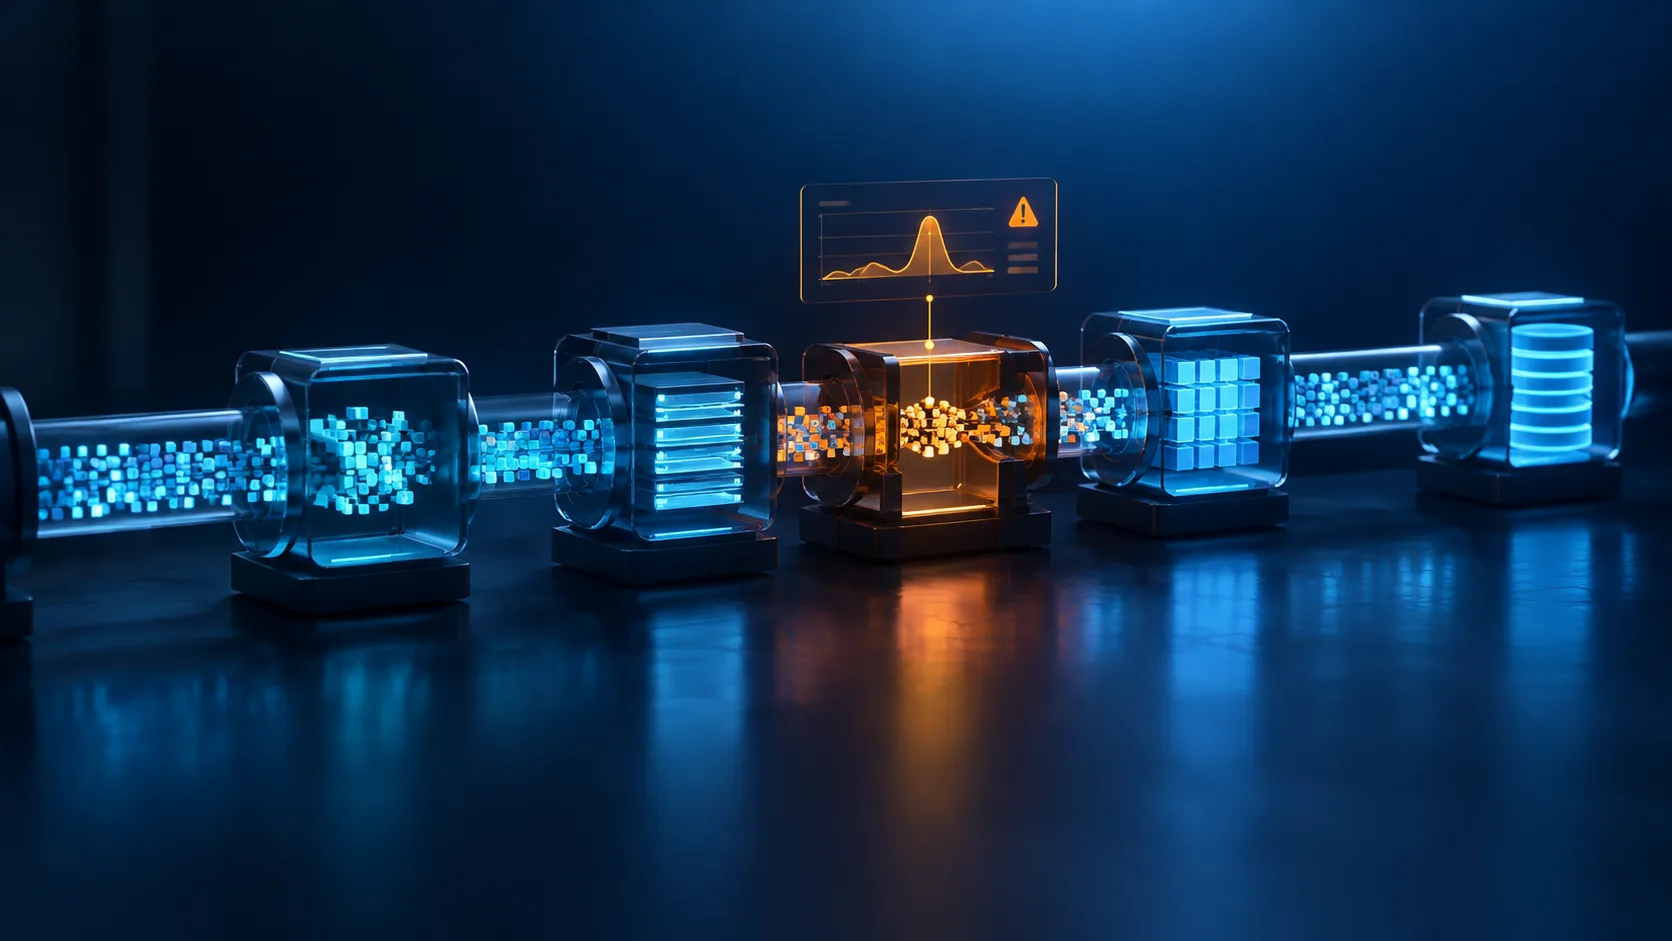
Зелёный статус ещё не значит, что данные готовы
Пакетная задача может завершиться с кодом успеха, но выгрузка в хранилище окажется неполной, устареет или не попадёт в следующий этап. На ревью мониторинга конвейера данных важно проверить не наличие дашборда, а связку: какой сбой видит команда, как быстро его замечает и может ли определить проблемный этап.
Дальше речь о пакетном конвейере — от запуска задания до публикации результата для потребителя. Примеры относятся к модели метрик OpenTelemetry Metrics 1.0 и новее; конкретные версии SDK зависят от языка. Инвалидация кешей и трассировка распределённого запроса — отдельные темы: здесь оцениваем именно мониторинг прохождения данных.
Сначала проверьте, что команда считает успехом
Частая ошибка — считать успешным запуск процесса. Но процесс может завершиться штатно и выгрузить только часть данных; задача может обработать входной файл, но не опубликовать результат; последний этап может ждать данные, которые никто не записал. На ревью попросите автора назвать точное условие, после которого потребитель вправе считать набор данных готовым.
Обычно одного признака мало. Проверяйте, отражает ли мониторинг хотя бы такие состояния:
- запуск начался и завершился, включая итоговый статус;
- входные данные поступили в ожидаемое окно;
- обработка закончилась, а результат опубликован;
- объём результата не нарушает ожидаемые границы;
- повторный запуск или повторная доставка не маскируются под новый успешный результат.
Смысл не в том, чтобы добавить пять счётчиков на каждый этап. Важна наблюдаемая связь между запуском, обработкой и готовым результатом. Если в системе нет явного понятия «результат опубликован», мониторинг не сможет надёжно сообщить, что данные уже доступны потребителю.
На ревью задайте вопрос: «Какое конкретное наблюдение докажет, что потребитель получил свежие и полные данные?» Если ответ сводится к «джоба зелёная», проверка пока не покрывает результат конвейера.
Проверьте сигналы: свежесть, длительность, объём
Для пакетного конвейера три сигнала обычно полезнее, чем десятки технических счётчиков без контекста. Свежесть показывает, насколько отстают данные. Длительность помогает заметить замедление. Объём результата выявляет пустые или неожиданно маленькие выгрузки. Каждый сигнал должен быть привязан к конкретному заданию или набору данных, но не к бесконечному набору уникальных значений.
| Что проверять | Вопрос на ревью | Типичная ловушка |
|---|---|---|
| Свежесть | Как измеряется возраст последнего опубликованного результата? | Считается время успешного старта, а не время готовности данных. |
| Длительность | Можно ли увидеть рост времени выполнения конкретного этапа? | Есть только среднее по всем заданиям, которое скрывает медленные запуски. |
| Объём | Что сработает, если результат внезапно пустой или слишком маленький? | Любой успешно записанный файл считается нормальным. |
| Ошибки и повторы | Различаются ли первая ошибка, повтор и окончательный отказ? | Ретраи увеличивают счётчик успехов, а исходный сбой исчезает из картины. |
Не назначайте универсальный порог вроде «задача дольше десяти минут — авария». Он зависит от расписания, размера входа и допустимого времени устаревания для потребителя. На ревью ищите обоснование порога: договорённый срок доставки, исторический диапазон или проверенное ограничение этапа. Если таких оснований нет, попросите сначала собрать данные для настройки, а не выдавать случайное число за норму.
Не превращайте метрики в каталог запусков
В OpenTelemetry метка измерения, или атрибут метрики, помогает разбить сигнал на группы. Но каждое новое уникальное сочетание атрибутов создаёт отдельный временной ряд. Для метрик опасны значения, которые меняются почти при каждом запуске: идентификатор задания, имя файла, произвольный текст ошибки, пользовательский идентификатор.
На ревью проверьте атрибуты для счётчиков и гистограмм. Обычно подходят ограниченные значения вроде имени этапа, результата из фиксированного набора и типа источника, если число типов контролируется. Идентификатор отдельного запуска лучше передавать в логи или трассу, где он нужен для расследования, а не добавлять как атрибут метрики.
Формулировка замечания: «Значение run_id уникально для каждого запуска и размножит временные ряды. Оставьте в метрике ограниченный признак этапа и статуса; идентификатор запуска перенесите в лог или трассу».
Это не только вопрос стоимости хранения. При высокой кардинальности запросы к метрикам становятся тяжелее, дашборды — менее понятными, а сигнал об общей проблеме теряется среди уникальных запусков.
Свяжите метрику с действием дежурного
Метрика без порога или правила реакции может быть полезна для анализа, но сама по себе не гарантирует, что сбой заметят вовремя. На ревью для каждого важного сигнала спросите: кто получит уведомление, какое состояние оно означает и что этот человек должен проверить первым?
Практический чек-лист для ревью:
- Проверьте границы этапов. Можно ли отличить задержку на входе от долгой обработки и ошибки публикации? Проверка пройдена, если сигнал указывает на этап, а не только на общий статус конвейера.
- Проверьте свежесть результата. Измеряется ли время последней успешной публикации? Проверка пройдена, если отсутствие новых данных тоже заметно, а не выглядит как нулевое число ошибок.
- Проверьте диапазон объёма. Учитываются ли допустимые нулевые результаты и ожидаемые сезонные колебания? Проверка пройдена, если порог не подменяет бизнес-правило случайной константой.
- Проверьте повторные попытки. Видно ли, что задача сначала падала, а затем восстановилась, или исчерпала повторы? Проверка пройдена, если временная ошибка не стирается из истории инцидента.
- Проверьте путь от алерта до причины. Есть ли ссылка на подходящий дашборд, логи или трассу и понятен ли ключ поиска? Проверка пройдена, если дежурному не приходится угадывать, какой запуск расследовать.
Если уведомление срабатывает только после окончательного отказа, это может быть слишком поздно для задач с жёстким сроком доставки. И наоборот, тревога на каждый автоматический повтор создаёт шум, если кратковременные сбои штатны и не влияют на срок. Отдельно оцените, должна ли команда узнавать о восстановившемся запуске: это зависит от требований к надёжности и стоимости пропуска промежуточных ошибок.
Что ломается в проде
Пустая выгрузка считается успехом. Техническая запись прошла, но потребитель получил пустой набор. Нужна проверка содержимого, согласованная с правилами данных: ноль строк может быть корректен для одного источника и аварией для другого.
Устаревание не вызывает тревогу. Алерт следит за ошибками, но задание просто перестало запускаться. Для периодического конвейера важен сигнал о возрасте последнего результата или о пропущенном ожидаемом окне, а не только счётчик исключений.
Повторы маскируют систематическую проблему. Задание в итоге зелёное, но почти каждый запуск проходит через повтор. Если важна стабильность или время доставки, частоту повторов стоит видеть отдельно от окончательных отказов.
Сообщение нельзя связать с конкретным запуском. В метрике нет уникального контекста из-за ограничений кардинальности, а в логах нет устойчивого идентификатора. Разделяйте роли сигналов: метрики показывают тенденцию, а логи и трассы помогают найти конкретный запуск.
В алерт попадают данные пользователей. Метки и текст ошибки могут содержать имена файлов, адреса или фрагменты входа. Проверьте, какие данные попадают в телеметрию, кто имеет к ней доступ и как долго она хранится. Не отправляйте содержимое строк ради удобства отладки.
Сноска. Кардинальность — число уникальных сочетаний меток у метрики. Например, метрика с ограниченными значениями статуса создаёт сравнительно мало рядов, а добавление уникального идентификатора каждого запуска резко увеличивает их число.
Что делать дальше
На следующем ревью выберите один критичный набор данных и проследите путь от входного события до публикации результата. Зафиксируйте допустимую задержку, критерий полноты и владельца алерта; затем проверьте на тестовом сбое, что уведомление срабатывает и приводит к нужным логам или трассе. После запуска следите за долей повторов, возрастом последнего результата и числом ложных тревог. Эти показатели покажут, помогает ли мониторинг управлять конвейером, а не просто украшает дашборд.
Контент-конвейер: Из одной идеи — текст, изображение, озвучка и ролик. Один заказ вместо четырёх.
Спросить за 60 ₽Источники: OpenTelemetry Metrics — спецификация, Prometheus: практики именования метрик и рекомендации
Частые вопросы
Нужны ли отдельные метрики для каждого этапа конвейера?
Можно ли добавить идентификатор запуска в метку метрики?
Что мониторить, если задача может законно выдать ноль строк?
Что делать, если у меня другая версия OpenTelemetry?
Как понять, что алерт в проде настроен правильно?
Нужно ли оповещать о каждом повторе задачи?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.