Мультимодальные агенты: когда ИИ видит экран и слышит звонок
Модели вроде GPT-4o, Gemini и Claude научились разбирать картинки, скриншоты и звук в одном запросе. Разбираем, что реально работает, что пока сырое и во сколько это обходится.
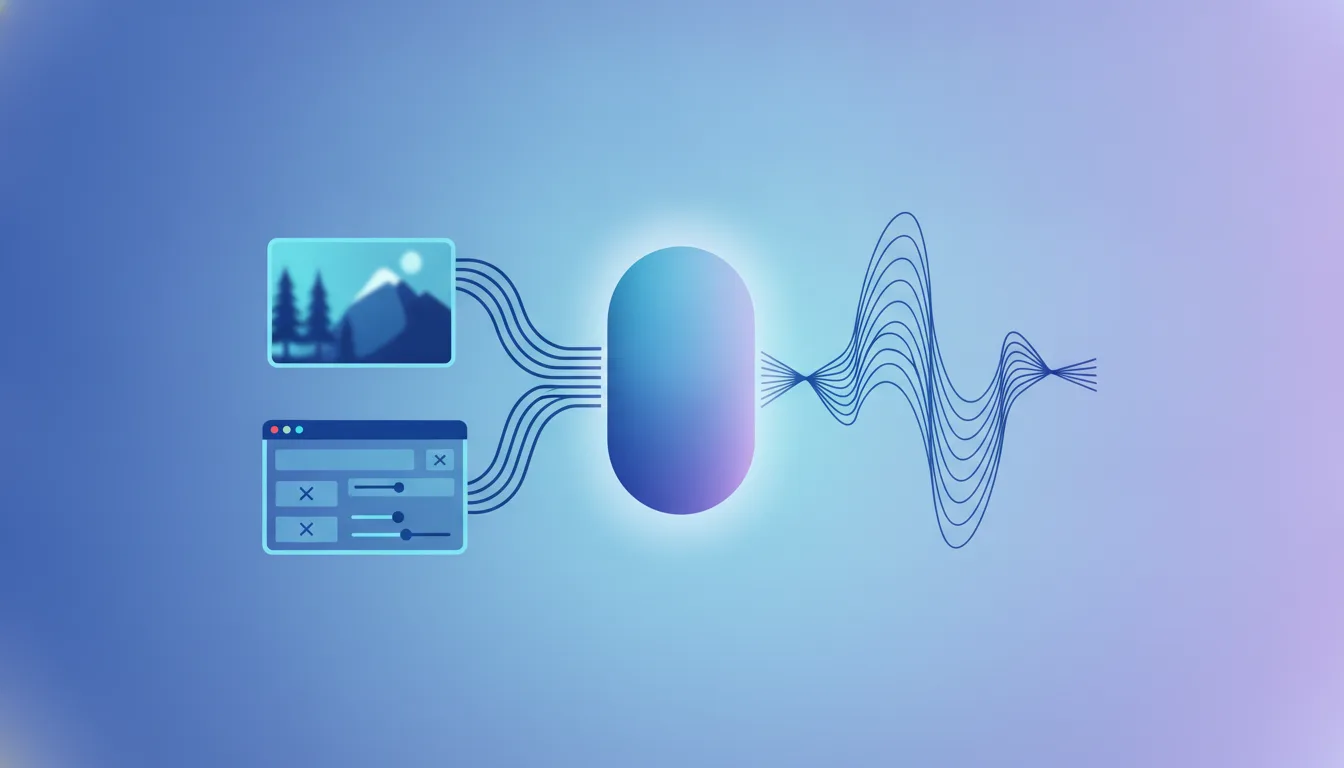
Ещё пару лет назад чат-бот принимал только текст: чтобы описать ему график или голосовое сообщение, вы сами пересказывали содержимое словами. Сейчас крупные модели принимают на вход изображение, аудио, а иногда и видеокадры, и отвечают в том же диалоге, где вы задали вопрос текстом. OpenAI показала GPT-4o с обработкой изображений и голоса в мае 2024 года, Google развивает линейку Gemini с мультимодальным вводом, Anthropic добавила разбор изображений в Claude 3. Разница между «мультимодальной моделью» и «мультимодальным агентом» простая: агент не просто описывает картинку, а делает на её основе следующий шаг — кликает по элементу на скриншоте, вытаскивает цифру из чека, переводит распознанную речь в задачу.
Что именно умеют эти модели
Под «мультимодальностью» скрываются очень разные вещи, и путать их — прямой путь к разочарованию на проде. Разбор изображения (модель получает картинку и текст) устоялся лучше всего: распознавание документов, скриншотов интерфейсов, схем, диаграмм. Аудио сложнее. Одни модели переводят звук в текст отдельным движком, а потом кормят текст языковой модели, другие — вроде голосового режима GPT-4o — работают со звуком напрямую, что снижает задержку и сохраняет интонацию.
Агентная надстройка добавляет к этому цикл действий. Типичный сценарий: агент получает скриншот, находит на нём нужную кнопку, возвращает координаты или команду, интерфейс выполняет клик, агент видит новый экран. Это то, на что нацелены функции вроде компьютерного управления у Anthropic (Claude «computer use», представлена в октябре 2024 года как бета) и аналогичные эксперименты у конкурентов. Важно: на момент написания это ранние, нестабильные функции, а не готовый продукт для критичных задач.
Где проходит граница надёжности
Распознавание печатного текста на скриншоте работает уверенно. Чтение рукописного текста, мелких таблиц, размытых фото чеков — заметно хуже, и здесь модель охотно «додумывает» цифры. Для финансовых и юридических данных это критично: галлюцинация в сумме или дате счёта опаснее, чем честное «не могу разобрать».
Сравнение подходов у трёх основных игроков
Ниже — сопоставление того, что заявлено официально. Конкретные лимиты и цены меняются, поэтому перед интеграцией сверяйте их на страницах документации, а не по этой таблице.
| Возможность | OpenAI (GPT-4o и линейка) | Google Gemini | Anthropic Claude 3/3.5 |
|---|---|---|---|
| Ввод изображений | да | да | да |
| Прямой ввод аудио | да, голосовой режим | да, в части моделей | нет прямого аудио-ввода |
| Ввод видео | покадрово | заявлена работа с видео | покадрово через изображения |
| Управление интерфейсом | экспериментально | экспериментально | Claude computer use (бета) |
| Доступ | API и подписка | API и подписка | API и подписка |
Таблица нарочно не содержит цифр по цене и размеру контекстного окна1: они пересматриваются едва ли не ежеквартально, и зафиксированное здесь число устареет раньше, чем вы дочитаете. Актуальные значения — только на официальных страницах тарифов.
Мультимодальный агент полезен ровно настолько, насколько вы готовы проверять его вывод. На распознавании интерфейса — экономит часы. На извлечении сумм из документов без человека в цикле — создаёт риск, который дороже экономии.
Сколько это стоит и как считается
Главная ловушка бюджета — картинки и аудио тарифицируются не так, как текст. Изображение разбивается на фрагменты (тайлы), и чем оно крупнее и детальнее, тем больше токенов уходит на один запрос. Скриншот в высоком разрешении может стоить как несколько абзацев текста. Аудио считается по длительности или по токенам в зависимости от провайдера.
Практические выводы для тех, кто закладывает бюджет:
- сжимайте и обрезайте изображения до реально нужной области перед отправкой — это прямая экономия на токенах;
- для длинных аудио сначала прикиньте стоимость на коротком фрагменте, а потом умножайте;
- кэшируйте повторяющиеся системные подсказки, если провайдер это поддерживает;
- для массового распознавания однотипных документов сравните облачную модель с узкоспециализированным OCR — иногда он дешевле и точнее.
Кому это пригодится и кому нет
Мультимодальный агент — не универсальное улучшение. Есть сценарии, где он экономит заметное время, и есть, где добавляет только риск и счёт за токены.
Где заходит хорошо
- Поддержка пользователей. Клиент присылает скриншот ошибки — агент читает текст на экране и подсказывает шаг. Ошибка распознавания здесь не фатальна, человек рядом.
- Черновая обработка документов. Первичная сортировка входящих сканов, извлечение полей с обязательной проверкой человеком перед проводкой.
- Доступность. Озвучивание содержимого экрана, описание изображений для незрячих пользователей.
- Прототипы автоматизации интерфейсов. Демо и внутренние инструменты, где сбой не бьёт по клиенту.
Где пока не стоит
- Бухгалтерия и финансы без проверки. Автопроводка сумм, распознанных с фото чека, — прямой путь к ошибке в отчётности.
- Юридически значимые данные. Даты, номера, реквизиты, где галлюцинация имеет цену.
- Критичная автоматизация в проде. Управление реальным интерфейсом банка, платежей, инфраструктуры — функции ещё в статусе беты.
- Медицинская интерпретация. Разбор снимков и анализов — не задача для чат-агента общего назначения.
С чего начать проверку под свою задачу
- Соберите 20–30 реальных примеров ваших изображений или аудио, включая плохие: размытые, косые, с шумом.
- Прогоните их через кандидатов и вручную посчитайте долю верных ответов — не по общим бенчмаркам, а по вашим данным.
- Отдельно проверьте поведение на нераспознаваемом входе: честно отказывается модель или выдумывает ответ.
- Оцените стоимость одного запроса на реальном размере файлов, а не на тестовой мелочи.
- Решайте, где обязателен человек в цикле, и закрепите это до запуска, а не после первого инцидента.
1 Контекстное окно — максимальный объём данных (текста, а в мультимодальных моделях и токенов от изображений и аудио), который модель удерживает в рамках одного запроса. Чем оно больше, тем длиннее документ или диалог модель обрабатывает за раз, но и стоимость запроса растёт.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: OpenAI — Hello GPT-4o, Anthropic — Introducing computer use, a new Claude 3.5 Sonnet
Частые вопросы
Чем мультимодальный агент отличается от обычной модели с распознаванием картинок?
Можно ли доверять извлечению цифр из чеков и счетов?
Сколько стоит обработка одного изображения?
Какая модель распознаёт изображения лучше всех?
Умеют ли эти агенты сами управлять компьютером и кликать по кнопкам?
Обязательно ли платить за подписку, чтобы попробовать?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.