N+1 в ORM: как найти и убрать лишние запросы
Список из 50 элементов, а под капотом — 51 запрос к базе. Разбираем классическую проблему N+1 в ORM: почему она возникает из-за ленивой загрузки, как найти её через Django Debug Toolbar, gem bullet или логирование SQL, и как исправить через select_related, prefetch_related, joinedload и паттерн DataLoader — с примерами кода на Python, SQL и TypeScript.
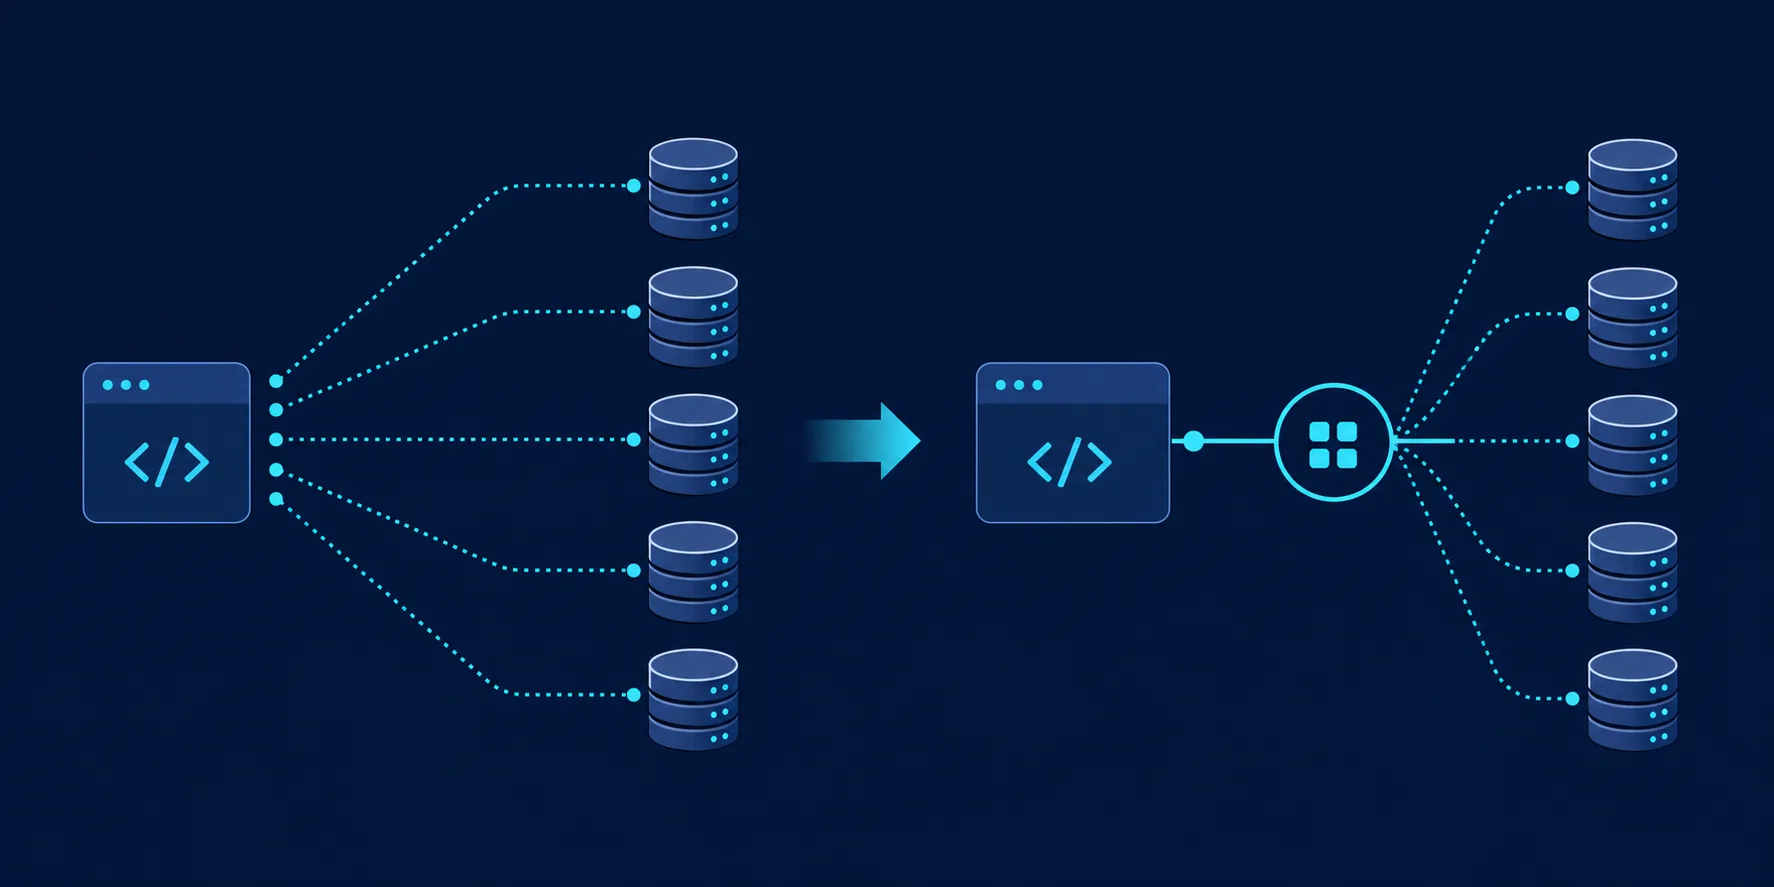
N+1 — это, пожалуй, самая частая причина, по которой страница, отлично работавшая на тестовых данных, начинает загружаться секундами на проде. Проблема коварна тем, что код выглядит абсолютно нормально, тесты зелёные, а под капотом при выводе списка из 50 элементов улетает не 2 запроса к базе, а 51. Разберём, откуда берётся N+1, как его найти и как убрать — с примерами на Django ORM, SQLAlchemy и Prisma.
Что такое N+1 и откуда он берётся
Название точно описывает суть: 1 запрос, чтобы получить список из N объектов, плюс ещё N запросов — по одному на каждый объект, чтобы подтянуть связанные данные. Классический пример — вывод списка авторов вместе с количеством их книг.
# Django ORM
authors = Author.objects.all()  # 1 запрос
for author in authors:
    print(author.books.count())  # +1 запрос на каждого автора
Если авторов 50 — итого 51 запрос вместо одного-двух. Проблема возникает из-за ленивой загрузки (lazy loading): ORM по умолчанию не подтягивает связанные объекты сразу, а делает это только в момент обращения к атрибуту — то есть внутри цикла, где вы этого не видите на уровне синтаксиса.
Ленивая загрузка отлично экономит ресурсы, когда связанные данные не нужны. Но она же превращается в источник проблем, как только к связанным данным обращаются внутри цикла — именно там количество запросов начинает расти линейно вместе с размером выборки.
Как N+1 маскируется в реальном коде
Чаще всего проблема прячется не в одной строке, а в цепочке абстракций — сериализаторе, шаблоне или вложенном компоненте, где не видно всего цикла целиком.
В Django REST Framework — классика жанра, вложенный сериализатор:
class BookSerializer(serializers.ModelSerializer):
    class Meta:
        model = Book
        fields = ['title']

class AuthorSerializer(serializers.ModelSerializer):
    books = BookSerializer(many=True, read_only=True)  # книги подтягиваются лениво

    class Meta:
        model = Author
        fields = ['name', 'books']
Если вьюха просто отдаёт Author.objects.all(), каждый вызов author.books внутри BookSerializer — это отдельный запрос.
В Django-шаблоне — то же самое, только ещё незаметнее:
{% for author in authors %}
    <p>{{ author.name }}: {{ author.books.count }} книг</p>
{% endfor %}
Как найти N+1 в проекте
Прежде чем чинить, нужно увидеть проблему — на глаз посчитать количество SQL-запросов почти невозможно.
- Django Debug Toolbar — показывает точное число запросов на странице и дублирующиеся SQL-запросы прямо в дебаг-панели браузера;
- nplusone — библиотека, которая ловит N+1 автоматически и бросает исключение или пишет предупреждение в лог при первом же обращении к ленивому атрибуту в цикле;
- Rails: gem bullet — аналог для ActiveRecord, подсвечивает как N+1, так и избыточные
includes, которые не используются; - Логирование SQL напрямую — быстрый способ без сторонних библиотек:
import logging

logging.basicConfig()
logging.getLogger('django.db.backends').setLevel(logging.DEBUG)- APM-инструменты (New Relic, Datadog, Sentry Performance) — показывают количество запросов на транзакцию в проде, где локально проблему часто не видно из-за маленького объёма тестовых данных.
Как исправить: eager loading
Решение — заранее сообщить ORM, что связанные данные понадобятся, чтобы она подтянула их одним (или несколькими) запросами вместо N.
Django ORM: select_related и prefetch_related
Для связей «многие-к-одному» и «один-к-одному» используется select_related — он делает SQL JOIN и получает всё одним запросом:
books = Book.objects.select_related('author').all()
for book in books:
    print(book.author.name)  # автор уже загружен, доп. запроса нет
Для связей «один-ко-многим» и «многие-ко-многим» JOIN неэффективен (данные дублируются), поэтому используется prefetch_related — он делает отдельный дополнительный запрос, но только один на всю выборку:
authors = Author.objects.prefetch_related('books')
for author in authors:
    for book in author.books.all():
        print(book.title)  # книги уже в кэше, доп. запросов нет
Итого — 2 запроса вместо 51, независимо от того, сколько авторов в выборке.
SQLAlchemy: joinedload и selectinload
from sqlalchemy.orm import selectinload

# Плохо: N+1
authors = session.query(Author).all()
for author in authors:
    print(author.books)  # лениво подгружает книги на каждой итерации

# Хорошо: eager loading
authors = (
    session.query(Author)
    .options(selectinload(Author.books))
    .all()
)
for author in authors:
    print(author.books)  # уже загружено
joinedload работает через JOIN (аналог select_related), selectinload — через отдельный SELECT ... IN (...) (аналог prefetch_related). Для связей «один-ко-многим» selectinload почти всегда предпочтительнее — он не дублирует строки родительского объекта.
Prisma (Node.js / TypeScript)
// Плохо: N+1
const authors = await prisma.author.findMany();
for (const author of authors) {
  const books = await prisma.book.findMany({
    where: { authorId: author.id },
  });
}

// Хорошо: eager loading через include
const authors = await prisma.author.findMany({
  include: { books: true },
});
Сравнение по ORM
| ORM / фреймворк | Связь «многие-к-одному» | Связь «один-ко-многим» / M2M |
|---|---|---|
| Django ORM | select_related() | prefetch_related() |
| SQLAlchemy | joinedload() | selectinload() / subqueryload() |
| Ruby on Rails (ActiveRecord) | includes() / eager_load() | includes() / preload() |
| Laravel (Eloquent) | with() | with() |
| Prisma | include | include |
| TypeORM | relations: [] / leftJoinAndSelect() | relations: [] |
| Hibernate / JPA | JOIN FETCH / @EntityGraph | JOIN FETCH / @BatchSize |
Когда JOIN не подходит: паттерн DataLoader
В GraphQL-резолверах классический eager loading часто не работает, потому что заранее неизвестно, какие поля запросит клиент. Здесь решают проблему батчингом запросов внутри одного тика event loop — паттерн DataLoader:
const bookLoader = new DataLoader(async (authorIds: readonly number[]) => {
  const books = await prisma.book.findMany({
    where: { authorId: { in: [...authorIds] } },
  });
  return authorIds.map(id => books.filter(b => b.authorId === id));
});

// В резолвере
const author = { books: () => bookLoader.load(author.id) };
DataLoader собирает все вызовы .load() за один тик event loop и делает один пакетный SQL-запрос вместо N отдельных — даже если резолверы для каждого автора вызываются независимо.
Не превращайте это в преждевременную оптимизацию
Не любой цикл с обращением к связанным данным — проблема. Если N заведомо маленькое и постоянное (например, вывод карточки одного заказа с тремя товарами), добавлять prefetch_related ради экономии одного запроса — лишнее усложнение кода. N+1 становится реальной проблемой там, где N растёт вместе с объёмом данных: списки, пагинация, экспорт, дашборды.
Тестируем, чтобы N+1 не вернулся
Лучший способ не откатиться к N+1 после рефакторинга — зафиксировать ожидаемое число запросов в тестах:
def test_author_list_no_n_plus_one(self):
    Author.objects.bulk_create([Author(name=f'A{i}') for i in range(10)])
    with self.assertNumQueries(2):  # ожидаем ровно 2 запроса, а не 11
        list(Author.objects.prefetch_related('books'))
Если позже кто-то уберёт prefetch_related из вьюхи, тест упадёт раньше, чем проблему заметят пользователи.
Итог
N+1 почти никогда не виден в момент написания кода — он проявляется только на реальном объёме данных, когда цикл по списку начинает делать по одному запросу на итерацию. Лечится он не сложно: select_related/prefetch_related в Django, joinedload/selectinload в SQLAlchemy, include в Prisma и аналогичные механизмы eager loading в любом другом ORM. Куда важнее — научиться находить проблему до продакшена: профилировщиком, дебаг-тулбаром или тестом, который считает количество запросов явно.
IT-архитектор / SQL-оптимизатор: Поиск N+1, оптимизация запросов, code review, поиск багов.
Спросить за 20 ₽Частые вопросы
Всегда ли select_related быстрее, чем prefetch_related?
Можно ли автоматически ловить N+1 в проде, а не только локально?
Решает ли кэширование проблему N+1?
Актуальна ли проблема N+1 для NoSQL-баз, например MongoDB?
Как быть, если заранее неизвестно, какие связанные поля понадобятся (как в GraphQL)?
Материал носит справочный характер. Нормы и лимиты меняются — проверьте актуальную редакцию документа на дату обращения.