Обобщение в обучении с подкреплением: как его измеряют
Агент, обученный проходить уровень игры без единой ошибки, проваливается на новом уровне с той же механикой. Разбираем, как исследователи научились отделять запоминание от настоящего обобщения в RL.
Проблема, которую долго не замечали
Классическая схема обучения с подкреплением выглядит так: агент играет в среду, получает награду, обновляет политику и постепенно набирает всё больше очков. Долгое время именно рост награды на этой самой среде считали доказательством того, что агент чему-то научился. Но в 2018–2019 годах несколько команд показали неприятную вещь: агент, набравший максимум на конкретных уровнях, при переносе на новые уровни той же игры проваливается почти до случайного поведения.
Это ровно то, что в supervised learning называют переобучением, только в RL его гораздо труднее заметить. В обычной классификации есть отдельная тестовая выборка. В RL агент обычно учится и проверяется на одной и той же среде, поэтому запоминание конкретных траекторий выдают за компетентность.
Почему это не абстрактная придирка
Если вы обучаете политику для робота-манипулятора или для торгового бота, вам важно поведение в ситуациях, которых в обучении не было. Агент, который выучил наизусть последовательность действий для одной раскладки объектов, бесполезен, как только раскладка меняется. Цена ошибки здесь — не просадка метрики в статье, а сломанная деталь или потерянные деньги.
Как вообще замерить обобщение
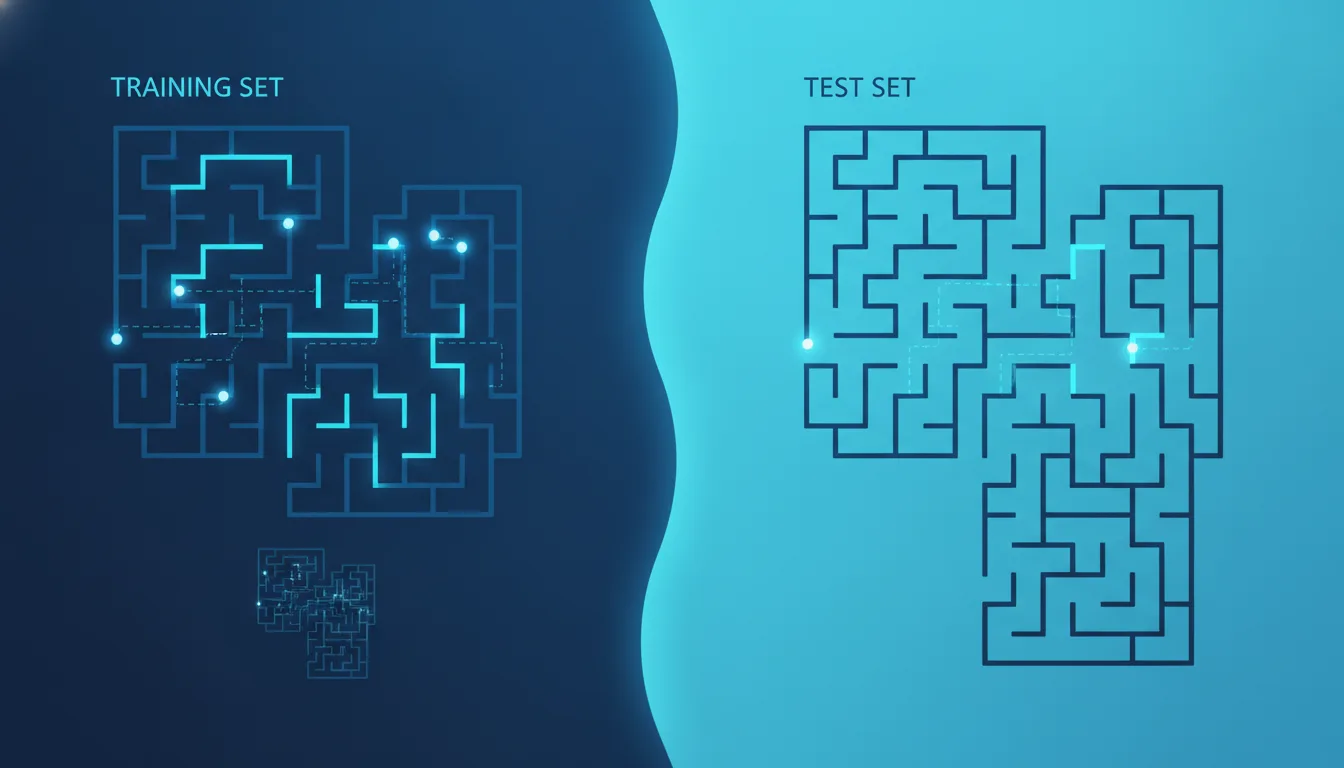
Ключевая идея простая: разнести обучение и проверку на разные наборы сред. Для этого нужны среды, которые можно порождать процедурно — то есть генерировать много вариантов по одному шаблону с общей механикой, но разной геометрией, текстурами, расположением объектов.
Дальше схема повторяет классический train/test split:
- Генерируется большой пул уровней с фиксированным seed.
- Часть уровней (например, первые несколько сотен или тысяч) отдаётся под обучение.
- Остальные уровни агент не видит во время обучения вообще.
- После обучения политику прогоняют на невиданных уровнях и сравнивают среднюю награду с обучающей.
Разрыв между наградой на обучающих и тестовых уровнях — это generalization gap. Чем он больше, тем сильнее агент опирается на запоминание, а не на переносимую стратегию.
Награда на среде, где агент учился, не говорит почти ничего о том, справится ли он с новой раскладкой. Показательна только награда на уровнях, которых он не видел.
Бенчмарки, на которых это проверяют
Вокруг задачи выросла отдельная линейка процедурно генерируемых бенчмарков. Наиболее известны несколько.
| Бенчмарк | От кого | Что даёт |
|---|---|---|
| CoinRun | OpenAI | Упрощённый платформер, первый явно заточенный под замер обобщения |
| Procgen Benchmark | OpenAI | 16 процедурно генерируемых игр, разделение train/test уровней из коробки |
| Meta-World | академические лаборатории | Набор манипуляционных задач для проверки переноса между задачами |
Procgen стал фактически стандартом именно потому, что позволяет фиксировать число обучающих уровней. Можно взять 200 уровней, 10 000 уровней или бесконечную генерацию и посмотреть, как меняется разрыв между обучением и тестом. Точные протоколы и число уровней по каждой игре стоит сверять в описании самого бенчмарка, потому что настройки в разных работах отличаются.
Что показывают эти замеры
Общий вывод повторяется из работы в работу: чем больше разнообразных уровней в обучении, тем лучше агент обобщается и тем меньше разрыв. Обучение на десятке уровней даёт почти идеальную награду на них и провальную на новых. Расширение до тысяч уровней разрыв сокращает, хотя редко закрывает полностью.
Что помогает обобщению
Приёмы, которые в supervised learning считаются рутиной, в RL долго игнорировали. Теперь их проверили на процедурных бенчмарках, и часть действительно снижает generalization gap:
- Аугментация наблюдений — случайные сдвиги, обрезки, изменение цвета кадра заставляют политику опираться на структуру, а не на пиксельные совпадения.
- Регуляризация — dropout, L2, batch normalization в свёрточном энкодере.
- Разнообразие обучающих уровней — самый надёжный рычаг: больше уникальных сред почти всегда лучше, чем более длинное обучение на нескольких.
- Разделение представления и политики — обучение устойчивого энкодера отдельно от управляющей части.
Важная оговорка: ни один из приёмов не универсален. Аугментация, которая помогает в одной игре Procgen, в другой может уронить результат, потому что ломает признак, который для этой игры был существенным. Поэтому в замерах обобщения принято усреднять по всему набору игр, а не подбирать лучший результат на одной.
Почему цифру обобщения так легко подделать
Самая частая ловушка — утечка тестовых уровней в обучение через подбор гиперпараметров. Если вы много раз крутите настройки, глядя на тестовую награду, вы фактически обучаетесь на тесте руками исследователя. Формально train/test split соблюдён, по существу — нет.
Вторая ловушка — сравнение методов при разном бюджете взаимодействия со средой. Агент, которому дали в десять раз больше шагов, покажет цифру лучше не потому, что он лучше обобщает, а потому что просто больше играл. Корректное сравнение фиксирует и число уровней, и число шагов.
Termin: generalization gap
Generalization gap — разница между качеством модели на данных (или средах), которые она видела при обучении, и на тех, которые она видит впервые. Большой разрыв означает, что модель запомнила обучающую выборку, а не выучила переносимую закономерность.
Практический итог для того, кто обучает RL-агента: не верьте кривой награды на обучающей среде. Отделите хотя бы часть уровней или конфигураций, не показывайте их до самого конца и смотрите именно на них. Иначе вы измеряете память агента, а не его способность действовать в новой ситуации.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: Procgen Benchmark (OpenAI), Quantifying Generalization in Reinforcement Learning (OpenAI)
Частые вопросы
Чем обобщение в RL отличается от обобщения в обычном обучении с учителем?
Почему нельзя просто смотреть на итоговую награду?
Какой бенчмарк выбрать для замера обобщения?
Что сильнее всего улучшает обобщение агента?
Можно ли случайно завысить цифру обобщения, не обманывая специально?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.