Пять AI-агентов в одном пайплайне: как это собирают на практике
Мультиагентные системы перестали быть демо с одним чат-ботом. Разбираем, как из пяти узкоспециализированных агентов собирают рабочий пайплайн, где узкие места и сколько это стоит в токенах.
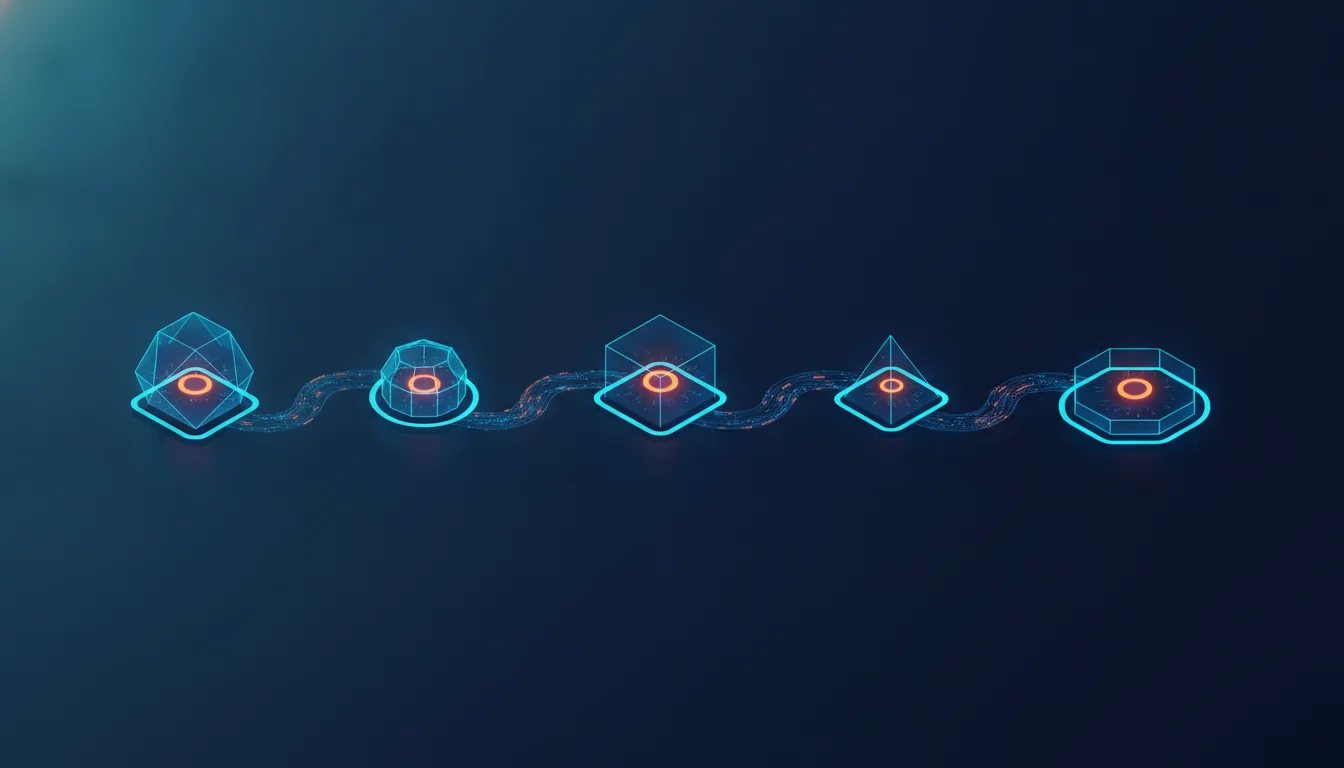
Одиночный агент, который «умеет всё», на практике проигрывает связке из нескольких узких. Это уже не гипотеза с форумов, а рабочий паттерн: вместо одной модели с раздутым системным промптом команды разбивают задачу на этапы и на каждый ставят отдельного агента1 — со своим набором инструментов, своим контекстом и своей моделью. Ниже — как выглядит такой пайплайн из пяти агентов, чем оркестраторы вроде LangGraph, CrewAI и AutoGen отличаются друг от друга и во что это обходится по токенам.
Что значит «пять агентов в одном пайплайне»
Речь про обработку одного бизнес-запроса цепочкой специализированных агентов, где выход одного становится входом следующего. Типичный набор для задачи «принять входящий запрос клиента и подготовить ответ с данными» выглядит так:
- Роутер — классифицирует запрос и решает, каким веткам его отдать. Обычно самая дешёвая модель, потому что задача узкая.
- Ресёрчер — тянет данные: ходит в базу знаний через RAG2, дёргает внутренние API, собирает контекст.
- Аналитик — сверяет найденное с правилами, считает, проверяет непротиворечивость.
- Райтер — превращает структурированный результат в текст для человека.
- Критик (валидатор) — проверяет ответ на галлюцинации и соответствие политике, при провале возвращает задачу назад.
Ключевая деталь — не сами роли, а связь между ними: кто кого вызывает, что происходит при ошибке и как гоняется состояние. Именно это отличает пайплайн от пяти отдельных промптов, склеенных вручную.
Агент без внятной передачи состояния — это не агент, а функция с плохим стектрейсом. Половина работы в мультиагентной системе уходит не на промпты, а на то, чтобы понимать, где именно всё сломалось.
Как связывают агентов между собой
Есть три распространённых топологии, и выбор между ними определяет и стоимость, и предсказуемость.
Линейная цепочка
Агенты идут строго друг за другом: роутер → ресёрчер → аналитик → райтер → критик. Просто отлаживать, легко считать стоимость. Минус — если критик завернул ответ, приходится прогонять цепочку заново, а это лишние вызовы модели.
Граф с ветвлением
Роутер направляет запрос в одну из веток в зависимости от типа. Часть агентов вообще не вызывается для конкретного запроса — экономия на токенах. Здесь и работают фреймворки с явным описанием состояния и переходов.
Иерархия с супервайзером
Отдельный агент-менеджер сам решает, кого из подчинённых позвать и когда остановиться. Гибко, но непредсказуемо по числу шагов: без жёсткого лимита итераций такой супервайзер способен уйти в цикл и сжечь бюджет за один запрос.
Чем отличаются фреймворки-оркестраторы
Собирать связку руками на голых вызовах API можно, но на пятом агенте вы неизбежно напишете свой велосипед для передачи состояния и ретраев. Поэтому чаще берут готовый оркестратор. Возможности и статус фреймворков меняются быстро — сверяйтесь с их документацией перед выбором.
| Фреймворк | Модель управления | Сильная сторона | Ограничение |
|---|---|---|---|
| LangGraph | Явный граф состояний, ребра и условия задаются кодом | Контроль над потоком, чекпоинты, повтор с любого узла | Больше кода на старте, требует понимания графовой модели |
| CrewAI | Роли и задачи, декларативное описание команды | Быстрый старт, читаемая структура «команды агентов» | Меньше контроля над низкоуровневым потоком |
| AutoGen | Диалог агентов между собой, в том числе супервайзер | Гибкое взаимодействие, сценарии с обсуждением | Труднее предсказать число шагов и итоговую стоимость |
Общий принцип: чем больше свободы вы даёте агентам самим решать, кого звать, тем сложнее прогнозировать счёт. Для продакшена обычно выбирают явный граф с жёсткими лимитами, а свободную оркестрацию оставляют для прототипов.
Где реально теряются деньги и время
Мультиагентный пайплайн платит за качество разбиения задачи двумя ресурсами — токенами и задержкой.
- Токены множатся. Каждый агент получает свой системный промпт и часть контекста. Пять агентов на один запрос — это пять отдельных обращений к модели, а при цикле «критик завернул» число вызовов растёт.
- Латентность копится. Линейная цепочка складывает задержки всех шагов. Если каждый агент отвечает 2–4 секунды, финальный ответ приходит через 10–20 секунд — для чата это ощутимо.
- Ошибки накапливаются. Неточность ресёрчера тянется дальше по цепочке, и критик в конце ловит уже не первопричину, а следствие.
- Модели стоят по-разному. Ставить топовую модель на каждый узел — самый быстрый способ раздуть счёт. Роутеру и валидатору обычно хватает модели попроще.
Практичный подход — считать стоимость не «за модель», а «за один пройденный пайплайн»: сложить токены всех пяти вызовов при типичном запросе и умножить на ожидаемый объём. Это единственная цифра, которая скажет, окупается ли схема.
Кому это пригодится, а кому нет
Пригодится, если:
- задача честно распадается на этапы с разной специализацией — например, «найти данные, проверить их, оформить ответ»;
- вам важна воспроизводимость и вы готовы логировать каждый шаг, чтобы разбирать сбои;
- часть шагов можно отдать дешёвой модели и сэкономить на топовой только там, где она нужна.
Не пригодится, если:
- запрос решается одним промптом — тогда пять агентов это оверинжиниринг, который добавит задержку и стоимость без выигрыша;
- критична скорость ответа в реальном времени, а бюджета на параллельные вызовы и кэширование нет;
- у вас нет ресурса на отладку — мультиагентная система требует наблюдаемости, иначе отлаживать её мучительно.
Хорошая проверка перед сборкой: если вы не можете нарисовать граф из пяти узлов на листе бумаги и объяснить, что происходит при ошибке в каждом, — вам пока не нужны пять агентов.
1 Агент — модель, которой дан не только текст, но и набор инструментов (поиск, вызов API, код) и цикл, в котором она сама решает, каким инструментом воспользоваться, пока не выполнит задачу.
2 RAG (retrieval-augmented generation) — подход, при котором модель перед ответом подтягивает релевантные документы из внешней базы и отвечает, опираясь на них, а не только на то, что «запомнила» при обучении.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: LangGraph — документация по мультиагентным графам, CrewAI — официальная документация
Частые вопросы
Пять агентов всегда лучше одного?
Насколько дороже мультиагентный пайплайн по сравнению с одним вызовом?
Какой фреймворк выбрать для начала?
Как не дать агенту-супервайзеру зациклиться и сжечь бюджет?
Можно ли собрать такой пайплайн без готового фреймворка?
Как отлаживать систему, где пять агентов вызывают друг друга?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.