RAG или агент с базой знаний: что выбрать под свою задачу
Классический RAG отвечает на вопрос по документам за один проход. Агент с доступом к той же базе умеет искать несколько раз, уточнять и проверять себя. Разбираем, где разница видна в деньгах и качестве ответов.
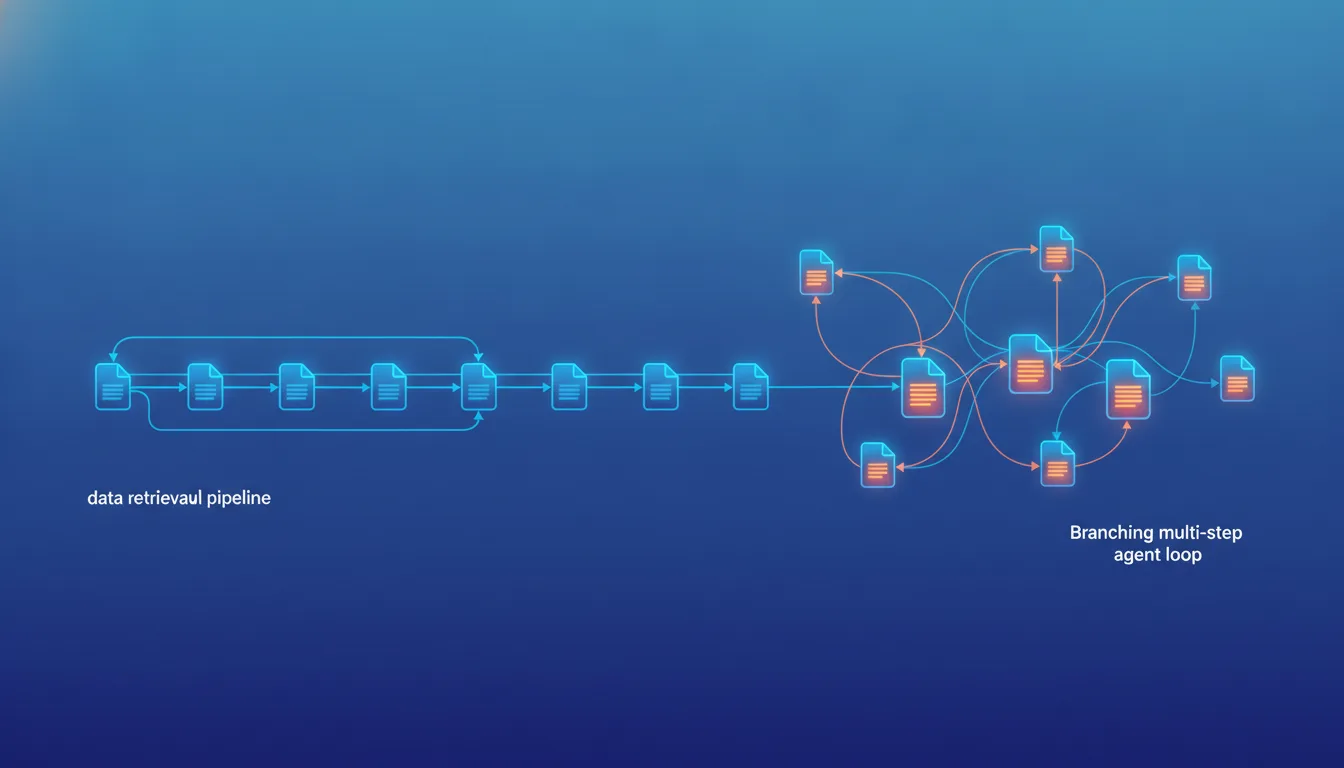
За последний год фраза «прикрутите RAG к нашим документам» превратилась в стандартный запрос от бизнеса к разработчикам. Но пока одни команды разворачивают классический пайплайн «поиск плюс генерация», другие уходят в сторону агентов, которые сами решают, сколько раз лезть в базу и какие ещё инструменты дёрнуть. Разница между этими подходами — не косметическая: она бьёт по стоимости запроса, скорости ответа и по тому, насколько часто система выдаёт правдоподобную чушь.
Что такое RAG в его классическом виде
RAG* в базовой сборке — это конвейер из двух шагов. Сначала система превращает вопрос пользователя в вектор, ищет по базе документов ближайшие по смыслу фрагменты, а затем подставляет найденное в промпт языковой модели. Модель отвечает, опираясь на переданный ей контекст, а не только на то, что запомнила при обучении.
Ключевое слово здесь — «один проход». Пользователь спросил, система один раз сходила в базу, один раз сгенерировала ответ. Это дёшево, предсказуемо по времени и легко отлаживается: если ответ плохой, вы смотрите, что попало в контекст, и правите либо поиск, либо промпт.
Слабое место тоже очевидно. Если вопрос требует собрать факты из трёх разных документов, а поиск вытащил только один, модель либо честно скажет, что данных не хватает, либо додумает недостающее. Классический RAG не умеет сказать себе «маловато, поищу ещё раз по-другому».
Агент с той же базой знаний
Агент** берёт тот же векторный индекс, но обращается с ним как с инструментом, а не как с обязательным шагом. Модель сама решает: нужен ли вообще поиск, как переформулировать запрос, стоит ли сходить в базу второй раз с уточнённой формулировкой, а потом сверить, хватает ли собранного для ответа.
На практике это выглядит как цикл: модель вызывает функцию поиска, читает результат, при необходимости вызывает её снова с другим запросом, может обратиться к другому источнику — например, к API с актуальными данными или к калькулятору — и только потом формирует ответ. Каждый такой шаг — это отдельный вызов модели, то есть отдельные токены и отдельные секунды ожидания.
RAG отвечает на вопрос «что написано в документах». Агент отвечает на вопрос «какой ответ правильный, и что для этого нужно найти». Первое дешевле, второе — надёжнее там, где одного поиска не хватает.
Сравнение по существу
Сводить всё к «агент лучше» неправильно: за гибкость вы платите деньгами и временем. Ниже — где именно проходит граница.
| Параметр | Классический RAG | Агент с базой знаний |
|---|---|---|
| Вызовов модели на запрос | Обычно один | От двух до десятка и больше |
| Стоимость запроса | Низкая, предсказуемая | Выше и плавает от вопроса к вопросу |
| Задержка ответа | Секунды | От нескольких секунд до десятков |
| Многошаговые вопросы | Плохо: один проход поиска | Хорошо: может искать итеративно |
| Предсказуемость поведения | Высокая, легко тестировать | Ниже, ветвлений больше |
| Отладка ошибок | Смотрим контекст и промпт | Смотрим цепочку решений агента |
| Доступ к внешним инструментам | Нет из коробки | Да, это основа подхода |
Стоимость: главный аргумент за RAG
Если классический RAG тратит на ответ один вызов модели, то агент на сложном вопросе может сделать пять-семь: несколько поисков, промежуточные рассуждения, финальная сборка. Умножьте это на количество запросов в день — и разница в счёте от провайдера API становится осязаемой. Для сценария «сотни тысяч однотипных вопросов в поддержке» лишние вызовы превращаются в реальные деньги.
Качество: главный аргумент за агента
Там, где ответ собирается из нескольких источников или требует уточнения, агент выигрывает за счёт итераций. Он может заметить, что первый поиск вернул нерелевантное, и переформулировать запрос. Классический RAG в той же ситуации отдаст то, что нашёл с первого раза, каким бы оно ни было.
Кому это пригодится, а кому нет
Выбор зависит не от моды, а от характера вопросов и бюджета на инференс.
- Берите классический RAG, если у вас FAQ-бот по базе инструкций, справка по документации, поиск по внутренней вики с короткими фактическими вопросами. Ответы находятся в одном-двух фрагментах, объём запросов большой, а бюджет ограничен.
- Берите агента, если вопросы аналитические («сравни условия по трём договорам», «собери историю по клиенту из разных систем»), если нужен доступ к внешним данным помимо базы, или если цена ошибки высокая и лишний проход поиска окупается.
- Не берите агента ради «на всякий случай»: если 90 процентов вопросов закрываются одним поиском, агент просто удорожит и замедлит то, что и так работало.
- Не берите чистый RAG, если жалобы пользователей звучат как «он не видит связи между документами» — это как раз симптом нехватки итераций.
Гибрид как рабочий компромисс
На практике многие команды не выбирают жёстко, а строят гибрид: простой вопрос обрабатывается одним проходом RAG, а если модель или отдельный классификатор считает запрос сложным — включается агентский цикл с несколькими поисками. Так вы платите за дорогой режим только там, где он оправдан.
С чего начать выбор
- Соберите реальные вопросы пользователей за неделю и разметьте, сколько из них требуют одного источника, а сколько — нескольких.
- Прикиньте объём запросов в сутки и умножьте на ожидаемое число вызовов модели в каждом подходе — так вы увидите разницу в счёте заранее.
- Замерьте допустимую задержку: если пользователь ждёт ответ в чате, десятки секунд агентского цикла могут оказаться неприемлемыми.
- Начните с классического RAG как с базовой линии. Переходите к агенту только там, где метрики качества упираются в потолок одного прохода.
* RAG (Retrieval-Augmented Generation) — подход, при котором языковая модель отвечает не по памяти, а по фрагментам документов, найденным под конкретный вопрос и подставленным в её контекст.
** Агент — надстройка над языковой моделью, которая позволяет ей самой вызывать инструменты (поиск, API, вычисления), читать результат и решать, что делать дальше, в несколько шагов.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Частые вопросы
RAG и агент — это взаимоисключающие подходы?
Насколько агент дороже классического RAG?
Уберёт ли агент галлюцинации модели?
Можно ли обойтись без базы знаний и просто дообучить модель?
С чего начать, если непонятно, что подойдёт?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.