ReAct против Chain-of-Thought: когда агенту нужны действия
Chain-of-Thought заставляет модель рассуждать вслух, ReAct добавляет к рассуждениям вызовы инструментов. Разбираем, где заканчивается одно и начинается другое и что выбрать под задачу.
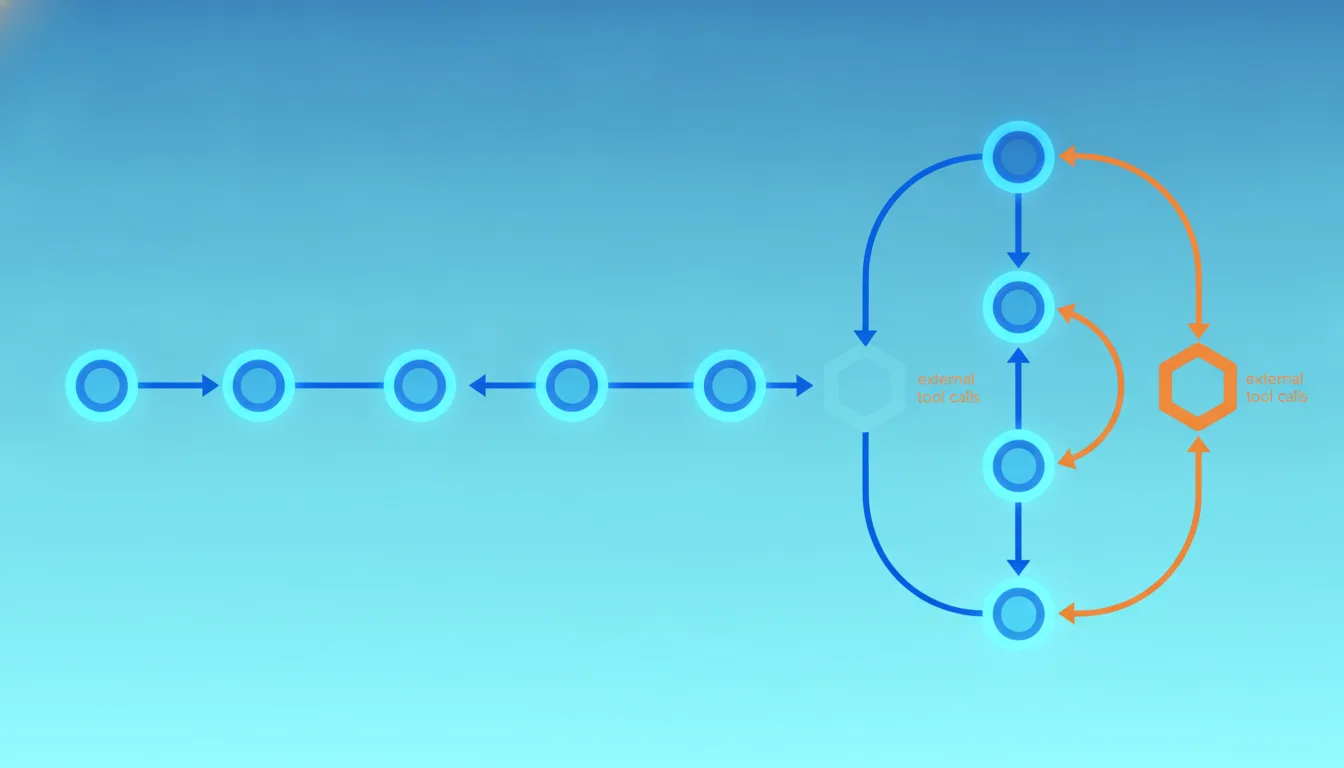
Chain-of-Thought (CoT) и ReAct — два подхода к тому, как заставить языковую модель думать перед ответом. Первый описан в статье Google Brain 2022 года «Chain-of-Thought Prompting Elicits Reasoning in Large Language Models», второй — в работе «ReAct: Synergizing Reasoning and Acting in Language Models» той же группы исследователей. Разница между ними — одна: может ли модель во время рассуждения обращаться к внешнему миру или рассуждает исключительно внутри собственного контекста. От этого выбора зависит, будет ли ваш агент выдавать красивую, но выдуманную цепочку логики — или проверять факты по ходу дела.
Что делает Chain-of-Thought
CoT — это приём промптинга, а не архитектура. Вы просите модель не выдавать ответ сразу, а расписать промежуточные шаги: «давай подумаем пошагово». Модель генерирует последовательность рассуждений, и на сложных задачах — арифметика, логика, многошаговые вопросы — это заметно повышает точность по сравнению с ответом «в лоб».
Ключевое ограничение: вся цепочка рассуждений живёт внутри одного прохода генерации. Модель не проверяет свои промежуточные выводы ни в поиске, ни в базе, ни калькулятором. Если на третьем шаге она ошиблась в дате или перемножила числа неверно, дальше она уверенно строит выводы на ложной посылке. CoT улучшает структуру рассуждения, но не спасает от галлюцинаций1 в фактах.
Chain-of-Thought делает мышление модели видимым. Он не делает его правильным — модель всё так же оперирует только тем, что уже лежит в её весах и в контексте.
Что добавляет ReAct
ReAct — сокращение от Reason + Act. Модель чередует три типа шагов: Thought (рассуждение), Action (вызов инструмента — поиск, API, калькулятор, обращение к базе), Observation (результат, который вернул инструмент). Затем цикл повторяется: новое рассуждение уже опирается на реальные данные из Observation.
Практический эффект: модель может остановиться посреди рассуждения, сходить в поиск, получить актуальную цифру и продолжить с ней. Это закрывает главную дыру CoT — оторванность от фактов. ReAct лежит в основе большинства современных агентных фреймворков: LangChain, LlamaIndex и подобные строят циклы примерно по этой схеме.
Как выглядит один цикл ReAct
- Thought: модель формулирует, что нужно узнать («мне нужен текущий курс, я его не знаю»).
- Action: вызывает инструмент с конкретными аргументами (search: «курс доллара ЦБ сегодня»).
- Observation: получает ответ инструмента и вставляет его в контекст.
- Цикл повторяется, пока модель не решит, что данных достаточно для финального ответа.
Чем они отличаются на практике
| Критерий | Chain-of-Thought | ReAct |
|---|---|---|
| Доступ к внешним данным | Нет | Есть (инструменты) |
| Проверка фактов по ходу | Нет | Да, через Observation |
| Число вызовов модели | Один проход | Несколько итераций подряд |
| Стоимость и латентность | Ниже | Выше — каждый цикл это новые токены |
| Риск застрять в петле | Отсутствует | Есть, нужен лимит шагов |
| Где силён | Замкнутая логика, математика, разбор текста в контексте | Задачи со свежими данными, многошаговый поиск |
Что выбрать под задачу
Простое правило: если всё, что нужно для ответа, уже есть в промпте или в весах модели — берите CoT. Он дешевле, быстрее и не может уйти в бесконечный цикл. Разбор договора, который вы прислали целиком, решение логической задачи, объяснение кода из контекста — это территория CoT.
Как только для ответа нужны данные, которых у модели нет — актуальная цена, содержимое конкретной страницы, результат вычисления, к которому нельзя доверять «на глаз», — нужен ReAct или другой агентный цикл с инструментами. Иначе модель не откажется отвечать, а придумает правдоподобную цифру.
Гибрид как норма
На деле граница размыта. Внутри шага Thought в ReAct модель по сути делает то же самое CoT-рассуждение — просто между шагами она умеет выходить наружу. Многие продакшн-агенты комбинируют: CoT для внутренней логики, вызовы инструментов там, где нужен факт, плюс жёсткий лимит на число итераций, чтобы агент не крутился в петле «думаю — ищу — думаю» на одном и том же запросе.
- Ставьте потолок шагов (например, 6–10) и обрабатывайте случай, когда лимит достигнут без ответа.
- Логируйте пары Action/Observation — без них дебажить агента почти невозможно.
- Ограничивайте набор инструментов: чем меньше выбор, тем реже модель вызывает лишнее.
- Для задач без внешних данных не тащите ReAct ради «современности» — вы платите за токены и латентность впустую.
Где обе схемы ломаются
CoT красиво выглядит, но длинная цепочка не гарантирует верного ответа: модель может выдать связное рассуждение к неверному итогу. ReAct добавляет свои риски — плохо описанный инструмент, кривой Observation, зацикливание, когда модель раз за разом делает один и тот же вызов. Ни один из подходов не отменяет проверку критичных ответов человеком, особенно там, где цена ошибки — деньги или юридические последствия.
1 Галлюцинация — выдуманный моделью факт, поданный как достоверный: несуществующая цитата, дата, цифра или ссылка. Модель генерирует статистически правдоподобный текст, а не проверенную истину.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: ReAct: Synergizing Reasoning and Acting in Language Models (arXiv), Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (arXiv)
Частые вопросы
ReAct всегда лучше Chain-of-Thought?
Можно ли использовать оба подхода вместе?
Почему ReAct дороже?
Что делать, чтобы ReAct-агент не зацикливался?
Спасает ли Chain-of-Thought от галлюцинаций?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.