Reptile и MAML: как модели учатся учиться на новых задачах
Мета-обучение обещает модели, которая осваивает новую задачу за несколько примеров. Reptile от OpenAI делает это без вычисления вторых производных — и почти не проигрывает MAML.
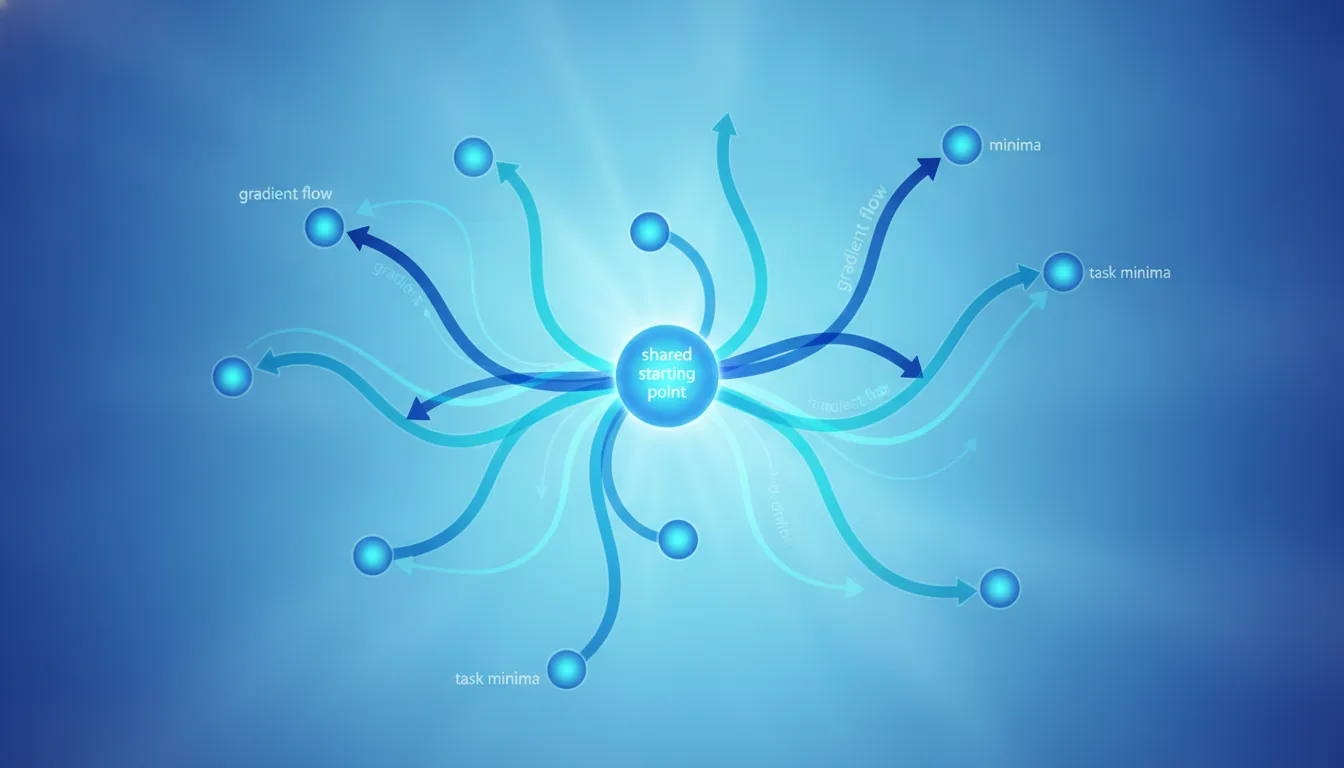
В 2017 году исследователи из Berkeley показали алгоритм MAML — Model-Agnostic Meta-Learning. Идея простая на словах: обучить не решать одну задачу, а быстро подстраиваться под новую за несколько шагов градиентного спуска. Проблема в том, что честный MAML требует дифференцировать через процесс обучения — то есть считать производные второго порядка. Это дорого по памяти и по времени. Год спустя команда OpenAI выпустила Reptile — алгоритм, который добивается сопоставимого результата, используя только градиенты первого порядка. Разница в реализации — несколько строк кода. Разница в стоимости — заметная.
Что такое мета-обучение и зачем оно нужно
Обычная нейросеть учится на большом наборе примеров одной задачи: миллион фотографий, чтобы отличать кошек от собак. Дайте ей новый класс — например, распознать конкретную породу по пяти снимкам — и она либо переобучится на этих пяти примерах, либо не сдвинется с места.
Мета-обучение (meta-learning1) меняет постановку. Вместо одной задачи модель видит распределение задач. На этапе мета-обучения ей показывают тысячи мелких задач, каждая — со своим маленьким обучающим и проверочным набором. Цель — найти такие начальные веса, из которых любая новая задача из того же распределения осваивается за считаные шаги.
Классический бенчмарк здесь — few-shot классификация: датасеты Omniglot (рукописные символы 50 алфавитов) и miniImageNet. Постановка формулируется как «N-way K-shot»: N классов, по K примеров на класс. 5-way 1-shot означает пять новых категорий и один пример на каждую.
MAML: учимся через обучение
MAML работает так. Берём текущие начальные веса. Для каждой задачи из батча делаем один-два шага градиентного спуска на её обучающих примерах — получаем адаптированные веса. Затем считаем ошибку этих адаптированных весов на проверочных примерах той же задачи. И вот эту ошибку минимизируем по исходным весам.
Ключевой момент: адаптированные веса — сами функция от начальных, через шаг градиента. Чтобы оптимизировать начальные веса по итоговой ошибке, нужно продифференцировать через шаг оптимизации. Отсюда вторые производные — гессианы. First-order MAML (FOMAML) — упрощение, где эти вторые производные просто отбрасывают. Авторы MAML отметили, что на практике FOMAML теряет мало в точности.
Reptile: ещё проще
Reptile отказывается от разделения на обучающую и проверочную части внутри задачи на этапе мета-обучения. Алгоритм умещается в несколько шагов:
- Берём начальные веса θ.
- Выбираем задачу и делаем на ней k шагов обычного SGD (не один, а несколько) — получаем веса W.
- Двигаем θ в сторону W: θ ← θ + ε·(W − θ).
- Повторяем на новых задачах.
Вся хитрость — в шаге 3. Мы не считаем градиент через процесс обучения. Мы просто смещаем начальную точку к тому месту, куда задача «утащила» веса за несколько шагов. При этом Reptile не требует ни второго прохода, ни разбиения примеров задачи на train/test для мета-обновления.
Интуиция Reptile: несколько шагов SGD на задаче сдвигают веса не только к решению этой задачи, но и в сторону, общую для близких задач. Усредняя такие сдвиги по многим задачам, вы находите точку, откуда до любой из них близко.
Математически авторы показывают, что разложение Reptile в ряд Тейлора содержит тот же член, что и MAML, — слагаемое, которое поощряет согласованность градиентов между разными минибатчами одной задачи. Именно оно отвечает за быструю адаптацию. То есть Reptile не грубый хак: он оптимизирует по сути ту же величину, только другим путём.
Чем платят и что получают
| Свойство | MAML | FOMAML | Reptile |
|---|---|---|---|
| Производные второго порядка | Да | Нет | Нет |
| Нужен отдельный test-набор в задаче на мета-этапе | Да | Да | Нет |
| Число проходов на задачу | Два (adapt + meta) | Два | Один |
| Память | Высокая | Ниже | Низкая |
| Точность на few-shot бенчмарках | Референс | Близко к MAML | Сопоставимо |
По результатам оригинальной работы OpenAI на Omniglot и miniImageNet Reptile держится в тех же пределах, что MAML и FOMAML — разброс между алгоритмами обычно в пределах нескольких процентных пунктов и зависит от гиперпараметров сильнее, чем от выбора метода. Точные числа стоит смотреть в самой статье и её приложениях: они меняются от конфигурации к конфигурации, и подставлять «средние по памяти» проценты здесь нечестно.
Когда это применимо на практике
Мета-обучение — не универсальный ускоритель. Оно оправдано, когда у вас действительно много однотипных мелких задач, а не одна большая:
- распознавание новых категорий по нескольким примерам без полного переобучения;
- персонализация модели под пользователя, у которого мало данных;
- робототехника, где каждая новая обстановка — отдельная задача, а данные дороги;
- задачи, где важна не итоговая точность на фиксированном наборе, а скорость дообучения.
Если у вас одна крупная задача с обильными данными — обычное обучение или дообучение предобученной модели почти всегда проще и эффективнее. Стоит честно оценить цену вопроса: мета-обучение усложняет пайплайн, требует конструирования распределения задач и аккуратной настройки. Reptile снимает часть боли по сравнению с MAML, но не отменяет саму постановку.
Что важно при настройке
На результат сильно влияют: число внутренних шагов k, размер шага ε мета-обновления, размер батча задач и то, как именно вы нарезаете задачи из данных. Практический совет из работы — использовать не последнюю точку W, а взвешенную комбинацию промежуточных весов при вычислении направления обновления; это стабилизирует обучение.
1 Мета-обучение — обучение алгоритма обучению: модель оптимизируют не под конкретную задачу, а под способность быстро осваивать новые задачи из заданного класса.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: On First-Order Meta-Learning Algorithms (Nichol, Achiam, Schulman, OpenAI), Model-Agnostic Meta-Learning (Finn, Abbeel, Levine)
Частые вопросы
Чем Reptile принципиально отличается от MAML?
Reptile всегда точнее или всегда хуже MAML?
Что означает запись 5-way 1-shot?
Нужно ли мета-обучение, если у меня много данных?
Можно ли реализовать Reptile поверх любого оптимизатора?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.