Robust adversarial inputs: почему модель ломается от 4 пикселей
Изменение одного знака в изображении переворачивает предсказание нейросети. Разбираем, что такое устойчивые состязательные примеры, чем они опасны в проде и как их ловить.
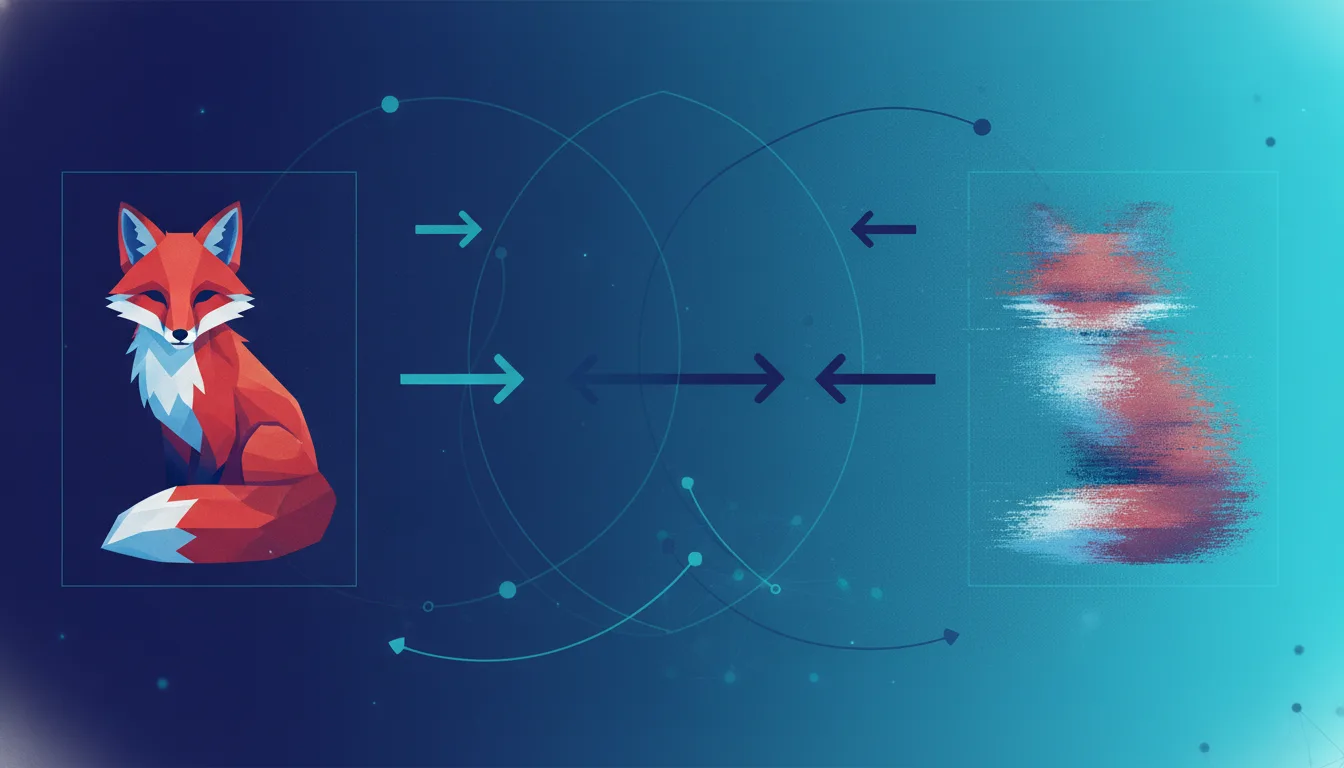
Ещё в 2014 году исследователи показали: прибавьте к фото панды почти невидимый глазу шум — и классификатор с уверенностью 99% назовёт её гиббоном. С тех пор атака стала практической проблемой. Наклейка на дорожный знак «стоп» заставляет модель компьютерного зрения читать его как ограничение скорости, а несколько символов в промпте обходят фильтры LLM. Речь не о редком лабораторном курьёзе: если ваша модель принимает решения на входных данных, которые контролирует посторонний, она уязвима.
Что такое состязательный пример
Состязательный пример (adversarial example) — это вход, специально подобранный так, чтобы модель выдала ошибочный результат, хотя для человека вход выглядит нормальным или почти неизменным. Ключевое слово — «подобранный»: атакующий не тычет наугад, а решает оптимизационную задачу. Он ищет минимальное возмущение δ, которое максимизирует ошибку модели при ограничении, что δ мал по выбранной норме (обычно L∞, L2 или L0).
Классический метод — FGSM*, один шаг по градиенту функции потерь. Более сильные — PGD (итеративный градиентный спуск с проекцией на допустимую окрестность) и C&W (оптимизация Карлини–Вагнера). Все они опираются на то, что модель дифференцируема, а её решающие границы в высокоразмерном пространстве проходят пугающе близко к реальным данным.
«Устойчивые» состязательные примеры — почему это отдельная тема
Обычный adversarial-пример хрупок: пересжали JPEG, чуть повернули картинку, распечатали и сфотографировали — и атака рассыпалась. Robust adversarial inputs (устойчивые состязательные входы) сохраняют вредоносный эффект после реальных преобразований: печати, изменения угла и освещения, ресайза, шумоподавления.
Их получают, оптимизируя возмущение не против одной картинки, а против распределения трансформаций. Метод Expectation over Transformation (EoT) усредняет градиент по случайным поворотам, масштабам и искажениям цвета. В результате наклейка на знаке или узор на 3D-объекте работает не под одним идеальным ракурсом, а под сотнями реальных.
Опасен не тот пример, что ломает модель на одном скриншоте. Опасен тот, что переживает камеру, компрессию и печать — и продолжает работать в физическом мире.
Где это бьёт по продукту
- Компьютерное зрение. Распознавание знаков, лиц, документов, модерация изображений. Устойчивый узор обходит фильтр даже после загрузки через мессенджер с пережатием.
- LLM и агенты. Prompt injection в тексте, который приходит из письма, веб-страницы или PDF. Инъекция переживает копирование и переформатирование.
- Антифрод и ML-скоринг. Подбор входных признаков, при котором мошенническая транзакция получает низкий риск-скор.
Виды атак: что нужно знать защите
Прежде чем строить оборону, разделите угрозы по тому, что доступно атакующему.
| Признак | White-box | Black-box |
|---|---|---|
| Доступ к весам и градиентам | Да | Нет |
| Как ищется возмущение | Прямой градиент (PGD, C&W) | Запросы к API, перенос с суррогатной модели |
| Стоимость атаки | Низкая, если веса утекли | Выше: тысячи запросов или обучение суррогата |
| Типичный сценарий | Open-source модель, инсайдер | Публичное API без rate-limit |
Отдельно стоит transferability: пример, собранный против одной модели, часто срабатывает против другой, обученной на похожих данных. Поэтому «мы не публикуем веса» не защищает — атакующий обучит суррогат и перенесёт атаку.
Как защищаться
Единой «таблетки» нет. Работает эшелонированная оборона, где каждый слой поднимает стоимость атаки.
- Adversarial training. Дообучение модели на состязательных примерах, сгенерированных PGD прямо в цикле обучения. Самый надёжный из известных методов, но дорогой: обучение замедляется в разы, а чистая точность обычно немного падает.
- Предобработка входа. Сжатие, случайный ресайз, размытие, квантование. Ломает хрупкие атаки, но против устойчивых (EoT их учитывает) помогает слабо. Использовать как дополнительный, а не единственный слой.
- Детекция аномалий. Отдельная модель или статистика, отмечающая входы, лежащие вне распределения обучающих данных. Не блокирует, но помечает подозрительное для ручной проверки.
- Ограничение поверхности. Rate-limit на API, отказ отдавать confidence-скор в явном виде, недифференцируемые звенья в пайплайне — всё это повышает стоимость black-box перебора.
- Сертифицированная устойчивость. Методы вроде randomized smoothing дают математическую гарантию: в радиусе ε вокруг входа предсказание не изменится. Гарантия честная, но радиус часто мал для практики.
Мини-пример: генерация PGD-возмущения
Смысл атаки на одном фрагменте — итеративный шаг по знаку градиента с проекцией обратно в ε-окрестность. Это иллюстрация принципа, не готовый инструмент.
import torch

def pgd_attack(model, x, y, eps=8/255, alpha=2/255, steps=10):
    x_adv = x.clone().detach()
    for _ in range(steps):
        x_adv.requires_grad_(True)
        loss = torch.nn.functional.cross_entropy(model(x_adv), y)
        grad = torch.autograd.grad(loss, x_adv)[0]
        x_adv = x_adv.detach() + alpha * grad.sign()
        # проекция в L-inf окрестность исходного x
        x_adv = torch.min(torch.max(x_adv, x - eps), x + eps)
        x_adv = x_adv.clamp(0, 1)
    return x_adv.detach()
Та же функция, обёрнутая в цикл обучения, превращается в adversarial training: генерируете x_adv на каждом батче и учите модель на нём.
Цена вопроса
Полная защита стоит дорого, а гарантии дают не все методы. Практичный подход — оценить, что теряется при успешной атаке. Если модель модерирует мемы, риск один. Если она допускает платежи или управляет физическим устройством — цена ошибки другая, и adversarial training с детекцией окупается. Начните с честной модели угроз: кто атакует, что у него есть на входе, сколько стоит один успешный обход.
* FGSM (Fast Gradient Sign Method) — простейшая атака: к входу прибавляется знак градиента функции потерь по входу, умноженный на малую константу. Один шаг, дёшево, но легко детектируется и слабо переносится.
Prompt-инженер: Идеальные запросы для Midjourney, ChatGPT и других моделей.
Спросить за 15 ₽Источники: Goodfellow et al., Explaining and Harnessing Adversarial Examples, Madry et al., Towards Deep Learning Models Resistant to Adversarial Attacks (PGD)
Частые вопросы
Спасает ли простое размытие или пережатие картинки на входе?
Если я не публикую веса модели, я в безопасности?
Adversarial training сильно портит обычную точность?
Существует ли математическая гарантия устойчивости?
Работают ли эти атаки против больших языковых моделей?
С чего начать защиту, если ресурсов мало?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.