Каскад сбоев: как ошибка одного агента ломает всю систему
Мультиагентные системы обещают автоматизировать сложные задачи, но одна галлюцинация в начале цепочки способна отравить весь результат. Разбираемся, как устроен каскад сбоев и чем его тушат.
Мультиагентные системы обещают автоматизировать сложные задачи, но одна галлюцинация в начале цепочки способна отравить весь результат. Разбираемся, как устроен каскад сбоев и чем его тушат.
Классический тест ждёт от функции один и тот же ответ на один и тот же вход. Агент на LLM выдаёт разные ответы, ходит в сеть и принимает решения сам. Разбираем, что здесь ломается и чем это чинить.

Один агент планирует, второй пишет код, третий проверяет — и все хотят ресурсов сразу. Разбираем механики, по которым мультиагентные системы решают, чью задачу выполнять первой.

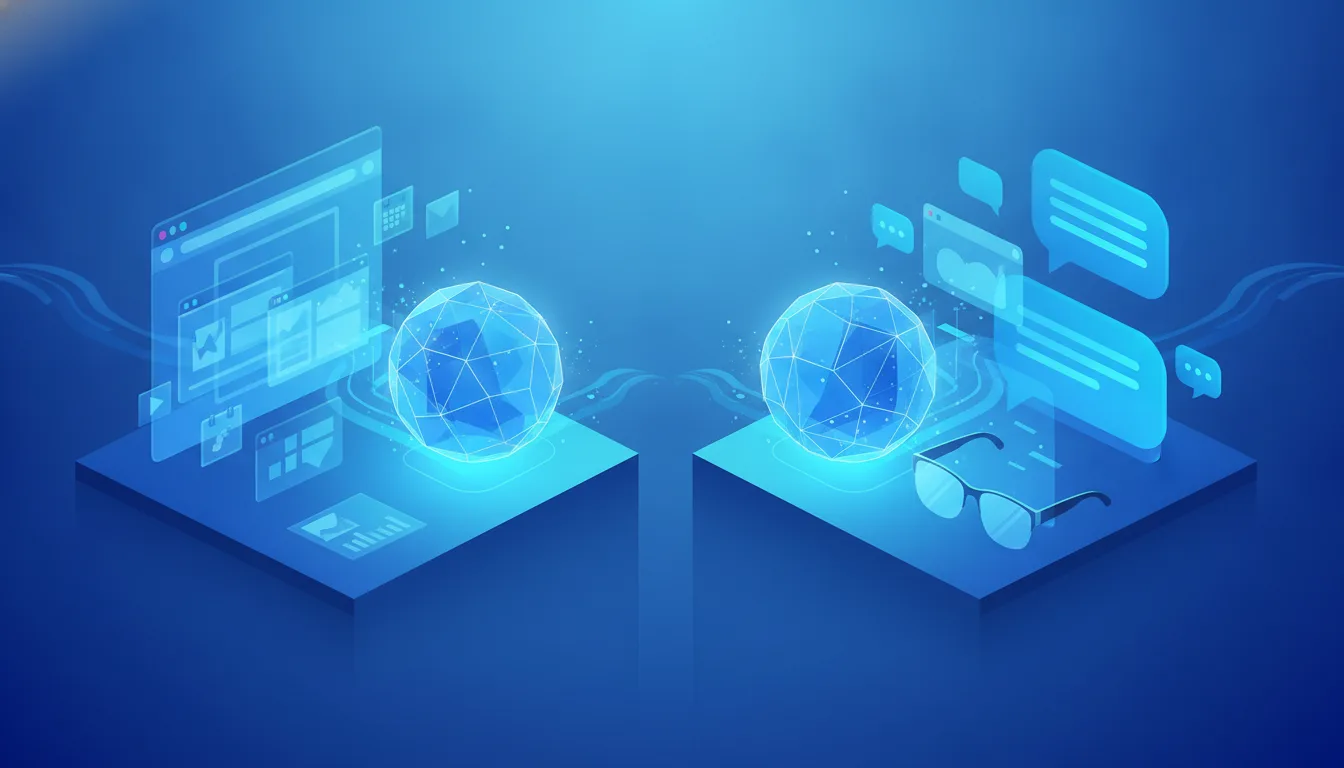
Google и Meta по-разному строят ИИ-агентов: одни идут через браузер и рабочие сервисы, другие — через мессенджеры и умные очки. Разбираем, кто на что ставит и что это меняет для пользователя.

Обе облачные платформы дают собрать агента с вызовом функций, RAG и памятью за пару часов. Но модель ценообразования, набор моделей и способ подключения инструментов у них разные — и это меняет цену эксплуатации.

Anthropic заявила, что её мультиагентная система тратит примерно в 15 раз больше токенов, чем один чат. Разбираем, когда рой агентов реально быстрее одиночки, а когда просто сжигает бюджет.

Один запрос к оркестратору из пяти агентов легко превращается в 40 секунд ожидания. Разбираем, откуда берётся латентность и как её резать без потери качества.

Мультиагентная система падает не там, где падает одиночный вызов LLM. Разбираем, что и как тестировать, когда агенты вызывают друг друга, инструменты и внешние API.

Один агент пишет ответ, второй его разносит и заставляет переделать. Схема «генератор плюс критик» снижает долю ошибок, но добавляет вызовов модели и денег — разбираем, когда это окупается.

Один чат с GPT-4o или Claude решает задачу линейно. Мультиагентные системы разбивают её между несколькими моделями-ролями — и иногда выигрывают в качестве, но платят токенами, задержкой и хрупкостью.

Агент от OpenAI, агент на Claude и локальная модель на vLLM должны работать в одном процессе. Разбираем протоколы, брокеры и код, который заставит их говорить на одном языке.

Один чат-бот уступает место связке из нескольких ИИ-агентов: один классифицирует запрос, второй ищет по базе, третий оформляет возврат. Разбираем, как это устроено и где ломается.