OpenAI Baselines: чем A2C отличается от ACKTR на практике
OpenAI выложила в набор Baselines две реализации policy-gradient алгоритмов — A2C и ACKTR. Первый проще и быстрее считает шаг, второй тратит больше на математику ради лучшей выборки данных.
OpenAI выложила в набор Baselines две реализации policy-gradient алгоритмов — A2C и ACKTR. Первый проще и быстрее считает шаг, второй тратит больше на математику ради лучшей выборки данных.
Обычные обучающиеся агенты в играх вроде «дилеммы заключённого» скатываются к взаимному предательству. LOLA — метод, где агент моделирует, как его действия меняют обучение оппонента, и это выводит систему к сотрудничеству.

Мета-обучение обещает роботам и алгоритмам умение осваивать новый борцовский приём за десятки повторов, а не за сотни тысяч. Разбираем, что за этим стоит и где заканчивается хайп.

Способность предсказывать намерения другого агента — старая задача из психологии, которую теперь решают внутри нейросетей. Разбираем, что такое машинная «теория разума» и где она уже ломается.

Сеть без единой функции активации по определению вычисляет только линейные функции входа. Но при обучении градиентным спуском она ведёт себя так, будто нелинейность у неё есть — и это ломает наивную интуицию.

Обучение через игру с собственными копиями вывело агентов на сверхчеловеческий уровень в го, шахматах и Dota 2. Разбираем, как работает self-play, где он ломается и сколько это стоит.

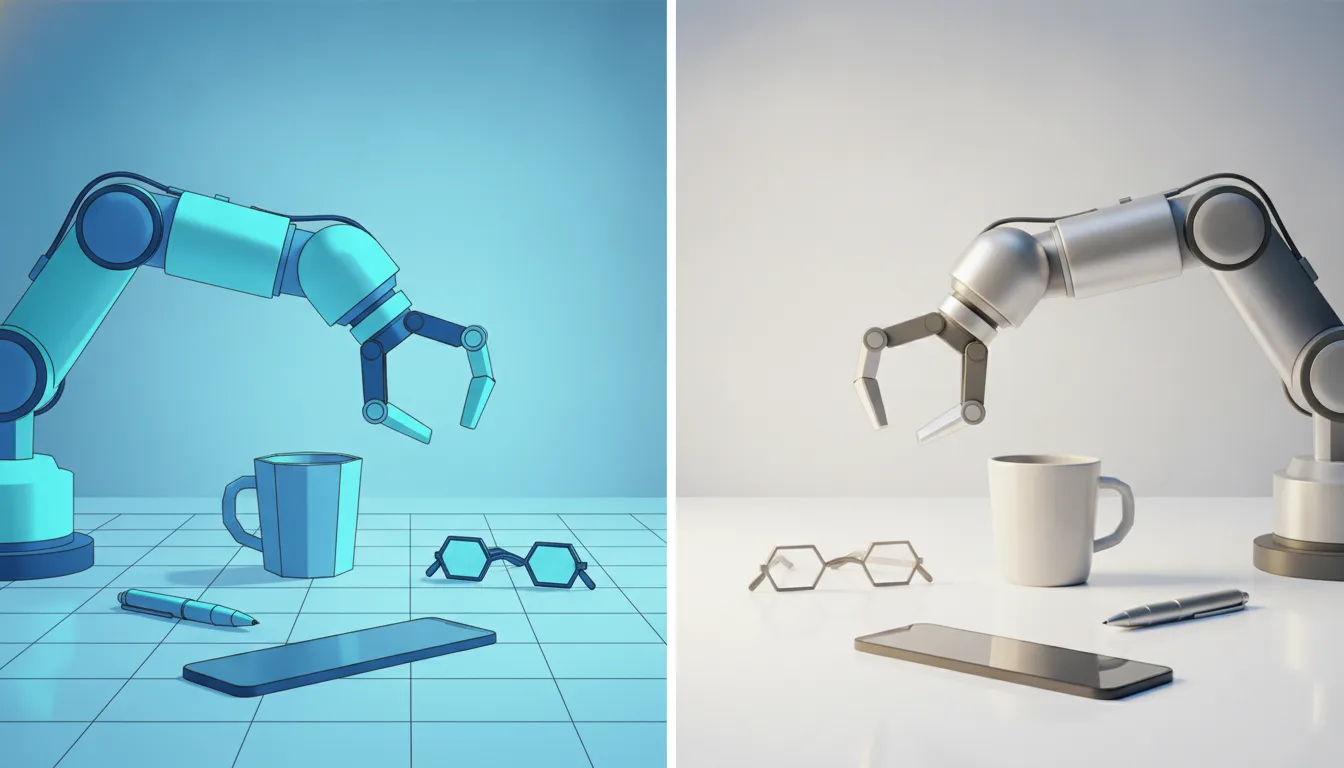
Робот, обученный в симуляторе, в реальности промахивается мимо кружки. Домен-рандомизация и генеративные модели закрывают этот разрыв — и меняют экономику обучения манипуляторов.

Робот на реальном железе видит только зашумлённые пиксели с камеры, а в симуляторе доступны точные координаты и скорости. Асимметричный actor-critic использует это неравенство данных, чтобы обучение сходилось быстрее.

Модель, обученная в идеальной физике симулятора, разваливается на реальном роботе за секунды. Domain randomization намеренно ломает симуляцию, чтобы политика выжила в реальном мире.

Робот учится в идеальной симуляции, а в реальном мире падает при первом же движении. Разбираем, почему возникает разрыв sim-to-real и какие приёмы его закрывают.

Иерархическое обучение — когда модель осваивает не одно длинное действие, а набор коротких навыков и учится их комбинировать. Разбираем, зачем это нужно и где ломается.

Модель, которая учит другую модель, часто генерирует примеры, понятные только машине. Идея интерпретируемых обучающих примеров заставляет учителя объяснять так, чтобы понял и человек.