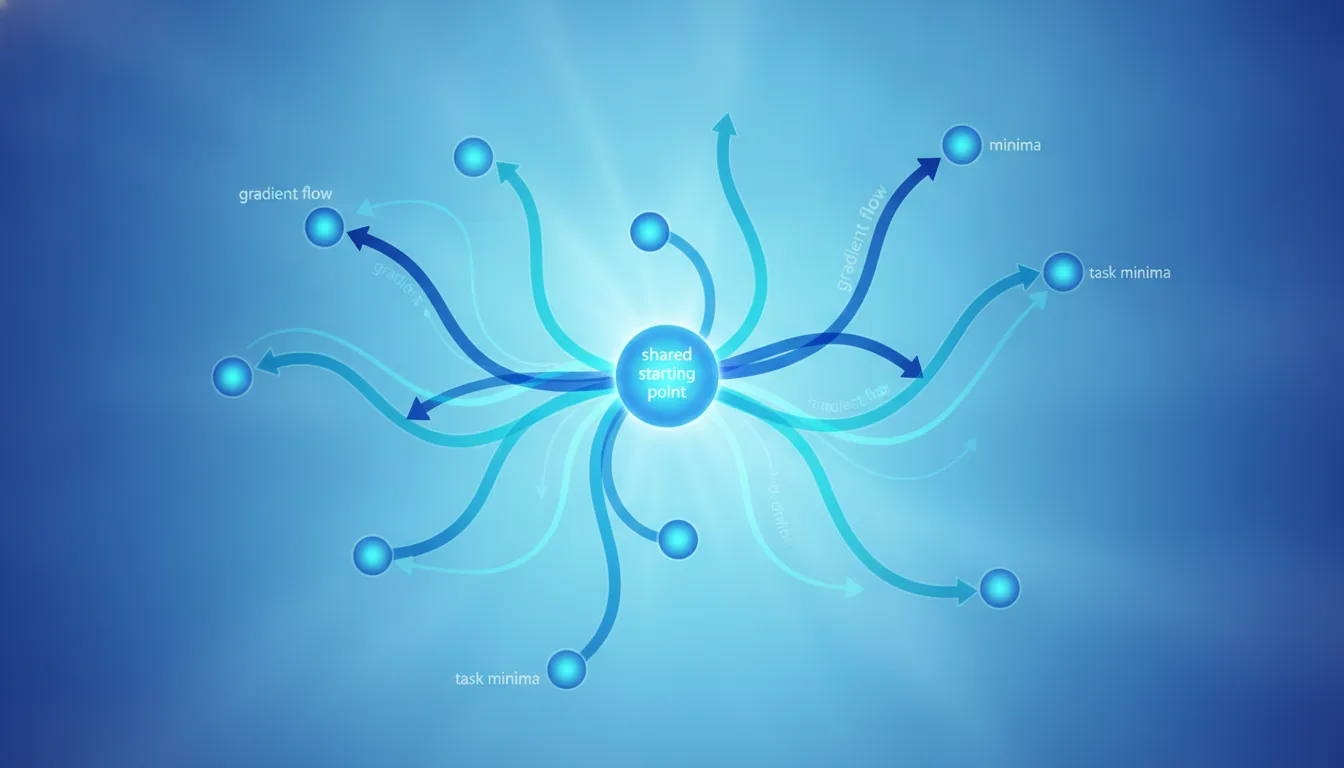
Reptile и MAML: как модели учатся учиться на новых задачах
Мета-обучение обещает модели, которая осваивает новую задачу за несколько примеров. Reptile от OpenAI делает это без вычисления вторых производных — и почти не проигрывает MAML.
Мета-обучение обещает модели, которая осваивает новую задачу за несколько примеров. Reptile от OpenAI делает это без вычисления вторых производных — и почти не проигрывает MAML.
Классические GAN обучаются на расхождении Йенсена-Шеннона и страдают от коллапса мод и нестабильности. Optimal transport меняет саму метрику между распределениями — и это лечит часть болезней сразу.

Соревнование OpenAI Retro Contest проверяло не то, кто пройдёт Sonic the Hedgehog, а кто пройдёт уровни, которых агент в глаза не видел. Именно на этом обычно и ломается обучение с подкреплением.

На хакатонах вокруг OpenAI API команды всё реже клепают чат-ботов и всё чаще собирают голосовых агентов, инструменты с function calling и связки из нескольких моделей. Разбираем, что там работает, а что ломается.

Action-dependent baselines обещали снизить дисперсию градиента политики в задачах с многомерным действием. Разбираем, откуда берётся выигрыш, почему часть его оказалась артефактом реализации и что делать на практике.

Агент, который прошёл 100 уровней Sonic, обычно проваливает 101-й. Бенчмарк Gotta Learn Fast разделил уровни на обучающие и тестовые, чтобы измерить не заучивание, а перенос навыка на новое.

OpenAI показала метод, где алгоритм обучения с подкреплением не задаётся вручную, а эволюционирует. Агент учится по функции потерь, которую подобрал внешний цикл — и переносит навык на задачи, которых не видел.

OpenAI, Google DeepMind и Anthropic вкладываются в идею, где две модели спорят перед судьёй, чтобы человек мог оценить ответ, который сам проверить уже не в силах.

Обучение фронтир-моделей упирается не в идеи, а в железо и электричество. Разбираем, из чего складывается счёт за компьют и почему GPU превратились в валюту гонки ИИ.

OpenAI запустила Fellows, чтобы переучивать инженеров и учёных из смежных областей в исследователей ИИ. Разбираем, как устроен набор осени 2018 года, кому он подходил и что осталось от идеи сегодня.

Исследователи предложили среду GamePad — обвязку вокруг Coq, где нейросеть учится доказывать теоремы шаг за шагом. Разбираем, как устроен подход и почему автодоказательство до сих пор упирается в данные.

Предобучение на неразмеченном тексте вытеснило подход, где каждую задачу тренировали отдельно на размеченных данных. Разбираем, почему это сработало и что это меняет на практике.