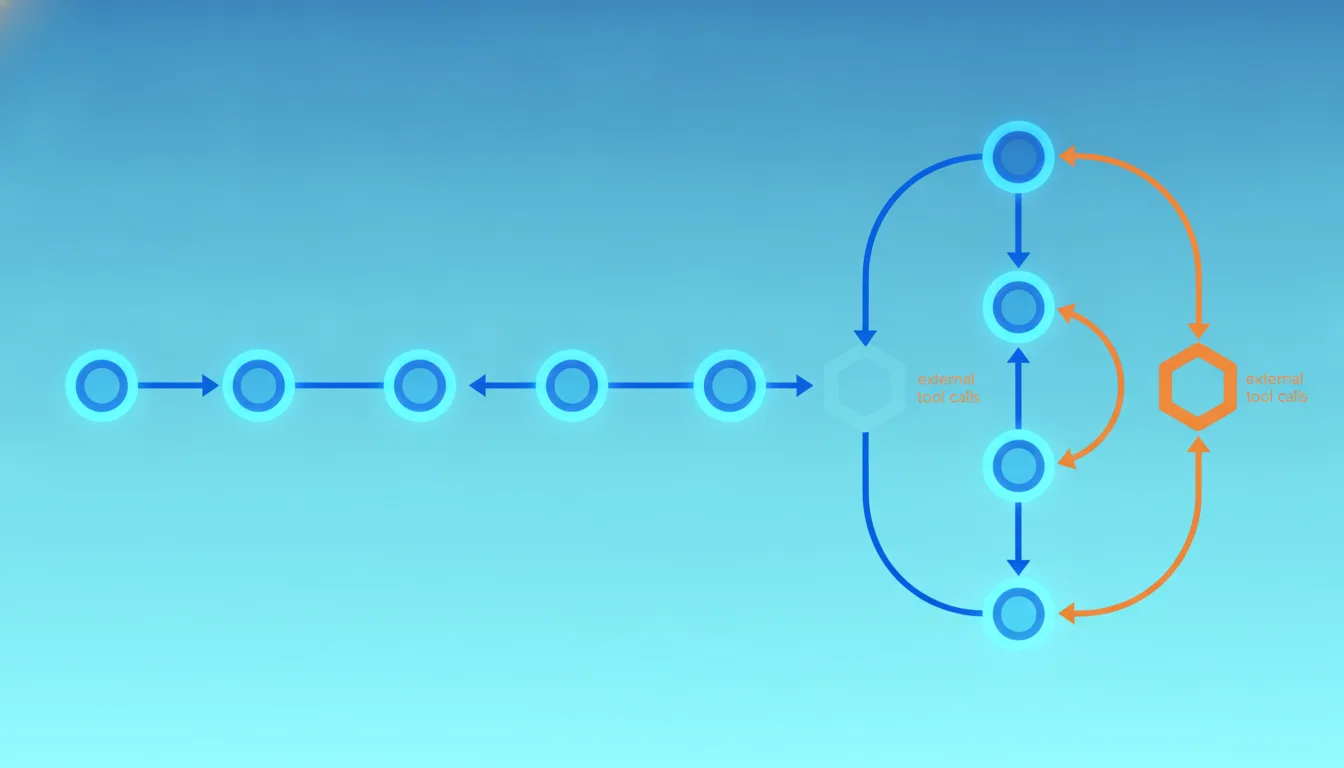
Цепочка агентов или оркестратор: чем платить за автономность
Два способа собрать многоагентную систему дают разную цену ошибки, разный расход токенов и разную отладку. Разбираем, где линейная цепочка проигрывает оркестратору и наоборот.
Два способа собрать многоагентную систему дают разную цену ошибки, разный расход токенов и разную отладку. Разбираем, где линейная цепочка проигрывает оркестратору и наоборот.
Apple Intelligence, Gemini Nano и Phi-3 переносят часть работы ИИ прямо на телефон. Разбираем, что реально работает на устройстве, а что всё ещё требует облака — и сколько это стоит в скорости, деньгах и приватности.

Автономный агент вызывает модель десятки раз за один запуск. На closed-source API это счёт в тысячи долларов в месяц, на self-hosted — расходы на GPU. Разбираем, где проходит граница выгоды.

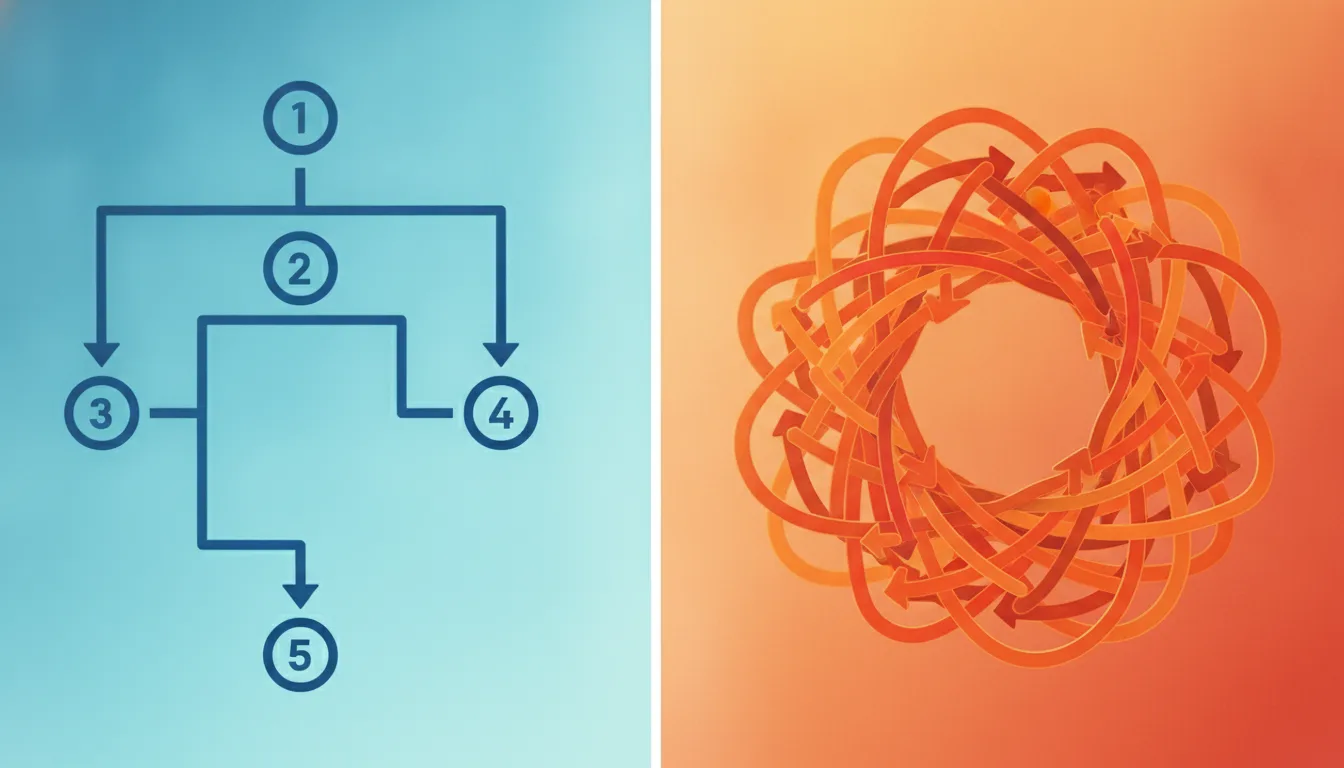
Одни ИИ-агенты сначала строят план из десятка шагов, другие действуют по одному вызову за раз. Разница определяет счёт за токены, скорость ответа и то, где всё сломается.

Chain-of-Thought заставляет модель рассуждать вслух, ReAct добавляет к рассуждениям вызовы инструментов. Разбираем, где заканчивается одно и начинается другое и что выбрать под задачу.

Разница между агентом с function calling и агентом на голых промптах — это не стиль кода, а разница между 95% и 60% успешных вызовов инструментов. Разбираем, где какой подход экономит деньги и нервы.

Одни агенты забывают вас после каждого запроса, другие помнят историю месяцами. Разбираем, где кончается удобство памяти и начинаются счета за токены и утечки данных.

Одни агенты умеют всё понемногу, другие — одно дело, но глубоко. Разбираем, чем горизонтальный ассистент отличается от вертикального и где проходит граница между хайпом и рабочим инструментом.

Одни инструменты подсказывают следующую строку, другие сами открывают терминал и правят репозиторий. Разница в цене ошибки, а не только в удобстве.

Классические rule-based системы предсказуемы и дёшевы, LLM-агенты гибки, но непредсказуемы и дороги. Разбираем, где проходит граница и как их совмещать в реальной архитектуре.

Anthropic хвалит мультиагентные системы, Cognition советует не собирать их без крайней нужды. Разбираемся, где несколько агентов оправданы, а где вы просто умножаете счёт за токены и баги.

Два инструмента обещают анализ данных без единой строки кода: загружаете таблицу, задаёте вопрос на русском — получаете графики и выводы. Разбираем, где Julius AI обходит встроенный анализатор ChatGPT, а где проигрывает.