Автономные агенты: почему они всё ещё требуют няньки
Демо показывают агентов, которые сами бронируют отели и пишут код. На практике задачи длиннее пары шагов рассыпаются: контекст теряется, ошибки копятся, счёт за токены растёт.
Демо показывают агентов, которые сами бронируют отели и пишут код. На практике задачи длиннее пары шагов рассыпаются: контекст теряется, ошибки копятся, счёт за токены растёт.
Продавцы обещают «полностью автономных агентов», но большинство продуктов на рынке застряло на уровне помощника с кнопкой подтверждения. Разбираем шкалу L0–L5 и то, за что вы платите на самом деле.

Слово «агент» приклеили ко всему подряд — от чат-бота до автозаполнения формы. Разбираем, что технически отличает агента от ассистента и почему за красивым ярлыком часто нет ни планирования, ни действий.

Стартапы продают «автономных агентов», которые сами закрывают задачи. На практике до цели без вмешательства человека доходит меньшинство запусков. Разбираем, где заканчивается маркетинг.

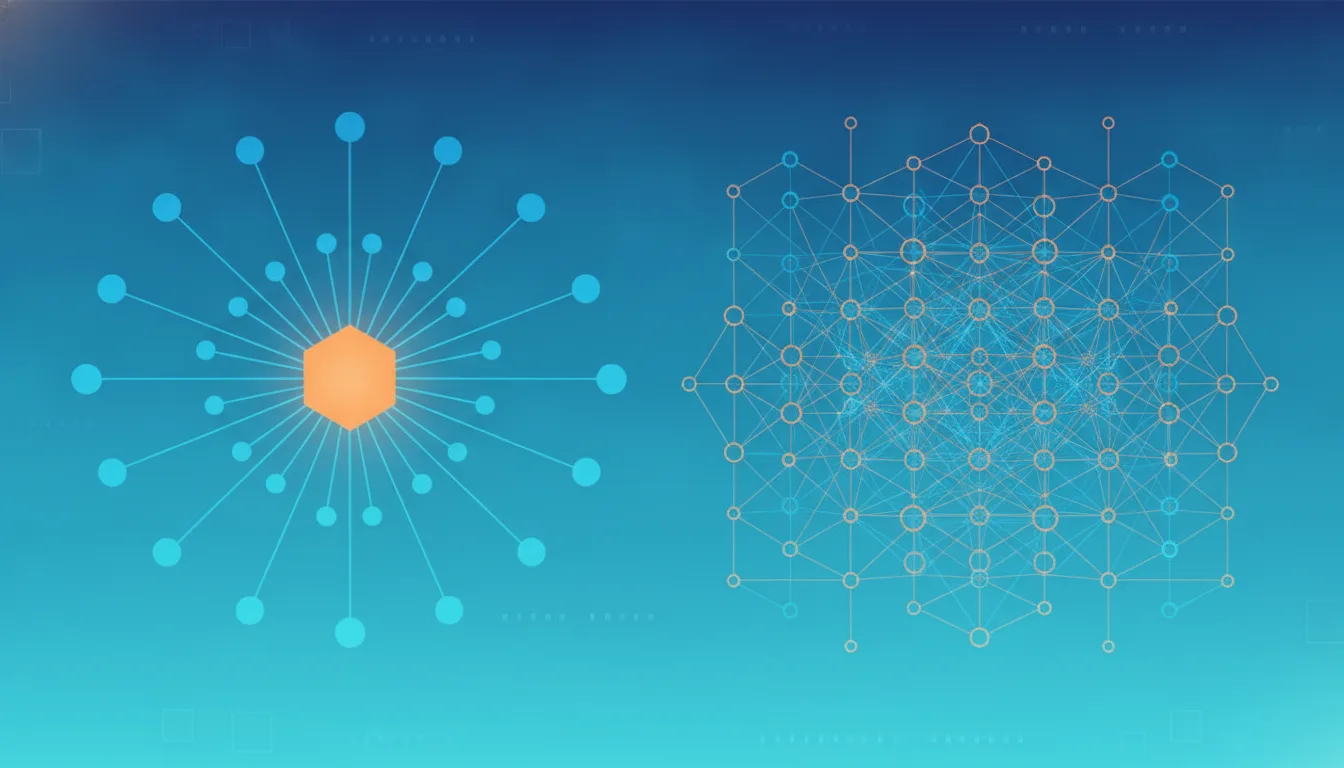
Два подхода к архитектуре мультиагентных систем: один диспетчер, который всё раздаёт, против сети агентов, договаривающихся напрямую. Где кто выигрывает по латентности, отладке и цене.

OpenAI прячет полную цепочку рассуждений o1 за суммаризацией, DeepSeek и Anthropic показывают её почти целиком. Для тех, кто строит агентов, это разница в отладке, счетах за токены и рисках.

Вместо одной модели, которая уверенно выдаёт неверный ответ, на задачу натравливают двух агентов, спорящих друг с другом. Идею проверяли в Anthropic, OpenAI и Google DeepMind — разбираем, где она работает, а где ломается.

Один прогон LLM или цикл, где агент проверяет и переделывает свой ответ. Reflexion давал прирост в разы на бенчмарках, но платите вы токенами и задержкой. Разбираем, где это оправдано.

Агент, который видит экран и слышит голос, решает задачи иначе, чем чат-бот, читающий только текст. Разбираем, где мультимодальность даёт выигрыш, а где добавляет задержку и счёт за токены.

Модель, которая умеет вызывать калькулятор и поиск, обгоняет ту, что считает в уме, на задачах с точными числами. Разбираем, где инструменты выигрывают, а где становятся лишним звеном и статьёй расходов.

Один и тот же вопрос: агент на GPT-4o без внешних данных отвечает по памяти на момент обучения, RAG-агент лезет в вашу базу и цитирует документ. Разбираем, где какой подход экономит деньги и репутацию.

LLM-агенты без памяти начинают каждую задачу с нуля и повторяют одни и те же ошибки. Эпизодическая память меняет расклад — но платить за неё приходится токенами, латентностью и новыми классами багов.