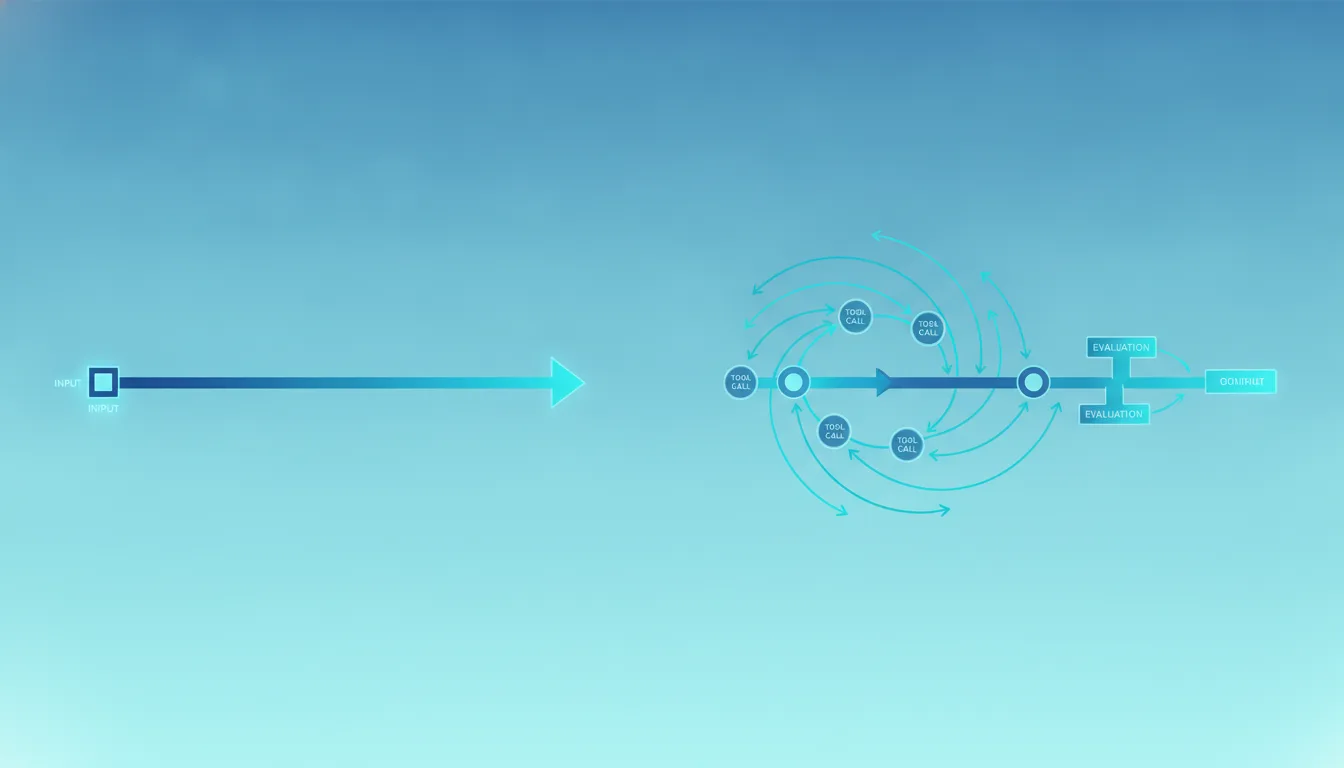
Single-turn против multi-turn: когда агенту нужна память
Один запрос-ответ или диалог с состоянием — от этого выбора зависит цена вызовов, задержка и надёжность агента. Разбираем, где multi-turn оправдан, а где сжигает бюджет впустую.
Один запрос-ответ или диалог с состоянием — от этого выбора зависит цена вызовов, задержка и надёжность агента. Разбираем, где multi-turn оправдан, а где сжигает бюджет впустую.
Контекстное окно у топовых моделей выросло до сотен тысяч и миллионов токенов, но агенты всё равно забывают, о чём вы говорили вчера. Разбираем, чем долгосрочная память отличается от большого контекста и когда за неё стоит платить.

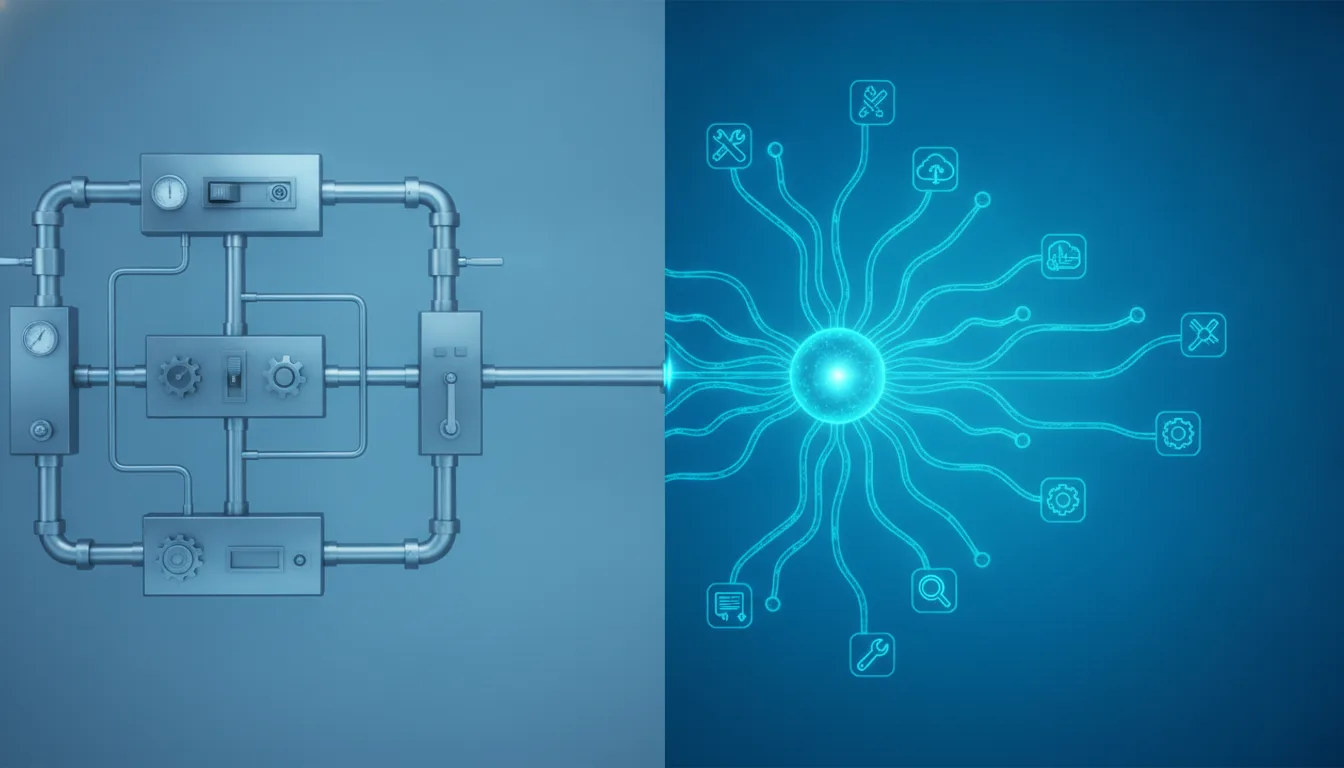
Старый сценарный бот отвечает по дереву заготовок и ломается на первом неожиданном вопросе. AI-агент рассуждает, вызывает инструменты и доводит задачу до конца. Разбираем, чем они отличаются на практике и сколько это стоит.

Один агент, который бронирует билеты, пишет код и разбирает почту, звучит заманчиво. Но на практике узкий агент под одну задачу чаще выигрывает по цене, скорости и предсказуемости. Разбираем, где проходит граница.

Один медленный вызов LLM в цикле может держать поток 20 секунд. Разбираем, когда агентный пайплайн стоит гонять синхронно, а когда переписать на async — с кодом на Python и ценой ошибки в задержке и деньгах.

Автономный агент экономит человеко-часы, пока не удаляет прод-базу или не одобряет возврат на 200 000 рублей. Разбираем, где ставить человека в цикл, а где отпускать вожжи.

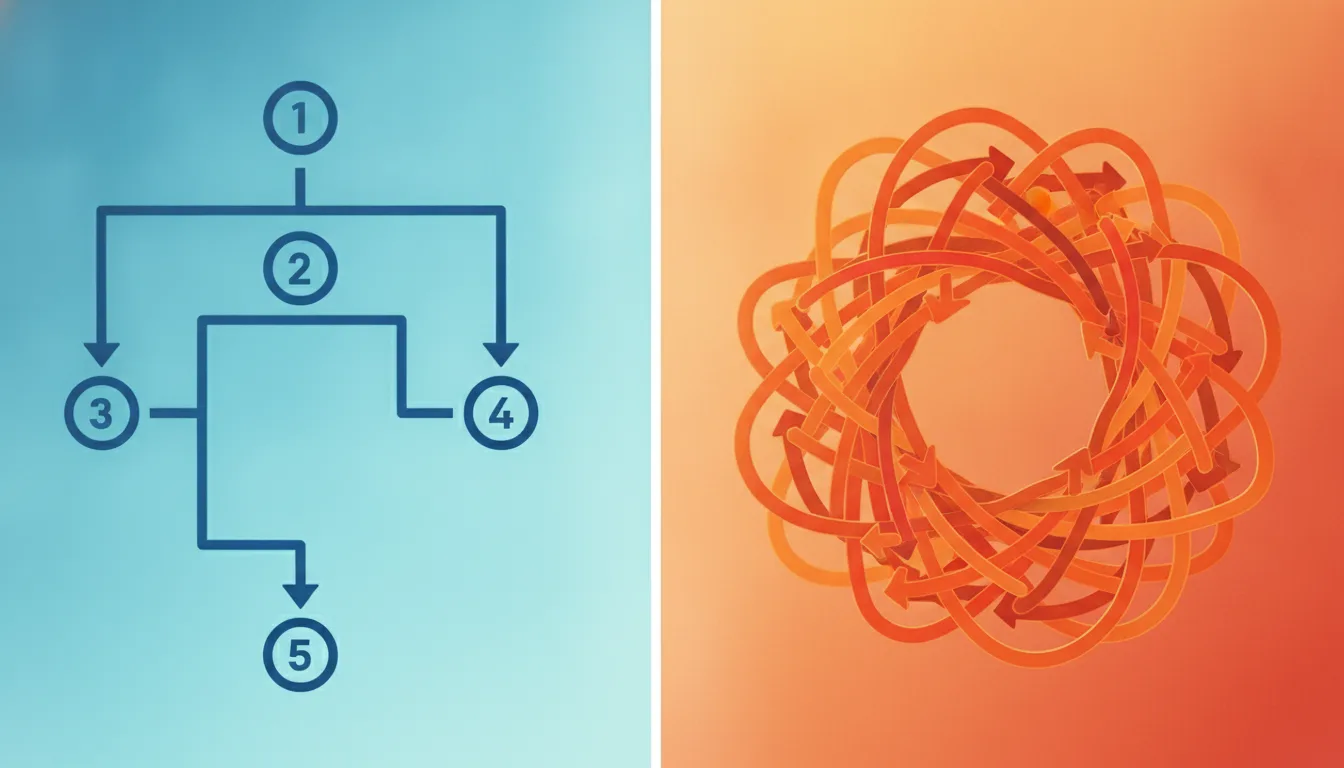
Рой равноправных агентов или строгая вертикаль с оркестратором — от архитектуры зависят стоимость токенов, надёжность и отладка. Разбираем, где какая схема выигрывает.

Два способа собрать многоагентную систему дают разную цену ошибки, разный расход токенов и разную отладку. Разбираем, где линейная цепочка проигрывает оркестратору и наоборот.

Apple Intelligence, Gemini Nano и Phi-3 переносят часть работы ИИ прямо на телефон. Разбираем, что реально работает на устройстве, а что всё ещё требует облака — и сколько это стоит в скорости, деньгах и приватности.

Автономный агент вызывает модель десятки раз за один запуск. На closed-source API это счёт в тысячи долларов в месяц, на self-hosted — расходы на GPU. Разбираем, где проходит граница выгоды.

Одни ИИ-агенты сначала строят план из десятка шагов, другие действуют по одному вызову за раз. Разница определяет счёт за токены, скорость ответа и то, где всё сломается.

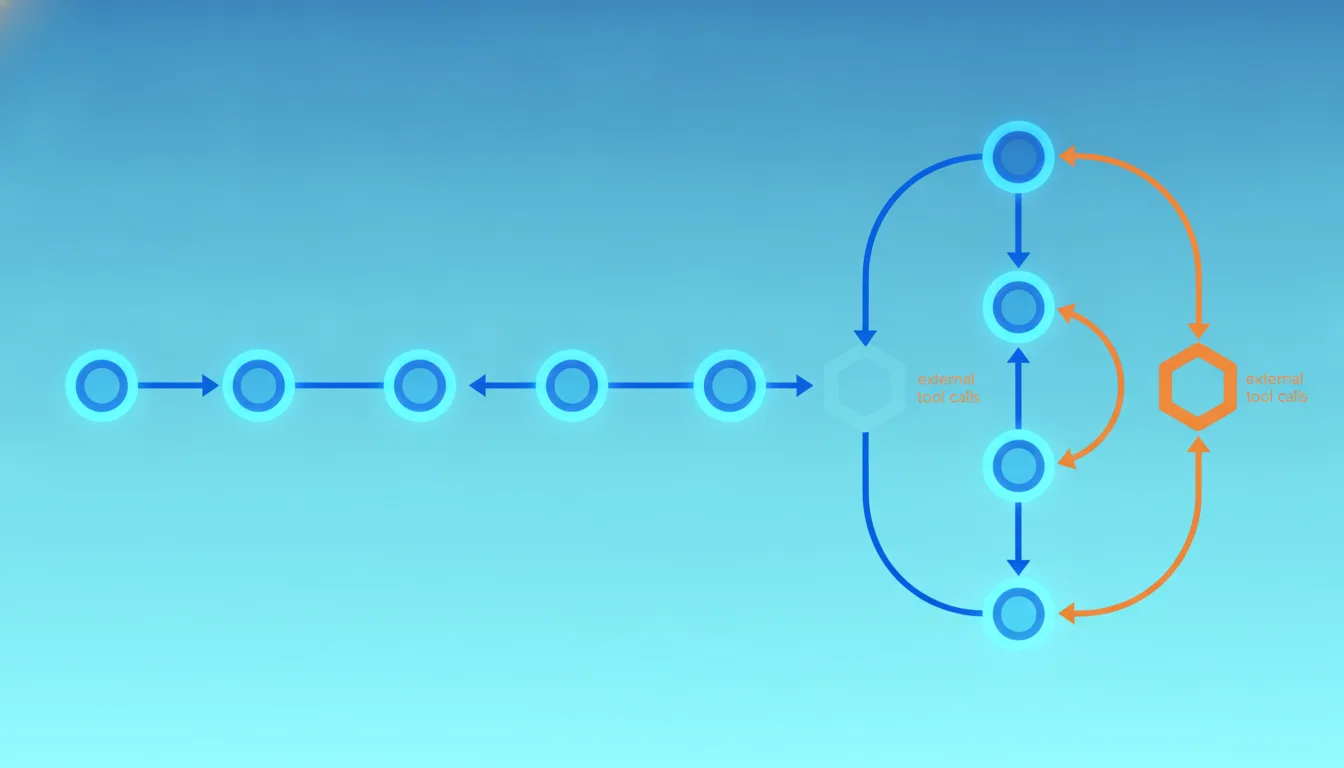
Chain-of-Thought заставляет модель рассуждать вслух, ReAct добавляет к рассуждениям вызовы инструментов. Разбираем, где заканчивается одно и начинается другое и что выбрать под задачу.