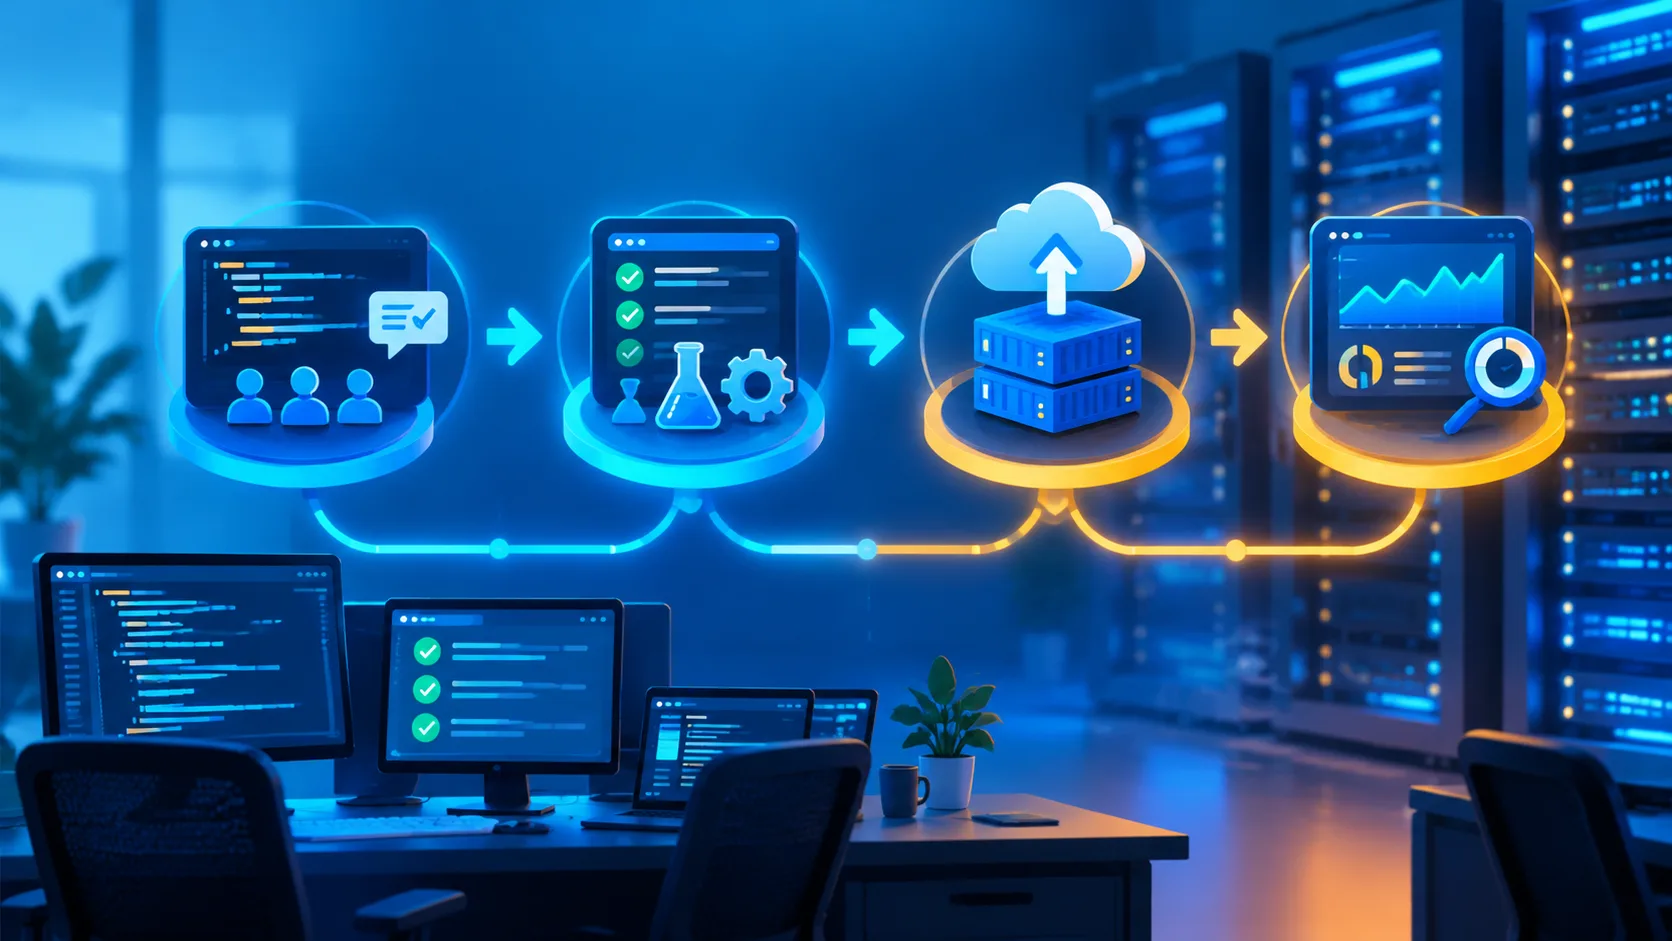
Автоматизация рутины в IT: что действительно окупается
Автоматизировать всё подряд — плохая инвестиция. Разбираем, как выбрать задачи с быстрым возвратом времени, посчитать окупаемость и не превратить CI/CD в ещё один источник ручной работы.
Автоматизировать всё подряд — плохая инвестиция. Разбираем, как выбрать задачи с быстрым возвратом времени, посчитать окупаемость и не превратить CI/CD в ещё один источник ручной работы.
Автоматизация экономит время, пока поток задач предсказуем. Под нагрузкой первыми обычно ломаются не скрипты, а очереди, повторы и ручная обработка ошибок. Разбираем, что измерять до запуска и где искать предел окупаемости.

В легаси-системе под нагрузкой первым падает не обязательно самый старый модуль. Обычно цепочка начинается с очереди запросов, пула соединений или внешнего сервиса. Разбираем, что измерять в первые недели и какие изменения не стоит вносить вслепую.

В легаси-проекте первые недели нужны не для героического переписывания, а для снижения неопределённости. Как собрать карту системы, выбрать безопасные изменения и не сломать прод, пока команда ещё не понимает его границ.

Перенос сайта на 1С-Битрикс обычно занимает от часа до рабочего дня: нужно скопировать файлы, выгрузить базу, повторить окружение и проверить домен, права, почту и фоновые задания.

Новый разработчик может запустить проект за час и всё равно неделю не понимать, где менять код и как безопасно выпустить релиз. Разбираем, как измерить онбординг до и после изменений, не подменяя результат красивой метрикой.

Разработчик получает задачу в незнакомом репозитории, запускает проект по README и упирается в ошибки, которые не воспроизводятся у команды. Разбираем, как такой сбой возникает и что проверить до первого изменения кода.

Первый pull request в незнакомом проекте часто превращается в спор о стиле и случайно ломает соседние сценарии. Разберём, как читать код, выбирать безопасный объём изменений и формулировать ревью так, чтобы команда быстрее приняла результат.

Кэш, увеличение таймаутов и новые реплики часто убирают симптом, но переносят отказ на следующий слой. Разбираем, как выбрать между быстрым исправлением и переделкой на примере API с PostgreSQL и Redis.

Быстрый патч помогает пережить инцидент, но может превратиться в постоянный источник сбоев. Разбираем критерии выбора, цену технического долга и способ принять решение без спора на вкусах.

ADR фиксирует не только выбранную технологию, но и причины решения, отклонённые альтернативы и последствия. Разбираем рабочий процесс: когда создавать запись, как писать её за час и что делать с устаревшими решениями.

После релиза оформление заказа стало занимать секунды вместо миллисекунд, а команда не смогла объяснить бизнесу цену исправления. Разбираем, как превратить техдолг из абстрактного риска в измеримый план работ.